41 Reducción de Dimensionalidad con PCA
Imagina dos sensores que registran casi el mismo movimiento. Si ambas lecturas suben y bajan juntas, dos columnas describen en gran parte una sola dirección. PCA gira los ejes para que el primero siga la mayor variación y el segundo recoja lo que queda. Las puntuaciones1 indican dónde queda cada observación sobre los nuevos ejes.
1 Puntuación (score): coordenada de una observación tras proyectarla sobre una componente principal. Los loadings son los pesos de las variables originales que definen esa dirección.
Ejemplo mínimo. Para las lecturas \((2,3)\), \((3,4)\) y \((4,5)\), al restar las medias \((3,4)\) obtenemos \((-1,-1)\), \((0,0)\) y \((1,1)\). Todos los puntos quedan sobre la diagonal: una sola coordenada basta para reconstruirlos. Más adelante calcularemos esa coordenada y la varianza que conserva.
TipAntes de reducir dimensiones en un proyecto
Define para qué usarás los componentes: visualizar, comprimir o alimentar un modelo. Si vas a evaluar predicción, separa primero entrenamiento y prueba; aprende el escalado y PCA solo en entrenamiento y mide el resultado en datos no vistos. La varianza explicada resume variación de las entradas, no rendimiento predictivo.
41.1 Ejemplo: dos sensores paso a paso
A continuación, calculamos el caso de los dos sensores de la intuición. Aquí solo centramos: ambas columnas tienen las mismas unidades y varianza. Así la matriz de covarianza y los autovalores de este ejemplo corresponden a los datos centrados; en el caso Iris posterior sí estandarizamos.
Definición de la matriz de datos original: Supongamos \(n=3\) observaciones (ej. mediciones de dos sensores) representados como filas y \(p=2\) variables representadas como columnas: \[X = \begin{pmatrix} 2 & 3 \\ 3 & 4 \\ 4 & 5 \end{pmatrix}\]
Centrado de los datos: Calculamos la media de cada columna: \(\bar{x}_1 = 3\) y \(\bar{x}_2 = 4\). Restamos la media a cada fila para obtener \(\tilde{X}\): \[\tilde{X} = \begin{pmatrix} 2-3 & 3-4 \\ 3-3 & 4-4 \\ 4-3 & 5-4 \end{pmatrix} = \begin{pmatrix} -1 & -1 \\ 0 & 0 \\ 1 & 1 \end{pmatrix}\]
Cálculo de la matriz de covarianza2 (\(S\)): Aplicamos \(S = \frac{1}{n-1} \tilde{X}^T \tilde{X}\) con \(n-1 = 2\): \[S = \frac{1}{2} \begin{pmatrix} -1 & 0 & 1 \\ -1 & 0 & 1 \end{pmatrix} \begin{pmatrix} -1 & -1 \\ 0 & 0 \\ 1 & 1 \end{pmatrix} = \frac{1}{2} \begin{pmatrix} 2 & 2 \\ 2 & 2 \end{pmatrix} = \begin{pmatrix} 1 & 1 \\ 1 & 1 \end{pmatrix}\]
Obtención de eigenvalores3 (\(\lambda\)): Resolvemos el determinante \(\det(S - \lambda I) = 0\): \[\det \begin{pmatrix} 1-\lambda & 1 \\ 1 & 1-\lambda \end{pmatrix} = (1-\lambda)^2 - 1 = 0 \implies \lambda^2 - 2\lambda = 0\] Los resultados son \(\lambda_1 = 2\) y \(\lambda_2 = 0\). La varianza total es \(2+0=2\). El primer componente explica el \(100\%\) de la varianza.
Obtención de eigenvectores (\(\mathbf{v}\)): Para \(\lambda_1 = 2\), resolvemos \((S - 2I)\mathbf{v}_1 = 0\): \[\begin{pmatrix} -1 & 1 \\ 1 & -1 \end{pmatrix} \begin{pmatrix} v_{11} \\ v_{21} \end{pmatrix} = 0 \implies v_{11} = v_{21}\] Normalizando para que \(\|v\|=1\): \(v_1 = \begin{pmatrix} 1/\sqrt{2} \\ 1/\sqrt{2} \end{pmatrix} \approx \begin{pmatrix} 0.707 \\ 0.707 \end{pmatrix}\).
Proyección de los datos (\(k=1\)): Transformamos los datos centrados a la nueva dimensión \(Z = \tilde{X} v_1\): \[Z = \begin{pmatrix} -1 & -1 \\ 0 & 0 \\ 1 & 1 \end{pmatrix} \begin{pmatrix} 0.707 \\ 0.707 \end{pmatrix} = \begin{pmatrix} -1.414 \\ 0 \\ 1.414 \end{pmatrix}\]
Conclusión: Dado que los datos originales estaban perfectamente alineados (\(x_2 = x_1 + 1\)), el PCA ha logrado reducir la dimensionalidad de 2 a 1 sin ninguna pérdida de información, capturando toda la estructura de los datos en un solo eje.
2 Covarianza muestral: \(s_{jk}=\frac{1}{n-1}\sum_i (x_{ij}-\bar x_j)(x_{ik}-\bar x_k)\). Es positiva cuando dos variables tienden a estar por encima (o por debajo) de su media a la vez. Dividir entre \(n-1\) en lugar de \(n\) corrige el sesgo que produce usar la media muestral en vez de la media poblacional desconocida (corrección de Bessel); para las direcciones de PCA el divisor es irrelevante, porque solo reescala todos los autovalores.
3 Autovalor o eigenvalor: número que indica cuánto estira una matriz una dirección propia. En PCA de la matriz de covarianza, equivale a la varianza capturada por la componente correspondiente.
41.1.1 Laboratorio: reproduce los seis pasos y rompe la alineación
Las gráficas siguientes no son imágenes precalculadas: el navegador ejecuta una implementación de PCA para dos variables (centrado, covarianza, autovalores por la fórmula cuadrática, autovectores y proyección) cada vez que cambias los datos. Empieza con los tres puntos del ejemplo y recorre los pasos; comprueba que cada número coincide con el desarrollo anterior.
Laboratorio 1 · PCA a mano, en el navegador
Dos sensores, seis pasos
Elige un paso. En las vistas de dispersión puedes arrastrar los puntos; los números y la gráfica se recalculan al instante.
Observaciones n
λ₁ (varianza en PC1)
λ₂ (varianza en PC2)
Varianza explicada PC1
Guía del laboratorio.
- Recorre los pasos 1 a 6 sin mover nada y comprueba cada número contra el desarrollo manual: \(\bar{\mathbf x}=(3,4)\), \(\operatorname{traza}(S)=2\), \(\det(S)=0\), \(\lambda_1=2\), \(\lambda_2=0\) y \(z=(-1.414,\,0,\,1.414)\).
- En el paso 5, arrastra P3 fuera de la diagonal. Antes de soltarlo, predice hacia dónde girará PC1 y si \(\lambda_2\) dejará de ser cero. Comprueba en el paso 6 que el error de reconstrucción coincide con \(\lambda_2\).
- Pulsa «Agregar punto» varias veces. Verifica en el paso 4 que \(\lambda_1+\lambda_2\) sigue igual a la traza, aunque la proporción explicada por PC1 cambie.
- Coloca dos puntos casi encima uno del otro y el tercero lejos. Explica, con la fórmula de la covarianza, por qué un solo punto alejado puede decidir la dirección de PC1; lo retomaremos en la sección de sensibilidad a outliers.
41.2 Motivación: la maldición de la dimensionalidad
Cuando el número de variables \(p\) crece y mantenemos fija la cantidad de observaciones, la geometría del espacio puede volverse contraintuitiva. La maldición de la dimensionalidad describe varios efectos de la alta dimensión, entre ellos la dispersión relativa de las observaciones al crecer el espacio disponible.
Consideremos una hiperesfera de radio \(r\) inscrita en un hipercubo de lado \(2r\) en \(\mathbb{R}^d\). La proporción del volumen de la esfera respecto al cubo es:
\[ \frac{V_{\text{esfera}}}{V_{\text{cubo}}} = \frac{\pi^{d/2} r^d}{\Gamma(d/2 + 1) \cdot (2r)^d} = \frac{\pi^{d/2}}{2^d \, \Gamma(d/2 + 1)} \]
En 2 y en 3 dimensiones, esta proporción es relativamente alta (~78% y ~52% respectivamente), como se puede apreciar en la siguiente visualización interactiva donde \(r=1\).
Sin embargo, esta proporción tiende a cero cuando \(d \to \infty\). Esto significa que la mayoría del volumen del hipercubo se concentra en las esquinas, y la esfera (que representa la región de interés) ocupa una fracción cada vez menor del espacio total.
Como ejemplo geométrico, si dividimos cada eje en \(L\) intervalos y queremos conservar la misma cantidad de observaciones por celda, el número de celdas crece como \(L^d\). No implica que todo problema real requiera exactamente esa cantidad de observaciones.
\[ n \sim \rho \cdot L^d \]
Con \(p = 20\) variables, el número de correlaciones posibles es \(\binom{20}{2} = 190\). Con \(p = 100\), son 4,950. Revisar e interpretar cada relación manualmente deja de ser practicable. Por ello necesitamos métodos que resuman la información sin perder lo esencial.
41.3 Fundamentos matemáticos del PCA
El Análisis de Componentes Principales transforma variables numéricas centradas en componentes ortogonales4 ordenadas por varianza. Entre todas las proyecciones lineales de dimensión \(k\), PCA maximiza la varianza proyectada y minimiza el error cuadrático de reconstrucción. Esa varianza puede incluir ruido y no garantiza conservar lo más útil para una tarea predictiva.
4 Ortogonal: dos direcciones perpendiculares cuyo producto interno es cero. En PCA, esto hace que las puntuaciones de componentes distintos no estén correlacionadas en el conjunto usado para ajustarlo.
41.3.1 Formulación Matemática y Procedimiento
Dado un conjunto de datos \(X \in \mathbb{R}^{n \times p}\), donde \(n\) es el número de muestras y \(p\) el número de variables, el proceso se rige por la siguiente secuencia lógica:
Estandarización y Centrado
Primero se centra cada variable. Se estandariza además cuando las unidades o dispersiones de las columnas harían que una domine por escala y el objetivo requiere tratarlas de forma comparable. Esto se realiza en dos pasos:
- Centrado: restar la media de cada variable
- Escalado: dividir entre su desviación estándar
De esta forma, cada variable transformada tiene media cero y varianza unitaria con la convención de varianza usada para escalarla. Si todas las medidas comparten unidades y la magnitud de la varianza es relevante, puede bastar el centrado.
\[ \tilde{X}_{ij} = \frac{X_{ij} - \mu_j}{\sigma_j} \]
donde:
- \(\mu_j\) es la media de la variable \(j\)
- \(\sigma_j\) es su desviación estándar
- Centrado: restar la media de cada variable
Cálculo de la Matriz de Covarianza: Se construye la matriz \(S\) (o \(\mathbf{C}\) dependiendo de la notación, \(\mathbf{C}\) es común en ML), que resume la variabilidad de cada variable y la relación entre ellas:
\[S = \frac{1}{n-1} \tilde{X}^T \tilde{X}\]
De forma elemento a elemento:
\[s_{jk} = \frac{1}{n-1} \sum_{i=1}^n \tilde{x}_{ij}\tilde{x}_{ik}\]
donde:
- \(s_{jj}\) representa la varianza de la variable \(j\)
- \(s_{jk}\) representa la covarianza entre las variables \(j\) y \(k\)
Esta matriz es simétrica y semidefinida positiva5, lo que garantiza que sus eigenvalores sean reales y no negativos.
Descomposición Espectral: Se resuelve el problema de autovalores para encontrar las direcciones principales: \[S \mathbf{v} = \lambda \mathbf{v}\] Aquí, \(\lambda\) representa los eigenvalores (la varianza explicada en esa dirección) y \(\mathbf{v}\) los eigenvectores (las direcciones o loadings).
Optimización y Ordenamiento: El primer componente principal \(w_1\) es el eigenvector asociado al eigenvalor máximo \(\lambda_1\). Los componentes siguientes se obtienen maximizando la varianza restante bajo la condición de ser ortogonales a los anteriores. Se clasifican de forma descendente: \(\lambda_1 \geq \lambda_2 \geq \cdots \geq \lambda_p\).
Proyección y Reducción: Finalmente, se proyectan los datos originales sobre el subespacio generado por los primeros \(k\) componentes: \[\mathbf{Z} = \tilde{X} \mathbf{V}_k\] Donde \(\mathbf{V}_k\) es la matriz que contiene los primeros \(k\) eigenvectores ordenados.
5 Matriz semidefinida positiva: matriz simétrica \(S\) tal que \(\mathbf{u}^T S\mathbf{u}\ge 0\) para todo vector \(\mathbf{u}\). Para una covarianza, \(\mathbf{u}^T S\mathbf{u}\) es la varianza de la combinación lineal \(\tilde X\mathbf{u}\), y una varianza nunca es negativa. Por eso sus autovalores son reales y no negativos.
Cada componente captura una parte de la variabilidad total de los datos, la cual equivale a la traza de la matriz de covarianza (\(\sum \lambda_j\)). La importancia de cada componente se mide a través de la Proporción de Varianza Explicada (PVE):
\[\text{PVE}_k = \frac{\lambda_k}{\sum_{j=1}^p \lambda_j}\]
Esto permite elegir una dimensión que conserve, por ejemplo, el 95% de la varianza de la matriz transformada usada en el ajuste. El umbral es una decisión de análisis, no una garantía de calidad del modelo.
41.3.2 Por qué autovectores: la formulación variacional
El cálculo anterior usó autovalores como una receta. La razón aparece al plantear PCA como un problema de optimización. Para una dirección unitaria \(\mathbf{u}\), las puntuaciones son \(\mathbf{z}=\tilde X\mathbf{u}\) y su varianza es
\[ \operatorname{Var}(\mathbf{z})=\frac{1}{n-1}\mathbf{u}^T\tilde X^T\tilde X\mathbf{u}=\mathbf{u}^T S\,\mathbf{u}. \]
Queremos la dirección de mayor varianza sin hacer trampa alargando el vector, así que imponemos \(\mathbf{u}^T\mathbf{u}=1\). Con un multiplicador de Lagrange6:
6 Multiplicadores de Lagrange: técnica para optimizar una función sujeta a una restricción de igualdad. Se suma la restricción multiplicada por una incógnita \(\lambda\) y se iguala a cero el gradiente respecto a todas las variables. En el óptimo, el gradiente del objetivo es paralelo al de la restricción.
\[ \mathcal{L}(\mathbf{u},\lambda)=\mathbf{u}^T S\mathbf{u}-\lambda(\mathbf{u}^T\mathbf{u}-1), \qquad \nabla_{\mathbf{u}}\mathcal{L}=2S\mathbf{u}-2\lambda\mathbf{u}=\mathbf{0} \;\Longrightarrow\; S\mathbf{u}=\lambda\mathbf{u}. \]
Los candidatos a óptimo son exactamente los autovectores de \(S\). Al multiplicar por \(\mathbf{u}^T\) obtenemos \(\mathbf{u}^T S\mathbf{u}=\lambda\): la varianza proyectada es el autovalor, así que el máximo se alcanza con el autovector de \(\lambda_1\). El cociente \(\mathbf{u}^T S\mathbf{u}/\mathbf{u}^T\mathbf{u}\) se llama cociente de Rayleigh.
Hay una segunda lectura. Para un punto centrado \(\tilde{\mathbf{x}}_i\), el teorema de Pitágoras separa su norma en la parte proyectada y el residuo perpendicular:
\[ \|\tilde{\mathbf{x}}_i\|^2=(\mathbf{u}^T\tilde{\mathbf{x}}_i)^2+\|\tilde{\mathbf{x}}_i-(\mathbf{u}^T\tilde{\mathbf{x}}_i)\,\mathbf{u}\|^2 . \]
Sumando sobre \(i\) y dividiendo entre \(n-1\): varianza total = varianza proyectada + error de reconstrucción. Como el lado izquierdo no depende de \(\mathbf{u}\), maximizar la varianza y minimizar el error son el mismo problema.
Laboratorio 2 · Cociente de Rayleigh
Gira la recta y busca la máxima varianza
Para cada dirección u(θ) = (cos θ, sen θ) el navegador calcula uᵀSu (varianza proyectada) y el error cuadrático de reconstrucción. Mueve θ antes de pulsar «Saltar a PC1».
Datos centrados y su proyección
datosrecta u(θ)residuos
Varianza proyectada y error según θ
uᵀSuerror de reconstrucciónvarianza total
Varianza proyectada
Error de reconstrucción
Suma (= traza de S)
Ángulo de PC1
Guía del laboratorio.
- Con correlación \(0.7\) y escala \(\times 1\), gira θ lentamente y anota el ángulo donde la curva naranja (\(\mathbf{u}^T S\mathbf{u}\)) alcanza su máximo y la morada (error) su mínimo. Pulsa «Saltar a PC1» para verificarlo. ¿Por qué el ángulo está cerca de 45°?
- Lleva la correlación a \(0\). Explica por qué la curva se vuelve casi plana y por qué PC1 deja de estar bien definido cuando \(\lambda_1\approx\lambda_2\).
- Con correlación \(0\), aumenta la escala de \(x_2\) a \(\times 3\). PC1 gira hacia el eje vertical sin que exista relación entre las variables: es el efecto de las unidades que motiva estandarizar antes de PCA.
41.4 PCA y la Descomposición en Valores Singulares (SVD)
En la práctica, en las paqueterías modernas PCA nunca se calcula mediante la eigendescomposición de \(S\) directamente (pueden ver el ejemplo de la documentación de scikitlearn). En cambio, se utiliza la Descomposición en Valores Singulares (SVD) de la matriz centrada \(\tilde{X}\), que es numéricamente más estable y eficiente.
Toda matriz \(\tilde{X} \in \mathbb{R}^{n \times p}\) admite la descomposición:
\[ \tilde{X} = U \Sigma V^T \]
donde:
- \(U \in \mathbb{R}^{n \times n}\): matriz ortogonal de vectores singulares izquierdos (columnas = eigenvectores de \(\tilde{X}\tilde{X}^T\))
- \(\Sigma \in \mathbb{R}^{n \times p}\): matriz diagonal de valores singulares \(\sigma_1 \geq \sigma_2 \geq \cdots \geq \sigma_{\min(n,p)} \geq 0\)
- \(V \in \mathbb{R}^{p \times p}\): matriz ortogonal de vectores singulares derechos (columnas = eigenvectores de \(\tilde{X}^T\tilde{X}\))
La relación entre SVD y PCA es directa:
\[ S = \frac{1}{n-1}\tilde{X}^T\tilde{X} = \frac{1}{n-1}(U\Sigma V^T)^T(U\Sigma V^T) = \frac{1}{n-1} V \Sigma^2 V^T \]
Por tanto:
- Las columnas de \(V\) son los eigenvectores de \(S\) (componentes principales)
- Los eigenvalores de \(S\) son \(\lambda_k = \sigma_k^2 / (n-1)\)
- Los scores (proyecciones) son \(Z = \tilde{X}V = U\Sigma\)
¿Por qué SVD y no eigendescomposición directa?
La eigendescomposición de \(S\) requiere calcular primero \(S = \tilde{X}^T\tilde{X}/(n-1)\), lo cual:
- Pierde precisión numérica: los números de condición se elevan al cuadrado. Si \(\tilde{X}\) tiene número de condición \(\kappa\), \(S\) tiene \(\kappa^2\).
- Es ineficiente cuando \(n \ll p\): la SVD puede trabajar directamente con la matrix de \(n \times p\) usando la thin SVD, evitando la costosa matriz \(p \times p\).
- El algoritmo de Golub-Reinsch para SVD es más estable numéricamente que los algoritmos de eigendescomposición para matrices no simétricas.
import numpy as np
from sklearn.preprocessing import StandardScaler
from sklearn.datasets import load_iris

X = load_iris().data
X_std = StandardScaler().fit_transform(X)

# Método 1: eigendescomposición de S
S = np.cov(X_std.T)
eigenvalues, eigenvectors = np.linalg.eigh(S)
# eigh ordena de menor a mayor, invertir
idx = np.argsort(eigenvalues)[::-1]
eigenvalues = eigenvalues[idx]
eigenvectors = eigenvectors[:, idx]

# Método 2: SVD directa sobre X_std
U, sigma, Vt = np.linalg.svd(X_std, full_matrices=False)
lambda_svd = sigma**2 / (len(X_std) - 1)

print("Eigenvalores via S:  ", np.round(eigenvalues, 6))
print("Eigenvalores via SVD:", np.round(lambda_svd, 6))
print("Son idénticos:", np.allclose(eigenvalues, lambda_svd))
Eigenvalores via S: [2.938085 0.920165 0.147742 0.020854]
Eigenvalores via SVD: [2.938085 0.920165 0.147742 0.020854]
Son idénticos: True41.5 Ejemplo práctico: Implementación paso a paso
41.5.1 Dataset: Iris
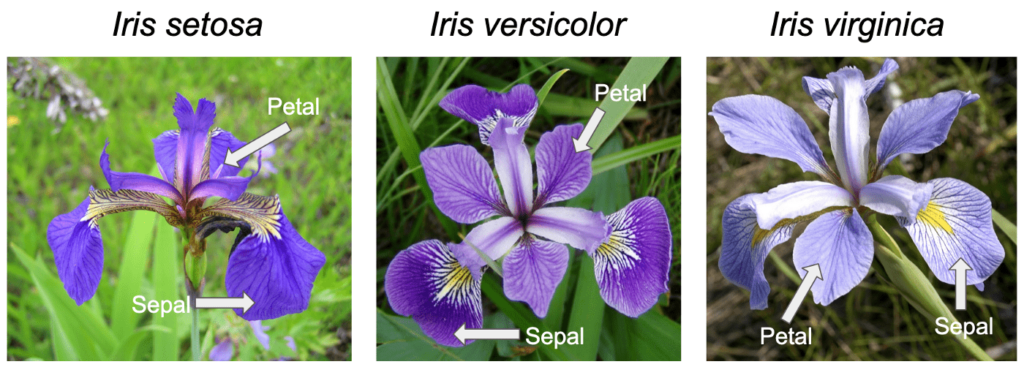
Para este ejemplousaremos Scikit-learn, mediante el clásico dataset Iris (flores de lirio de este lado del charco), que contiene mediciones de flores de tres especies (setosa, versicolor y virginica). Cada observación está descrita por cuatro variables numéricas:
- longitud del sépalo
- ancho del sépalo
- longitud del pétalo
- ancho del pétalo
Estas variables capturan características morfológicas de las flores y presentan correlaciones entre sí, lo que lo convierte en un ejemplo ideal para ilustrar cómo PCA identifica estructura y reduce dimensionalidad.
Código
iris = load_iris()
X = iris.data
y = iris.target
nombres = iris.target_names
feature_names = ['Sépalo largo', 'Sépalo ancho', 'Pétalo largo', 'Pétalo ancho']

df_iris = pd.DataFrame(X, columns=feature_names)
df_iris['Especie'] = [nombres[i] for i in y]
df_iris.describe().round(3)| Sépalo largo | Sépalo ancho | Pétalo largo | Pétalo ancho | |
|---|---|---|---|---|
| count | 150.000 | 150.000 | 150.000 | 150.000 |
| mean | 5.843 | 3.057 | 3.758 | 1.199 |
| std | 0.828 | 0.436 | 1.765 | 0.762 |
| min | 4.300 | 2.000 | 1.000 | 0.100 |
| 25% | 5.100 | 2.800 | 1.600 | 0.300 |
| 50% | 5.800 | 3.000 | 4.350 | 1.300 |
| 75% | 6.400 | 3.300 | 5.100 | 1.800 |
| max | 7.900 | 4.400 | 6.900 | 2.500 |
41.5.2 Estandarización
En Iris elegimos estandarizar para dar el mismo peso inicial a las cuatro medidas. Sin este paso, la variable con mayor varianza numérica influye más en las primeras componentes. La decisión depende de las unidades y de qué diferencias físicas interesa conservar.
\[ z_{ij} = \frac{x_{ij} - \bar{x}_j}{s_j} \]
Después de estandarizar: \(\bar{z}_j = 0\) y \(s_{z_j} = 1\) para toda variable \(j\).
Código
scaler = StandardScaler()
X_std = scaler.fit_transform(X)

# Verificar
df_check = pd.DataFrame({
    'Variable': feature_names,
    'Media original': X.mean(axis=0).round(3),
    'Desv original': X.std(axis=0).round(3),
    'Media estand.': X_std.mean(axis=0).round(10),
    'Desv estand.': X_std.std(axis=0).round(3)
})
df_check| Variable | Media original | Desv original | Media estand. | Desv estand. | |
|---|---|---|---|---|---|
| 0 | Sépalo largo | 5.843 | 0.825 | -0.0 | 1.0 |
| 1 | Sépalo ancho | 3.057 | 0.434 | -0.0 | 1.0 |
| 2 | Pétalo largo | 3.758 | 1.759 | -0.0 | 1.0 |
| 3 | Pétalo ancho | 1.199 | 0.760 | -0.0 | 1.0 |
41.5.3 Matriz de covarianza
Código
S = np.cov(X_std.T)

fig = go.Figure(data=go.Heatmap(
    z=S,
    x=feature_names,
    y=feature_names,
    colorscale='RdBu_r',
    zmid=0, zmin=-1, zmax=1,
    text=np.round(S, 3),
    texttemplate='%{text}',
    textfont=dict(size=13),
    hovertemplate='%{y} ↔ %{x}<br>cov = %{z:.3f}<extra></extra>',
    colorbar=dict(title='Covarianza')
))
fig.update_layout(
    title="Matriz de covarianza de datos estandarizados",
    height=420
)
fig.show()
Nota
Con StandardScaler, cada columna tiene varianza 1 calculada con divisor \(n\); np.cov usa \(n-1\). Por eso la diagonal aquí vale \(n/(n-1)\) y esta matriz es \(n/(n-1)\) veces la matriz de correlación de Pearson. El factor común conserva las direcciones principales.
41.5.4 Eigendescomposición vía SVD
Código
pca = PCA()
scores = pca.fit_transform(X_std)

eigenvalues = pca.explained_variance_
pve = pca.explained_variance_ratio_ * 100
pve_acum = np.cumsum(pve)

df_pca = pd.DataFrame({
    'Componente': [f'PC{i+1}' for i in range(len(eigenvalues))],
    'Eigenvalue (λ)': eigenvalues.round(4),
    '% Varianza': pve.round(2),
    '% Acumulado': pve_acum.round(2)
})
df_pca| Componente | Eigenvalue (λ) | % Varianza | % Acumulado | |
|---|---|---|---|---|
| 0 | PC1 | 2.9381 | 72.96 | 72.96 |
| 1 | PC2 | 0.9202 | 22.85 | 95.81 |
| 2 | PC3 | 0.1477 | 3.67 | 99.48 |
| 3 | PC4 | 0.0209 | 0.52 | 100.00 |
41.5.5 Scree plot
Código
fig = make_subplots(specs=[[{"secondary_y": True}]])

fig.add_trace(go.Bar(
    x=df_pca['Componente'], y=df_pca['% Varianza'],
    name='% Varianza',
    text=[f"{v:.1f}%" for v in pve],
    textposition='outside'
), secondary_y=False)

fig.add_trace(go.Scatter(
    x=df_pca['Componente'], y=pve_acum,
    mode='lines+markers',
    line=dict(width=2.5),
    marker=dict(size=9),
    name='% Acumulado'
), secondary_y=True)

fig.add_hline(y=80, line_dash="dash", line_color="gray",
              annotation_text="80%", secondary_y=True)

fig.update_yaxes(title_text="% Varianza por componente", secondary_y=False)
fig.update_yaxes(title_text="% Varianza acumulada", range=[0, 110], secondary_y=True)
fig.update_layout(
    title="Varianza explicada y acumulada por componente",
    height=380
)
fig.show()
Tip
Criterios para elegir \(k\):
- Regla de Kaiser: heurística de \(\lambda_k > 1\) para PCA sobre la matriz de correlaciones; la escala \(n/(n-1)\) del ejemplo exige cautela al usar el umbral literal.
- Varianza acumulada: fija un umbral según el costo de perder información y comprueba su impacto en la tarea; 80% o 90% son ejemplos, no reglas universales.
- Scree plot: buscar el “codo” donde la pendiente cae abruptamente
- Interpretabilidad de dominio: ¿los componentes tienen sentido en el problema?
41.5.6 Biplot
El biplot superpone los scores de las observaciones y los vectores de los loadings en el mismo espacio reducido, permitiendo interpretar simultáneamente la estructura de las observaciones y la contribución de las variables.
Código
loadings = pca.components_   # shape: (n_components, n_features)
scores_df = pd.DataFrame(scores[:, :2], columns=['PC1', 'PC2'])
scores_df['Especie'] = [nombres[i] for i in y]

fig = go.Figure()

# Scores
for especie in nombres:
    mask = scores_df['Especie'] == especie
    fig.add_trace(go.Scatter(
        x=scores_df.loc[mask, 'PC1'],
        y=scores_df.loc[mask, 'PC2'],
        mode='markers',
        marker=dict(size=7, opacity=0.7),
        name=especie
    ))

# Vectores de loadings escalados
escala = 3.0
for i, feat in enumerate(feature_names):
    fig.add_annotation(
        x=loadings[0, i] * escala,
        y=loadings[1, i] * escala,
        ax=0, ay=0,
        arrowhead=3, arrowwidth=2,
        xref='x', yref='y', axref='x', ayref='y',
        showarrow=True
    )
    fig.add_annotation(
        x=loadings[0, i] * escala * 1.15,
        y=loadings[1, i] * escala * 1.15,
        text=f"<b>{feat}</b>",
        showarrow=False,
        font=dict(size=11)
    )

fig.update_xaxes(title_text=f"PC1 ({pve[0]:.1f}%)",
                 zeroline=True, zerolinecolor='lightgray')
fig.update_yaxes(title_text=f"PC2 ({pve[1]:.1f}%)",
                 zeroline=True, zerolinecolor='lightgray',
                 scaleanchor='x')
fig.update_layout(
    title="Biplot: scores + loadings — Iris",
    height=480,
    legend=dict(title='Especie')
)
fig.show()
Interpretación del biplot:
Las flechas (loadings) representan los vectores de las variables proyectados sobre el nuevo sistema de coordenadas definido por los componentes principales. Es decir, cada flecha muestra cómo una variable original se expresa en la nueva base.
Flechas largas → la variable tiene gran proyección (norma) sobre ese plano, por lo que contribuye significativamente a la variabilidad capturada por los componentes.
Flechas apuntando en la misma dirección → sus vectores forman un ángulo pequeño, lo que indica alta correlación (producto punto positivo grande).
Flechas opuestas → correlación negativa.
Flechas ortogonales → variables no correlacionadas.La posición de los puntos corresponde a la proyección de las observaciones en el subespacio generado por los primeros componentes.
La separación entre grupos refleja qué tan bien este subespacio (de menor dimensión) preserva la estructura original de los datos.
En conjunto, el biplot muestra simultáneamente: - un cambio de base (álgebra lineal)
- y una proyección de los datos en un subespacio de menor dimensión
41.5.7 Loadings detallados
Código
df_loadings = pd.DataFrame(
    loadings[:2].T,
    index=feature_names,
    columns=['PC1', 'PC2']
).round(4)

fig = make_subplots(
    rows=1, cols=2,
    subplot_titles=[
        "<b>Componente Principal 1 (PC1)</b>",
        "<b>Componente Principal 2 (PC2)</b>"
    ]
)

# PC1
fig.add_trace(go.Bar(
    x=feature_names,
    y=loadings[0],
    text=[f"{v:.3f}" for v in loadings[0]],
    textposition='outside'
), row=1, col=1)

# PC2
fig.add_trace(go.Bar(
    x=feature_names,
    y=loadings[1],
    text=[f"{v:.3f}" for v in loadings[1]],
    textposition='outside'
), row=1, col=2)

# Ejes
for c in [1, 2]:
    fig.update_yaxes(
        range=[-1.1, 1.1],
        zeroline=True,
        zerolinecolor='lightgray',
        row=1, col=c
    )
    fig.update_xaxes(
        tickangle=-25,
        row=1, col=c
    )

# Hacer más visibles los títulos de subplots
for ann in fig['layout']['annotations']:
    ann['font'] = dict(size=14)

# Nota interpretativa
fig.update_layout(
    showlegend=False,
    height=420,
    annotations=list(fig.layout.annotations) + [
        dict(
            x=0.5, y=-0.2,
            xref='paper', yref='paper',
            text="PC1 ≈ tamaño general | PC2 ≈ contraste estructural del sépalo",
            showarrow=False,
            font=dict(size=12, color='gray'),
            xanchor='center'
        )
    ]
)

fig.show()
Interpretación de los loadings:
Cada componente principal es una combinación lineal de las variables originales. Es decir:
\[ \text{PC}_k = w_{1k} x_1 + w_{2k} x_2 + \cdots + w_{pk} x_p \]
donde los loadings \(w_{jk}\) indican el peso de cada variable en ese componente.
PC1 combina fuertemente pétalo largo, pétalo ancho y sépalo largo (coeficientes positivos similares), por lo que representa un eje de tamaño general de la flor. El sépalo ancho contribuye negativamente, ajustando ligeramente esa dirección.
PC2 está dominado por sépalo ancho, con poca contribución del resto, por lo que captura un contraste específico en la forma del sépalo.
En términos geométricos, cada componente define una dirección en el espacio original, y los loadings son las coordenadas de esa dirección en la base de variables originales.
41.6 Ejemplo avanzado: Dataset con ruido
El problema: una partícula en movimiento que no podemos ver directamente
Imagina que una partícula traza una trayectoria helicoidal en el espacio tridimensional. Nosotros no podemos observarla directamente — solo tenemos acceso a sensores, y cada sensor introduce su propio ruido de medición.
El desafío central es: dado un conjunto de lecturas ruidosas de múltiples sensores, ¿podemos recuperar la trayectoria original?
PCA puede resumir la variación compartida de las lecturas, pero no garantiza recuperar la trayectoria física exacta. Antes de aplicarlo, construyamos el experimento desde cero.
41.6.1 La trayectoria real y el ruido de medición
Generamos 500 puntos sobre una hélice paramétrica:
\[x(t) = t, \quad y(t) = \cos(t), \quad z(t) = \sin(t), \quad t \in [-10, 10]\]
Luego añadimos ruido gaussiano independiente en \(y\) y \(z\) para simular la imprecisión de los instrumentos de medida.
Código
n_points = 500
t = np.linspace(-10, 10, n_points)

# Trayectoria limpia
x_clean = t
y_clean = np.cos(t)
z_clean = np.sin(t)

# Observaciones ruidosas (lo que miden los sensores)
sigma = 0.5
y_noise = y_clean + np.random.normal(0, sigma, n_points)
z_noise = z_clean + np.random.normal(0, sigma, n_points)

points = np.column_stack([x_clean, y_noise, z_noise])

# ── Visualización ──────────────────────────────────────────
fig = go.Figure()

fig.add_trace(go.Scatter3d(
    x=points[:, 0], y=points[:, 1], z=points[:, 2],
    mode='markers',
    marker=dict(size=3, color='steelblue', opacity=0.5),
    name='Mediciones ruidosas'
))

fig.add_trace(go.Scatter3d(
    x=x_clean, y=y_clean, z=z_clean,
    mode='lines',
    line=dict(color='crimson', width=4),
    name='Trayectoria real'
))

fig.update_layout(
    title='Trayectoria helicoidal: señal real vs. mediciones ruidosas',
    scene=dict(
        xaxis_title='X', yaxis_title='Y', zaxis_title='Z',
        yaxis=dict(range=[-5, 5]),
        xaxis=dict(range=[-11, 11])
    ),
    legend=dict(x=0.01, y=0.99),
    height=520
)
fig.show()
Los puntos azules son lo que los sensores registran. La línea roja es la realidad que queremos recuperar. A simple vista ya es difícil distinguir la estructura subyacente del ruido.
41.6.2 Tres sensores, tres perspectivas distintas
En un experimento real, distintos sensores observan el mismo fenómeno desde ángulos diferentes. Cada sensor proyecta la nube de puntos sobre su propio plano de referencia y mide coordenadas locales \((u, v)\) en ese plano — más, inevitablemente, su propio ruido adicional.
Simulamos tres sensores con planos de proyección distintos.
Código
# ── Funciones auxiliares ────────────────────────────────────

def proyection(points, plane_point, plane_normal):
    """Proyecta cada punto sobre un plano definido por un punto y su normal."""
    n = plane_normal / np.linalg.norm(plane_normal)
    d = points - plane_point
    dist = d.dot(n)
    return points - np.outer(dist, n)


def plane_axes(plane_normal):
    """Devuelve dos vectores ortogonales que forman la base del plano."""
    n = plane_normal / np.linalg.norm(plane_normal)
    # Vector arbitrario no paralelo a n
    arb = np.array([1, 0, 0]) if abs(n[0]) < 0.9 else np.array([0, 1, 0])
    u = np.cross(n, arb)
    u /= np.linalg.norm(u)
    v = np.cross(n, u)
    v /= np.linalg.norm(v)
    return u, v


def sensor_reading(points, plane_point, plane_normal, noise_std=0.5):
    """
    Proyecta puntos sobre el plano del sensor y devuelve:
    - coordenadas 2D locales (s, t) con ruido adicional
    - la proyección 3D (para visualización)
    - los vectores de la base del plano (u, v)
    """
    proj_3d = proyection(points, plane_point, plane_normal)
    u, v = plane_axes(plane_normal)

    proj_vectors = proj_3d - plane_point
    s = proj_vectors.dot(u) + np.random.normal(0, noise_std, len(points))
    t = proj_vectors.dot(v) + np.random.normal(0, noise_std, len(points))

    return s, t, proj_3d, u, v


def plane_mesh(plane_point, plane_normal, size=12, res=20):
    """Genera una malla rectangular para visualizar el plano del sensor."""
    u, v = plane_axes(plane_normal)
    lin = np.linspace(-size, size, res)
    uu, vv = np.meshgrid(lin, lin)
    X = plane_point[0] + uu * u[0] + vv * v[0]
    Y = plane_point[1] + uu * u[1] + vv * v[1]
    Z = plane_point[2] + uu * u[2] + vv * v[2]
    return X, Y, Z
Código
# ── Definición de los tres sensores ────────────────────────
sensors = [
    dict(point=np.array([5., -6., 0.]),  normal=np.array([1., -1., 0.]),
         color='royalblue',  name='Sensor A'),
    dict(point=np.array([10., 0., 0.]),  normal=np.array([10., 0., 0.1]),
         color='seagreen',   name='Sensor B'),
    dict(point=np.array([3.,  3., 3.]),  normal=np.array([1.,  1., 1.]),
         color='darkorange', name='Sensor C'),
]

readings = []
for s in sensors:
    sc, tc, proj3d, u, v = sensor_reading(
        points, s['point'], s['normal'], noise_std=0.5
    )
    readings.append({'s': sc, 't': tc, 'proj3d': proj3d,
                     'u': u, 'v': v, **s})
Perspectiva 3D: sensores y sus proyecciones.
Código
fig = go.Figure()

# Trayectoria real
fig.add_trace(go.Scatter3d(
    x=x_clean, y=y_clean, z=z_clean,
    mode='lines', line=dict(color='crimson', width=4),
    name='Trayectoria real'
))

# Puntos originales
fig.add_trace(go.Scatter3d(
    x=points[:, 0], y=points[:, 1], z=points[:, 2],
    mode='markers', marker=dict(size=2, color='lightgray', opacity=0.4),
    name='Mediciones originales'
))

for r in readings:
    # Plano del sensor
    px_m, py_m, pz_m = plane_mesh(r['point'], r['normal'], size=10)
    fig.add_trace(go.Surface(
        x=px_m, y=py_m, z=pz_m,
        colorscale=[[0, r['color']], [1, r['color']]],
        opacity=0.15, showscale=False,
        name=f"Plano {r['name']}", showlegend=False
    ))
    # Proyección sobre el plano
    fig.add_trace(go.Scatter3d(
        x=r['proj3d'][:, 0], y=r['proj3d'][:, 1], z=r['proj3d'][:, 2],
        mode='markers', marker=dict(size=2.5, color=r['color'], opacity=0.7),
        name=r['name']
    ))

fig.update_layout(
    title='Los tres sensores proyectan la nube sobre sus planos respectivos',
    scene=dict(xaxis_title='X', yaxis_title='Y', zaxis_title='Z',
               xaxis=dict(range=[-12, 12]),
               yaxis=dict(range=[-8, 8])),
    legend=dict(x=0.01, y=0.99),
    height=560
)
fig.show()
Cada sensor “aplana” la nube sobre su propio plano. Ninguno captura la hélice perfectamente, pero cada uno aporta información parcial y complementaria.
Lo que registra cada sensor: coordenadas 2D.
Código
fig = make_subplots(
    rows=1, cols=3,
    subplot_titles=[r['name'] for r in readings],
    shared_yaxes=False
)

for i, r in enumerate(readings, 1):
    fig.add_trace(go.Scatter(
        x=r['s'], y=r['t'],
        mode='markers',
        marker=dict(size=3, color=r['color'], opacity=0.6),
        name=r['name'],
        showlegend=False
    ), row=1, col=i)
    fig.update_xaxes(title_text='u (eje 1 del plano)', row=1, col=i,
                     zeroline=True, zerolinecolor='lightgray')
    fig.update_yaxes(title_text='v (eje 2 del plano)' if i == 1 else '',
                     row=1, col=i,
                     zeroline=True, zerolinecolor='lightgray')

fig.update_layout(
    title='Lecturas brutas de cada sensor (coordenadas 2D locales)',
    height=400
)
fig.show()
Cada sensor produce una imagen 2D distorsionada de la misma hélice. El sensor A la ve casi como una elipse, el B como una banda horizontal, el C como una nube más compacta. Ninguno por sí solo revela la hélice original.
41.6.3 Construir la matriz de datos multi-sensor
Apilamos las seis coordenadas (2 por cada sensor) para formar una matriz de datos \(X \in \mathbb{R}^{500 \times 6}\). Cada fila es una muestra; cada columna es una variable medida por algún sensor.
Esta es exactamente la estructura con la que trabaja PCA: muchas variables correlacionadas que comparten una estructura latente de baja dimensión.
Código
# Matriz de datos: 500 muestras × 6 variables (2 por sensor)
data_matrix = np.column_stack([r['s'] for r in readings] +
                               [r['t'] for r in readings])
# Reordenamos: s_A, t_A, s_B, t_B, s_C, t_C
data_matrix = np.column_stack([
    readings[0]['s'], readings[0]['t'],
    readings[1]['s'], readings[1]['t'],
    readings[2]['s'], readings[2]['t'],
])

col_labels = ['A_u', 'A_v', 'B_u', 'B_v', 'C_u', 'C_v']

print(f"Dimensión de la matriz de datos: {data_matrix.shape}")
print(f"Variables: {col_labels}")
Dimensión de la matriz de datos: (500, 6)
Variables: ['A_u', 'A_v', 'B_u', 'B_v', 'C_u', 'C_v']Matriz de correlación entre sensores.
Código
corr = np.corrcoef(data_matrix.T)

fig = go.Figure(data=go.Heatmap(
    z=corr,
    x=col_labels, y=col_labels,
    colorscale='RdBu_r',
    zmid=0, zmin=-1, zmax=1,
    text=np.round(corr, 2),
    texttemplate='%{text}',
    textfont=dict(size=11),
    colorbar=dict(title='Correlación')
))

fig.update_layout(
    title='Correlación entre las 6 variables medidas por los sensores',
    height=420
)
fig.show()
La matriz de correlación revela la redundancia. Variables del mismo sensor están fuertemente correlacionadas entre sí, y también con variables de otros sensores — evidencia de que todas miden el mismo fenómeno subyacente. PCA explotará precisamente esa redundancia.
41.6.4 Aplicar PCA: ¿cuánta información hay realmente?
PCA descompone la varianza total en componentes ortogonales ordenados por importancia. Si el fenómeno real vive en pocas dimensiones, la mayor parte de la varianza se concentrará en los primeros componentes.
Código
pca_full = PCA(n_components=6)
components_full = pca_full.fit_transform(data_matrix)

explained = pca_full.explained_variance_ratio_
cumulative = np.cumsum(explained)

# ── Scree plot ──────────────────────────────────────────────
fig = make_subplots(specs=[[{"secondary_y": True}]])

fig.add_trace(go.Bar(
    x=[f'PC{i+1}' for i in range(6)],
    y=explained * 100,
    name='% Varianza individual',
    text=[f'{v*100:.1f}%' for v in explained],
    textposition='outside',
    marker_color='steelblue'
), secondary_y=False)

fig.add_trace(go.Scatter(
    x=[f'PC{i+1}' for i in range(6)],
    y=cumulative * 100,
    mode='lines+markers',
    name='% Acumulado',
    line=dict(color='crimson', width=2.5),
    marker=dict(size=9)
), secondary_y=True)

fig.add_hline(y=90, line_dash='dash', line_color='gray',
              annotation_text='90%', secondary_y=True)

fig.update_yaxes(title_text='% Varianza por componente', secondary_y=False)
fig.update_yaxes(title_text='% Varianza acumulada', range=[0, 110],
                 secondary_y=True)
fig.update_layout(
    title='Scree plot: ¿cuántos componentes capturan la señal?',
    height=400
)
fig.show()

print("Varianza explicada por componente:")
for i, (v, c) in enumerate(zip(explained, cumulative)):
    print(f"  PC{i+1}: {v*100:5.1f}%   acumulado: {c*100:5.1f}%")
Varianza explicada por componente:
PC1: 89.0% acumulado: 89.0%
PC2: 5.3% acumulado: 94.2%
PC3: 4.1% acumulado: 98.3%
PC4: 0.6% acumulado: 98.9%
PC5: 0.6% acumulado: 99.5%
PC6: 0.5% acumulado: 100.0%Los primeros 2–3 componentes concentran la gran mayoría de la varianza. Esto confirma lo que esperábamos: el sistema tiene 2 grados de libertad reales (la hélice es una curva en 3D, parametrizada por un solo parámetro \(t\)), y el resto es ruido.
41.6.5 Proyección en 2D: la hélice emerge del ruido
Con solo los dos primeros componentes principales recuperamos la estructura esencial del movimiento.
Código
pca_2d = PCA(n_components=2)
proj_2d = pca_2d.fit_transform(data_matrix)

# Línea de referencia: sin(t) proyectada para comparación
t_ref = np.linspace(-12, 12, 300)
ref_x = t_ref / t_ref.max() * proj_2d[:, 0].max()

fig = go.Figure()

fig.add_trace(go.Scatter(
    x=proj_2d[:, 0], y=proj_2d[:, 1],
    mode='markers',
    marker=dict(size=4, color='steelblue', opacity=0.6),
    name='Muestras (PC1 vs PC2)'
))

# Colorear por el parámetro t para mostrar la continuidad
fig.add_trace(go.Scatter(
    x=proj_2d[:, 0], y=proj_2d[:, 1],
    mode='markers',
    marker=dict(
        size=4, opacity=0.8,
        color=t,
        colorscale='Viridis',
        colorbar=dict(title='t (tiempo)', len=0.6)
    ),
    name='Coloreado por t'
))

fig.update_xaxes(title_text='Componente Principal 1',
                 zeroline=True, zerolinecolor='lightgray')
fig.update_yaxes(title_text='Componente Principal 2',
                 zeroline=True, zerolinecolor='lightgray',
                 scaleanchor='x')
fig.update_layout(
    title=f'PC1 vs PC2 — {pca_2d.explained_variance_ratio_.sum()*100:.1f}% de la varianza total',
    height=480
)
fig.show()
Al colorear los puntos por el parámetro \(t\) (el “tiempo” de la trayectoria), vemos que el orden temporal se preserva perfectamente: PCA ha recuperado la parametrización natural de la hélice a partir de seis variables ruidosas.
41.6.6 Proyección en 3D: confirmando la estructura helicoidal
Agregando el tercer componente recuperamos la geometría completa.
Código
pca_3d = PCA(n_components=3)
proj_3d = pca_3d.fit_transform(data_matrix)

fig = go.Figure()

# Muestras coloreadas por t
fig.add_trace(go.Scatter3d(
    x=proj_3d[:, 0], y=proj_3d[:, 1], z=proj_3d[:, 2],
    mode='markers',
    marker=dict(
        size=3, opacity=0.7,
        color=t,
        colorscale='Viridis',
        colorbar=dict(title='t', len=0.5)
    ),
    name='Muestras'
))

# Trayectoria original reescalada para superposición visual
scale = proj_3d[:, 0].std() / x_clean.std()
fig.add_trace(go.Scatter3d(
    x=x_clean * scale,
    y=y_clean * proj_3d[:, 1].std(),
    z=z_clean * proj_3d[:, 2].std(),
    mode='lines',
    line=dict(color='crimson', width=4),
    name='Trayectoria original (reescalada)'
))

fig.update_layout(
    title=f'Proyección 3D — {pca_3d.explained_variance_ratio_.sum()*100:.1f}% de la varianza total',
    scene=dict(
        xaxis_title='PC 1',
        yaxis_title='PC 2',
        zaxis_title='PC 3',
        xaxis=dict(range=[-15, 15]),
        yaxis=dict(range=[-7, 7]),
        zaxis=dict(range=[-7, 7])
    ),
    legend=dict(x=0.01, y=0.99),
    height=560
)
fig.show()
La nube de puntos reconstruida en el espacio PCA sigue fielmente la hélice original. PCA ha separado la señal del ruido sin conocer a priori la geometría de la trayectoria.
NotaLa idea central
PCA no sabe nada sobre hélices ni sobre física. Solo busca las direcciones de máxima varianza en los datos. El hecho de que esas direcciones coincidan con la geometría real de la trayectoria es una consecuencia de que la señal real tiene más varianza que el ruido.
Cuando \(\text{SNR} = \sigma_{\text{señal}} / \sigma_{\text{ruido}} \gg 1\), los primeros componentes principales capturan la señal; los últimos, el ruido.
AdvertenciaLimitación importante
PCA funciona bien aquí porque la hélice es una curva linealizable a través de sus coordenadas en el espacio de observaciones. Para estructuras genuinamente no lineales (manifolds curvos), se necesitan técnicas como UMAP o t-SNE.
41.7 Limitaciones del PCA
41.7.1 Linealidad
PCA busca direcciones de máxima varianza lineales. No puede capturar estructuras no lineales en los datos.
Código
from sklearn.datasets import make_swiss_roll

X_swiss, t_swiss = make_swiss_roll(n_samples=800, noise=0.1, random_state=42)
X_swiss_std = StandardScaler().fit_transform(X_swiss)

pca_swiss = PCA(n_components=2)
scores_swiss = pca_swiss.fit_transform(X_swiss_std)

fig = make_subplots(1, 2,
    subplot_titles=['Swiss Roll (3D original)',
                    'Proyección PCA (2D) — estructura perdida'],
    specs=[[{'type': 'scatter3d'}, {'type': 'scatter'}]])

fig.add_trace(go.Scatter3d(
    x=X_swiss[:,0], y=X_swiss[:,1], z=X_swiss[:,2],
    mode='markers',
    marker=dict(size=3, color=t_swiss, colorscale='Viridis', opacity=0.7),
    showlegend=False
), row=1, col=1)

fig.add_trace(go.Scatter(
    x=scores_swiss[:,0], y=scores_swiss[:,1],
    mode='markers',
    marker=dict(size=4, color=t_swiss, colorscale='Viridis', opacity=0.7),
    showlegend=False
), row=1, col=2)

fig.update_layout(height=420,
    annotations=[dict(
        x=0.5, y=-0.08, xref='paper', yref='paper',
        text="PCA colapsa el Swiss Roll: puntos lejanos en la variedad quedan superpuestos",
        showarrow=False, font=dict(size=12, color='gray'), xanchor='center'
    )])
fig.show()
Este es un ejemplo clásico: el Swiss Roll es una variedad no lineal que PCA no puede “desenrollar”. Técnicas como Isomap o UMAP sí pueden recuperar la estructura subyacente.
41.7.2 Sensibilidad a outliers
PCA minimiza la varianza de la reconstrucción, que es equivalente a minimizar el error cuadrático medio. Por tanto, es muy sensible a outliers, ya que un solo punto alejado puede dominar la dirección del primer componente.
La alternativa robusta es Robust PCA (Candès et al., 2011), que descompone \(X = L + S\) donde \(L\) es la componente de bajo rango y \(S\) es una matriz dispersa de outliers.
41.7.3 PCA no captura estructura de clases
PCA es un método no supervisado — maximiza varianza global sin considerar etiquetas. Puede ocurrir que la dirección de máxima varianza no sea la que mejor separa las clases.
Código
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

X_iris_std = StandardScaler().fit_transform(load_iris().data)
y_iris = load_iris().target
nombres_iris = load_iris().target_names

# PCA
pca_comp = PCA(n_components=2)
scores_pca = pca_comp.fit_transform(X_iris_std)

# LDA
lda = LinearDiscriminantAnalysis(n_components=2)
scores_lda = lda.fit_transform(X_iris_std, y_iris)

fig = make_subplots(1, 2,
    subplot_titles=['PCA (no supervisado)', 'LDA (supervisado)'])

colors = px.colors.qualitative.Set1[:3]
for i, esp in enumerate(nombres_iris):
    mask = y_iris == i
    fig.add_trace(go.Scatter(
        x=scores_pca[mask, 0], y=scores_pca[mask, 1],
        mode='markers', marker=dict(color=colors[i], size=7, opacity=0.7),
        name=esp, legendgroup=esp
    ), row=1, col=1)
    fig.add_trace(go.Scatter(
        x=scores_lda[mask, 0], y=scores_lda[mask, 1],
        mode='markers', marker=dict(color=colors[i], size=7, opacity=0.7),
        name=esp, legendgroup=esp, showlegend=False
    ), row=1, col=2)

fig.update_layout(height=400,
    title="PCA vs LDA en Iris — LDA optimiza separación entre clases")
fig.show()
41.7.4 Normalidad: cuándo entra en juego
PCA clásico no requiere normalidad para maximizar la varianza proyectada. Un modelo distinto, el PCA probabilístico, sí añade supuestos gaussianos para las variables latentes y el ruido:
\[ x = W z + \mu + \varepsilon, \quad z \sim \mathcal{N}(0, I), \quad \varepsilon \sim \mathcal{N}(0, \sigma^2 I) \]
En datos muy asimétricos o discretos, revisa si la distancia euclidiana y la reconstrucción lineal responden a la pregunta del análisis; la falta de normalidad por sí sola no invalida PCA clásico.
41.8 Más allá del PCA: técnicas no lineales
Cuando la estructura de interés no cabe bien en una proyección lineal, PCA puede perderla. t-SNE y UMAP producen representaciones útiles para explorar vecindarios; sus ejes y distancias entre grupos requieren interpretación cautelosa.
Para esta sección emplearemos el MNIST dataset, un dataset de imágenes de dígitos escritos a mano que tiene una estructura no lineal compleja con las siguientes caracteristicas:
- 70,000 imágenes de dígitos manuscritos (28x28 píxeles → 784 dimensiones)
- 10 clases (dígitos 0–9)
- Desafío clásico para reducción de dimensionalidad
Notemos que si realizamos PCA sobre este dataset, los dígitos no se separan claramente en el espacio de componentes principales. Esto se debe a que la estructura de los datos es altamente no lineal: dígitos similares pueden estar cerca en el espacio original pero no necesariamente en el espacio PCA.
A continuación, veremos cómo técnicas no lineales como t-SNE y UMAP pueden revelar la estructura subyacente de los dígitos, agrupando visualmente los dígitos similares y separando claramente las clases, a pesar de la complejidad no lineal de los datos.
41.8.1 t-SNE (t-distributed Stochastic Neighbor Embedding)
t-SNE (van der Maaten & Hinton, 2008) construye una distribución de probabilidad sobre pares de puntos en el espacio original y minimiza la divergencia KL con la distribución en el espacio reducido:
\[ \text{KL}(P \| Q) = \sum_{i \neq j} p_{ij} \log \frac{p_{ij}}{q_{ij}} \]
donde \(p_{ij}\) captura similitudes en el espacio original y \(q_{ij}\) en el espacio reducido usando una distribución \(t\) de Student.
Características:
- Excelente para visualización en 2D/3D
- Preserva estructura local (vecinos cercanos)
- No preserva distancias globales — la distancia entre clusters no es interpretable
- No determinista: ejecuciones distintas dan resultados distintos
- No produce una transformación reutilizable para nuevos datos
- Hiperparámetro clave: perplexity (típicamente 5–50)
La perplexity controla cuántos vecinos considera relevantes cada punto al construir la representación.
Formalmente, está relacionada con la entropía de una distribución de probabilidad local:
\[ \text{Perplexity} = 2^{H(P_i)} \]
donde \(P_i\) describe qué tan probable es que otros puntos sean vecinos de \(x_i\). Ajustar la perplexity es crucial: valores muy bajos pueden fragmentar la estructura, mientras que valores muy altos pueden mezclar clusters distintos.
41.8.2 UMAP (Uniform Manifold Approximation and Projection)
UMAP (McInnes et al., 2018) está fundamentado en la teoría de categorías y la geometría Riemanniana. El algoritmo construye una representación del manifold topológico de los datos y optimiza una representación en baja dimensión que preserve esa topología.
Matemáticamente, UMAP modela cada punto \(x_i\) como el centro de una bola geodésica de radio \(\rho_i\) (distancia al vecino más cercano), construyendo un grafo difuso ponderado con pesos:
\[ w(x_i, x_j) = \exp\left(-\frac{d(x_i, x_j) - \rho_i}{\sigma_i}\right) \]
y simetrizado como:
\[ B(x_i, x_j) = w(x_i, x_j) + w(x_j, x_i) - w(x_i, x_j) \cdot w(x_j, x_i) \]
La proyección minimiza la divergencia de entropia cruzada fuzzy entre el grafo original y el proyectado.
Ventajas sobre t-SNE:
| Característica | t-SNE | UMAP |
|---|---|---|
| Velocidad | Lento (\(O(n^2)\)) | Rápido (\(O(n^{1.14})\)) |
| Estructura global | No preserva | Preserva mejor |
| Nuevos datos | No (sin extensión) | Sí (transform()) |
| Determinismo | No | Sí (con random_state) |
| Escalabilidad | Hasta ~10k puntos | Hasta millones |
41.8.3 Cuándo usar cada método
| Situación | Método recomendado |
|---|---|
| Compresión lineal antes de modelado | PCA, validando el efecto en la métrica de la tarea |
| Visualización exploratoria de vecindarios | t-SNE o UMAP, comparando parámetros y semillas |
| Muchos puntos | Probar PCA o UMAP según memoria, tiempo y objetivo |
| Necesito transformar nuevos datos | PCA; UMAP si el modelo ajustado y la implementación ofrecen transform adecuado |
| Interpretabilidad de componentes | PCA (o Sparse PCA) |
| Estructura no lineal compleja | UMAP |
| Análisis supervisado + reducción | LDA |
La elección del método de reducción de dimensionalidad depende del objetivo del análisis y de la naturaleza de los datos. No existe una técnica universalmente superior: cada método enfatiza distintos aspectos de la estructura.
PCA es adecuado cuando se busca una representación lineal, interpretable y reutilizable, especialmente en contextos de preprocesamiento para modelos. En contraste, t-SNE y UMAP están diseñados principalmente para exploración visual, priorizando la preservación de relaciones locales, aunque sacrifican interpretabilidad y capacidad de generalización.
UMAP puede preservar vecindarios y resultar útil con conjuntos grandes, pero el resultado depende de parámetros y recursos. LDA incorpora etiquetas y puede servir cuando el objetivo es discriminación supervisada.
En conjunto, la elección del método debe responder a la pregunta central del análisis:
¿buscamos interpretar, visualizar o modelar?
41.9 Resumen y conexiones
El PCA es el punto de partida del análisis multivariante moderno. Sus conexiones van más allá de la estadística descriptiva:
- Álgebra lineal: eigendescomposición, SVD, espacios vectoriales
- Estadística: modelo probabilístico gaussiano, máxima verosimilitud
- Optimización: problema de Rayleigh quotient, multiplicadores de Lagrange
- Aprendizaje automático: preprocesamiento, regularización, autoencoders lineales
- Métodos de variedades: UMAP y t-SNE usan objetivos distintos de la reconstrucción lineal de PCA
La familia de métodos de reducción de dimensionalidad puede verse como un espectro continuo desde lo lineal (PCA) hasta lo fuertemente no lineal (t-SNE, UMAP), con un trade-off entre interpretabilidad, preservación de estructura global y escalabilidad.
41.10 Laboratorio aplicado: ¿conviene PCA para clasificar Iris?
Objetivo. Separar la pregunta “¿cuánta varianza conserva PCA?” de “¿mejora un clasificador en datos no vistos?”. Usaremos una partición estratificada7 y ajustaremos todo el preprocesamiento dentro de cada pipeline.
7 Partición estratificada: divide los datos manteniendo aproximadamente la proporción de cada clase en entrenamiento y prueba.
- Ejecuta el código y anota la varianza explicada por dos componentes, la exactitud balanceada del modelo con PCA y la del modelo con las cuatro medidas.
- Cambia
n_components=2por1y después por3. Antes de ejecutar cada variante, predice qué ocurrirá con la varianza acumulada y el error de reconstrucción. - Repite con otra semilla en
train_test_split. Explica qué conclusiones son estables y cuáles dependen de una partición pequeña.
Código
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import balanced_accuracy_score

X_train, X_test, y_train, y_test = train_test_split(
    iris.data, iris.target, test_size=0.3, stratify=iris.target, random_state=42
)

modelo_pca = make_pipeline(
    StandardScaler(), PCA(n_components=2), LogisticRegression(max_iter=1000)
)
modelo_base = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))
modelo_pca.fit(X_train, y_train)
modelo_base.fit(X_train, y_train)

transformador = modelo_pca.named_steps['pca']
X_test_escalado = modelo_pca.named_steps['standardscaler'].transform(X_test)
X_test_reconstruido = transformador.inverse_transform(
    transformador.transform(X_test_escalado)
)

resultado_laboratorio = pd.DataFrame({
    'Medida': ['Varianza explicada en entrenamiento',
               'Error medio de reconstrucción en prueba',
               'Exactitud balanceada con PCA en prueba',
               'Exactitud balanceada sin PCA en prueba'],
    'Valor': [transformador.explained_variance_ratio_.sum(),
              np.mean((X_test_escalado - X_test_reconstruido) ** 2),
              balanced_accuracy_score(y_test, modelo_pca.predict(X_test)),
              balanced_accuracy_score(y_test, modelo_base.predict(X_test))]
})
resultado_laboratorio| Medida | Valor | |
|---|---|---|
| 0 | Varianza explicada en entrenamiento | 0.960230 |
| 1 | Error medio de reconstrucción en prueba | 0.040233 |
| 2 | Exactitud balanceada con PCA en prueba | 0.888889 |
| 3 | Exactitud balanceada sin PCA en prueba | 0.911111 |
Comprobación. Verifica que modelo_pca.named_steps['pca'].n_components_ == 2, que la varianza explicada queda entre 0 y 1 y que ninguna medición de prueba interviene en .fit. Al aumentar \(k\), la varianza acumulada no puede disminuir y el error de reconstrucción de los mismos datos transformados no puede aumentar, salvo redondeo numérico.
Interpretación y entrega. Redacta una recomendación de tres frases para alguien que deba desplegar el clasificador: incluye la diferencia observada en exactitud balanceada, el costo de pasar de cuatro variables a \(k\) componentes y una limitación de decidir con una sola partición. Si la exactitud es similar, no concluyas que PCA es siempre necesario.
TipPráctica de trabajo reproducible
Guarda el pipeline completo para inferencia y registra la partición, la semilla, \(k\), la métrica y las versiones de dependencias. Para elegir \(k\), usa validación cruzada dentro de entrenamiento; reserva la prueba final para estimar el rendimiento después de elegirlo.
41.11 Ejercicios propuestos
PCA desde cero: implementa PCA usando únicamente
numpy.linalg.svdsin usarsklearn. Verifica que tus eigenvalores y eigenvectores coincidan con los desklearn.decomposition.PCA.Efecto de la estandarización: aplica PCA al dataset Iris con y sin estandarización. ¿Cambian los componentes? ¿Cambia la varianza explicada? Justifica matemáticamente.
Reconstrucción: dado un dataset \(X\) y su proyección PCA a \(k\) componentes, reconstruye la aproximación \(\hat{X} = Z_k W_k^T + \mu\). Grafica el error de reconstrucción \(\|X - \hat{X}\|_F\) en función de \(k\).
Comparación t-SNE vs UMAP: aplica ambas técnicas al dataset de dígitos MNIST (disponible en
sklearn.datasets.load_digits). Compara visualmente la separación de clases y el tiempo de cómputo.Regla de Kaiser: ¿por qué la regla de Kaiser (\(\lambda > 1\)) solo aplica cuando los datos están estandarizados? Demuéstralo con un ejemplo donde viola la regla sin estandarizar.
41.11.1 Recursos recomendados: EDA multivariado
A continuación se listan libros y recursos clave para profundizar en análisis exploratorio de datos multivariado, reducción de dimensionalidad y visualización. Los pongo en mi orden de preferencia, pero todos son excelentes y complementarios.
Análisis multivariado (nivel intermedio).
Brunton & Kutz — Data-Driven Science and Engineering
https://databookuw.com/
→ Enfoque moderno: PCA, SVD, sistemas dinámicos. (Libre)Trevor Hastie, Robert Tibshirani, Jerome Friedman — The Elements of Statistical Learning
https://web.stanford.edu/~hastie/ElemStatLearn/
→ PCA, LDA, reducción de dimensionalidad y aprendizaje estadístico. (Libre)Gareth James et al. — An Introduction to Statistical Learning
https://www.statlearning.com/
→ Versión más accesible del anterior, incluye PCA y LDA. (Libre)Kevin Murphy — Probabilistic Machine Learning: An Introduction
https://probml.github.io/pml-book/book1.html
→ Enfoque moderno probabilístico, incluye PCA y modelos latentes. (Libre)
Geometría y fundamentos (nivel más teórico).
- Gilbert Strang — Linear Algebra and Learning from Data
https://math.mit.edu/~gs/learningfromdata/
→ Conexión entre álgebra lineal, PCA y datos. (Parcialmente libre)
Visualización y alta dimensión.
Claus O. Wilke — Fundamentals of Data Visualization
https://clauswilke.com/dataviz/
→ Principios de visualización (muy útil para EDA). (Libre)Distill.pub (artículos interactivos)
https://distill.pub/
→ Explicaciones visuales de t-SNE, embeddings y ML. (Libre)