---
title: "t-SNE, UMAP y reducción de dimensionalidad no lineal"
description: "Compara PCA con los métodos no lineales t-SNE y UMAP para visualizar datos de alta dimensión, preservando la estructura local de vecindades."
pagetitle: "t-SNE, UMAP y reducción de dimensionalidad no lineal"
open-graph:
description: "Compara PCA con los métodos no lineales t-SNE y UMAP para visualizar datos de alta dimensión, preservando la estructura local de vecindades."
twitter-card:
description: "Compara PCA con los métodos no lineales t-SNE y UMAP para visualizar datos de alta dimensión, preservando la estructura local de vecindades."
author: "Diego Villalba"
date: today
lang: es
format:
html:
toc: true
toc-depth: 3
toc-title: "Contenido"
number-sections: true
code-fold: true
code-tools: true
code-summary: "Mostrar código"
fig-align: center
theme: cosmo
highlight-style: github
smooth-scroll: true
pdf:
toc: true
toc-depth: 3
number-sections: true
documentclass: scrbook
papersize: letter
fontsize: 11pt
geometry: margin=2.5cm
keep-tex: false
execute:
echo: true
warning: false
message: false
cache: false
bibliography: [referencias_clustering.bib, ../../references.bib]
crossref:
fig-title: "Figura"
tbl-title: "Tabla"
eq-prefix: "Ec."
jupyter: python3
---
Los datos modernos suelen vivir en espacios de decenas, cientos o miles de dimensiones. Aunque matemáticamente bien definidos, estos espacios son difíciles de visualizar e interpretar. La reducción de dimensionalidad busca representar los datos en un espacio de baja dimensión —típicamente 2D o 3D— preservando la estructura relevante: distancias, vecindades, o topología local.
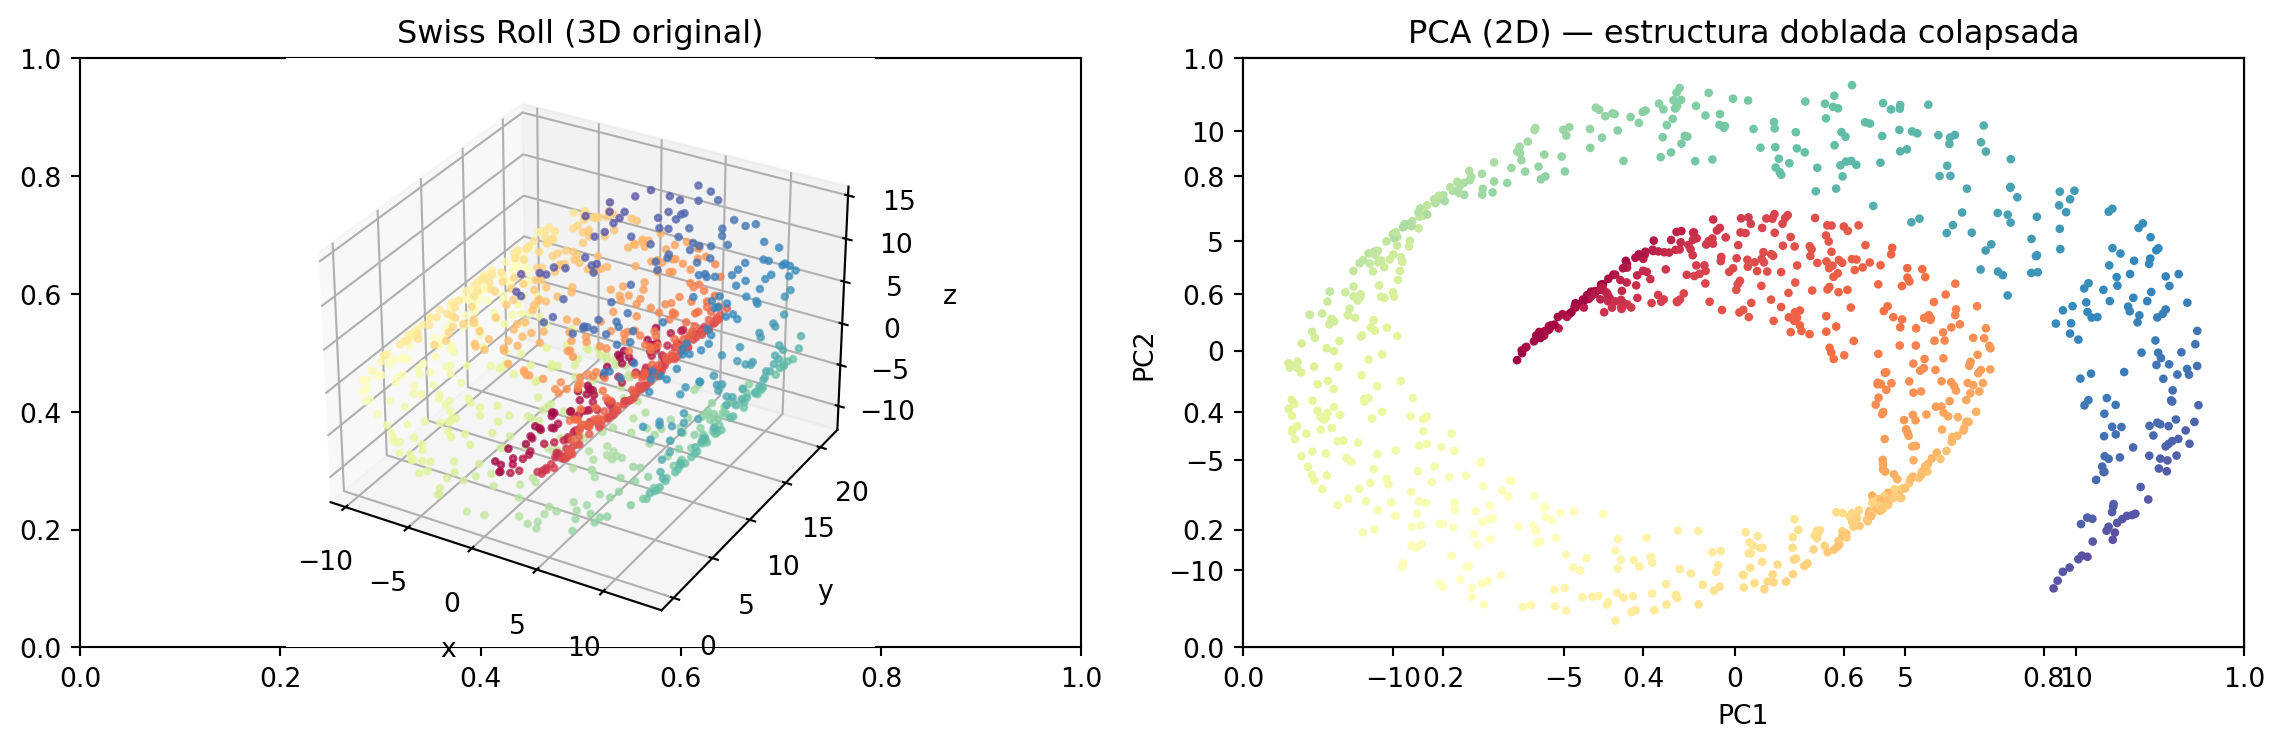
PCA (Análisis de Componentes Principales) es el método lineal clásico: encuentra la proyección ortogonal de menor dimensión que maximiza la varianza conservada [@jolliffe2002]. Sin embargo, PCA asume que la estructura relevante se puede capturar mediante combinaciones lineales de las variables originales. Muchas variedades de datos reales —como manifolds curvos en alta dimensión— requieren métodos no lineales.
t-SNE y UMAP son los dos métodos no lineales más usados en la práctica para visualización de datos de alta dimensión. Ambos intentan preservar la estructura local de vecindades, pero difieren en sus fundamentos teóricos, velocidad de cómputo y capacidad de preservar estructura global [@maaten2008; @mcinnes2018].
## Limitaciones de PCA para visualización
PCA proyecta los datos sobre los $d$ autovectores de la matriz de covarianza con mayores autovalores. Esta proyección es óptima para preservar la varianza, pero no necesariamente preserva la estructura de grupos o la topología local.
```{python}
import numpy as np
from sklearn.datasets import make_swiss_roll
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt

X, color = make_swiss_roll(n_samples=1000, noise=0.05, random_state=42)

pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4))
ax1 = fig.add_subplot(121, projection="3d")
ax1.scatter(X[:, 0], X[:, 1], X[:, 2], c=color, cmap="Spectral", s=5, alpha=0.7)
ax1.set_title("Swiss Roll (3D original)")
ax1.set_xlabel("x"); ax1.set_ylabel("y"); ax1.set_zlabel("z")
ax2 = fig.add_subplot(122)
ax2.scatter(X_pca[:, 0], X_pca[:, 1], c=color, cmap="Spectral", s=5)
ax2.set_title("PCA (2D) — estructura doblada colapsada")
ax2.set_xlabel("PC1"); ax2.set_ylabel("PC2")
plt.tight_layout()
plt.show()
```
## SNE y t-SNE
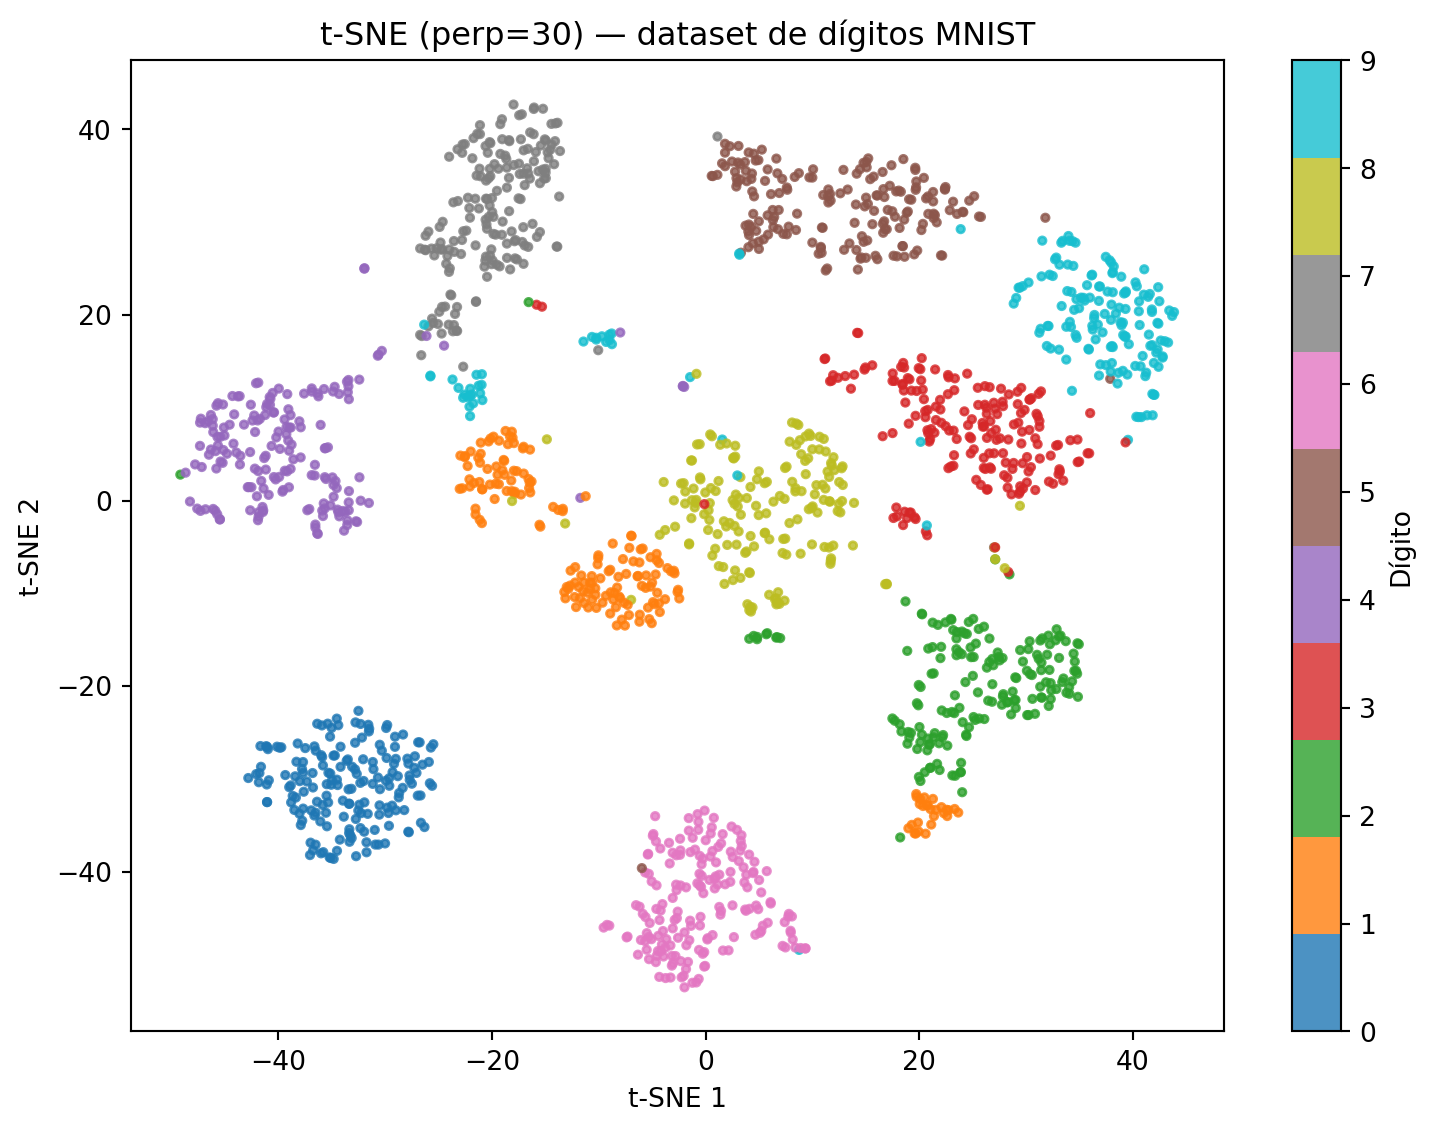
t-SNE fue propuesto por van der Maaten y Hinton en 2008 como mejora de Stochastic Neighbor Embedding (SNE) [@maaten2008]. La idea central es modelar la estructura de vecindades en el espacio original mediante una distribución de probabilidad, construir una distribución análoga en el espacio de baja dimensión, y minimizar la divergencia entre ambas.
### Probabilidades de similitud en el espacio original
Para cada par de puntos $(i,j)$, se define una probabilidad $p_{j|i}$ que refleja qué tan probable es que el punto $j$ sea vecino del punto $i$ si los vecinos se eligieran proporcionalmente a una distribución gaussiana centrada en $i$.
::: {.callout-note appearance="minimal"}
Definición. La similitud condicional asimétrica en el espacio original es:
$$
p_{j|i} = \frac{\exp\left(-\|\mathbf{x}_i-\mathbf{x}_j\|^2/(2\sigma_i^2)\right)}{\sum_{k\neq i}\exp\left(-\|\mathbf{x}_i-\mathbf{x}_k\|^2/(2\sigma_i^2)\right)},
$$ {#eq-tsne-pji}
y la similitud simétrica es $p_{ij} = (p_{j|i}+p_{i|j})/(2n)$.
:::
El ancho $\sigma_i$ se determina para que la entropía de $p_{\cdot|i}$ sea $\log_2(\text{Perp})$, donde Perp es la **perplejidad**, un hiperparámetro que controla el número efectivo de vecinos considerados.
### Distribución en el espacio de baja dimensión
En el espacio de baja dimensión, t-SNE usa una distribución $t$ de Student con un grado de libertad (distribución de Cauchy) en vez de una gaussiana. Esta elección resuelve el problema del crowding: en el espacio original los puntos moderadamente distantes pueden distribuirse en muchas direcciones, pero en 2D no hay suficiente "espacio" para acomodarlos todos, lo que comprime artificialmente los grupos.
::: {.callout-note appearance="minimal"}
Definición. La similitud entre los puntos en el espacio de baja dimensión $\mathbf{y}_i, \mathbf{y}_j$ usando la distribución $t$ de Student es:
$$
q_{ij} = \frac{(1+\|\mathbf{y}_i-\mathbf{y}_j\|^2)^{-1}}{\sum_{k\neq l}(1+\|\mathbf{y}_k-\mathbf{y}_l\|^2)^{-1}}.
$$ {#eq-tsne-qij}
:::
### Función objetivo
t-SNE minimiza la divergencia KL entre la distribución en el espacio original y la distribución en el espacio reducido:
::: {.callout-note appearance="minimal"}
Definición. El objetivo de t-SNE es:
$$
C = \text{KL}(P\|Q) = \sum_{i\neq j} p_{ij}\log\frac{p_{ij}}{q_{ij}}.
$$ {#eq-tsne-kl}
:::
La minimización se realiza mediante descenso de gradiente estocástico, típicamente con aceleración por momentos y un término de exageración inicial que amplifica los $p_{ij}$ en las primeras iteraciones para facilitar la formación de grupos.
### Interpretación de la perplejidad
La perplejidad controla cuántos vecinos efectivos se consideran al construir las distribuciones de similitud. Valores bajos (5-10) priorizan la estructura local muy fina; valores altos (30-100) capturan estructura más global. En la práctica se recomienda probar Perp $\in \{5, 10, 30, 50, 100\}$ y comparar visualmente.
```{=html}
<div id="tsne-wrap" style="font-family:Georgia,serif;max-width:700px;margin:2em auto;background:#f9fafc;border:1px solid #d0d7e3;border-radius:10px;padding:20px 24px;box-shadow:0 2px 12px rgba(30,60,120,.07);">
<div style="text-align:center;margin-bottom:12px;">
<span style="font-size:1.05em;font-weight:bold;color:#1a2e45;">t-SNE: efecto de la perplejidad y las iteraciones</span><br>
<span style="font-size:0.81em;color:#666;">Simula cómo la perplejidad afecta la distribución de similitudes y la separación entre grupos</span>
</div>
<div style="display:grid;grid-template-columns:1fr 1fr;gap:10px;margin-bottom:10px;">
<div><label style="font-size:0.83em;color:#444;">Perplejidad = <strong id="perp-v">30</strong></label><br>
<input id="perp-sl" type="range" min="5" max="100" step="5" value="30" style="width:100%;accent-color:#1a3a5c;"></div>
<div><label style="font-size:0.83em;color:#444;">Grupos en datos = <strong id="ng-v">3</strong></label><br>
<input id="ng-sl" type="range" min="2" max="6" step="1" value="3" style="width:100%;accent-color:#7c3aed;"></div>
</div>
<div id="tsne-info" style="text-align:center;font-size:0.82em;padding:5px 10px;background:#fff;border:1px solid #e0e5ed;border-radius:5px;margin-bottom:10px;min-height:22px;"></div>
<canvas id="tsne-cv" style="display:block;width:100%;border-radius:6px;border:1px solid #e0e5ed;background:#fff;"></canvas>
</div>
<script>
(function(){
const cv=document.getElementById('tsne-cv');
const W=680,H=320,DPR=window.devicePixelRatio||1;
cv.width=W*DPR;cv.height=H*DPR;cv.style.width=W+'px';cv.style.height=H+'px';
const ctx=cv.getContext('2d');ctx.scale(DPR,DPR);
const COLS=['#2563eb','#dc2626','#16a34a','#f59e0b','#7c3aed','#0891b2'];
function makeGroups(ng,n=60){
const pts=[],lbls=[];
const centers=Array.from({length:ng},(_,i)=>{const a=i/ng*2*Math.PI;return[3*Math.cos(a),3*Math.sin(a)];});
for(let i=0;i<n;i++){const c=centers[i%ng];pts.push([c[0]+(Math.random()-0.5)*0.6,c[1]+(Math.random()-0.5)*0.6]);lbls.push(i%ng);}
return{pts,lbls};
}
// Simulate t-SNE effect with perplejidad: low perp = tight groups but noise in global structure
// high perp = better global structure but groups may merge
function simulate(pts,lbls,ng,perp){
const n=pts.length;
// Compute pairwise distances
const D=pts.map(p=>pts.map(q=>Math.sqrt((p[0]-q[0])**2+(p[1]-q[1])**2)));
// Sigma depends on perplexity: approx sigma ~ perp * mean_nn_dist / some_factor
const sigma=Math.max(0.3,perp/30*0.8);
// t-SNE-like 2D layout simulation: place groups in circle, spread based on perp
const spread=1.5+perp/50;
const noise=perp<15?0.8:perp>60?0.3:0.5;
const centers2d=Array.from({length:ng},(_,i)=>{const a=i/ng*2*Math.PI;return[spread*Math.cos(a),spread*Math.sin(a)];});
return pts.map((_,i)=>{
const c=centers2d[lbls[i]];
return[c[0]+(Math.random()-0.5)*noise,c[1]+(Math.random()-0.5)*noise];
});
}
function draw(perp,ng){
const{pts,lbls}=makeGroups(ng);
const embedded=simulate(pts,lbls,ng,perp);
const xVals=embedded.map(p=>p[0]),yVals=embedded.map(p=>p[1]);
const xMn=Math.min(...xVals)-0.5,xMx=Math.max(...xVals)+0.5;
const yMn=Math.min(...yVals)-0.5,yMx=Math.max(...yVals)+0.5;
const PAD={l:30,r:16,t:20,b:24};
const CW=W-PAD.l-PAD.r,CH=H-PAD.t-PAD.b;
const sx=x=>PAD.l+(x-xMn)/(xMx-xMn)*CW;
const sy=y=>PAD.t+CH-(y-yMn)/(yMx-yMn)*CH;
ctx.clearRect(0,0,W,H);
ctx.fillStyle='#f8f9fb';ctx.fillRect(PAD.l,PAD.t,CW,CH);
ctx.strokeStyle='#9aa3b5';ctx.lineWidth=1;ctx.strokeRect(PAD.l,PAD.t,CW,CH);
embedded.forEach((p,i)=>{
ctx.beginPath();ctx.arc(sx(p[0]),sy(p[1]),5,0,2*Math.PI);
ctx.fillStyle=COLS[lbls[i]]+'cc';ctx.fill();
ctx.strokeStyle='#fff';ctx.lineWidth=1.2;ctx.stroke();
});
ctx.fillStyle='#1a2e45';ctx.font='bold 11px Georgia,serif';ctx.textAlign='center';
ctx.fillText(`Visualización tipo t-SNE (Perp=${perp}, k=${ng} grupos)`,PAD.l+CW/2,PAD.t-5);
const sep=perp<15?'baja — grupos fragmentados o ruidosos':perp>60?'alta — grupos pueden solaparse':'óptima para este dataset';
document.getElementById('tsne-info').innerHTML=
`Perplejidad = <strong>${perp}</strong> → separación entre grupos: <em>${sep}</em>`;
}
document.getElementById('perp-sl').addEventListener('input',function(){
document.getElementById('perp-v').textContent=this.value;
draw(parseInt(this.value),parseInt(document.getElementById('ng-sl').value));
});
document.getElementById('ng-sl').addEventListener('input',function(){
document.getElementById('ng-v').textContent=this.value;
draw(parseInt(document.getElementById('perp-sl').value),parseInt(this.value));
});
draw(30,3);
})();
</script>
```
```{python}
from sklearn.datasets import load_digits
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
import numpy as np

digits = load_digits()
X = StandardScaler().fit_transform(digits.data)

tsne = TSNE(n_components=2, perplexity=30, n_iter=1000, random_state=42, learning_rate="auto", init="pca")
X_tsne = tsne.fit_transform(X)

plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_tsne[:, 0], X_tsne[:, 1], c=digits.target,
                      cmap="tab10", s=8, alpha=0.8)
plt.colorbar(scatter, label="Dígito")
plt.title("t-SNE (perp=30) — dataset de dígitos MNIST")
plt.xlabel("t-SNE 1"); plt.ylabel("t-SNE 2")
plt.tight_layout()
plt.show()
```
## UMAP
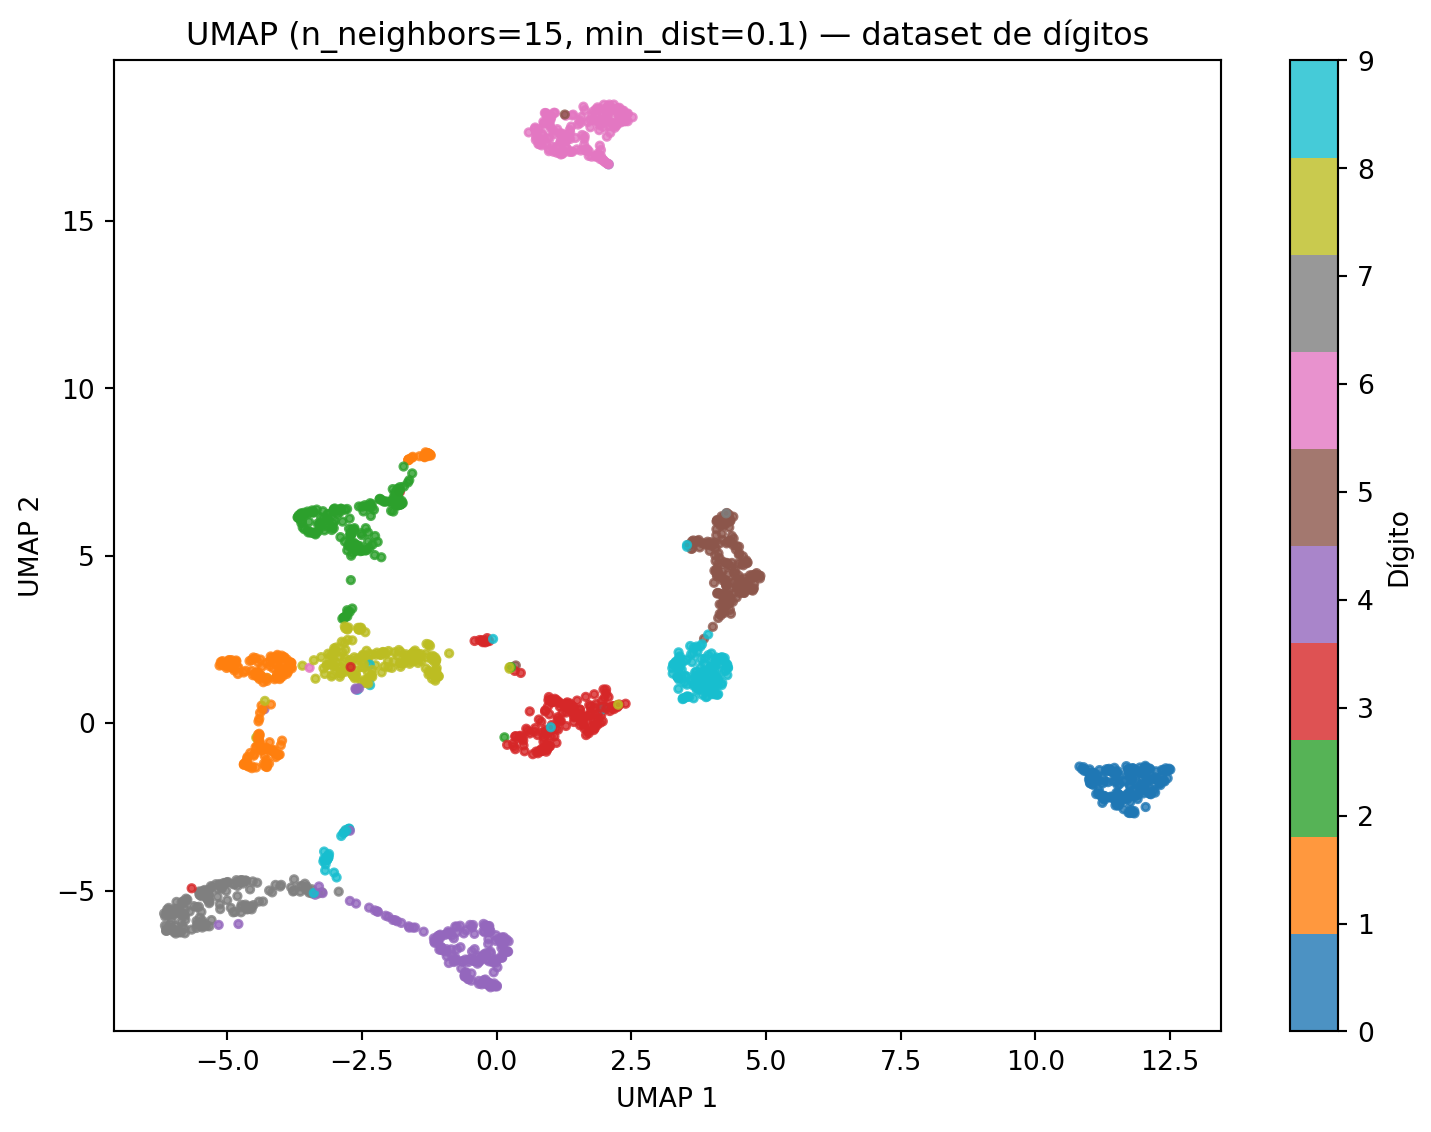
UMAP (Uniform Manifold Approximation and Projection) fue propuesto por McInnes et al. en 2018 [@mcinnes2018] con fundamentos teóricos basados en geometría diferencial y topología algebraica. A diferencia de t-SNE, UMAP tiene una mejor preservación de la estructura global y es significativamente más rápido, lo que lo hace aplicable a conjuntos de datos de millones de puntos.
### Fundamentos teóricos
La base de UMAP es la teoría de conjuntos simpliciales difusos (fuzzy simplicial sets). Los datos se modelan como una variedad de Riemann, se construye una representación topológica local de esa variedad usando grafos ponderados de vecinos más cercanos, y luego se busca una representación de baja dimensión que preserve esa topología.
::: {.callout-note appearance="minimal"}
Definición. UMAP construye un grafo de vecindad ponderado donde la conectividad entre $\mathbf{x}_i$ y $\mathbf{x}_j$ se modela mediante
$$
v_{j|i} = \exp\left(-\frac{d(\mathbf{x}_i,\mathbf{x}_j)-\rho_i}{\sigma_i}\right),
$$ {#eq-umap-vji}
donde $\rho_i$ es la distancia al vecino más cercano de $\mathbf{x}_i$ y $\sigma_i$ se ajusta para que la suma de conectividades sea $\log_2(k)$ (con $k$ el número de vecinos).
:::
La simetrización es $v_{ij} = v_{j|i}+v_{i|j}-v_{j|i}\cdot v_{i|j}$.
En el espacio de baja dimensión, UMAP modela la similitud con una curva de familia parametrizable que se ajusta para aproximar una distribución $t$ de Student. El objetivo es minimizar la divergencia cruzada binaria entre las similitudes en alta y baja dimensión.
### Hiperparámetros principales
**`n_neighbors`:** número de vecinos en el grafo de alta dimensión. Similar a la perplejidad de t-SNE. Valores pequeños capturan estructura local fina; valores grandes capturan estructura global.
**`min_dist`:** distancia mínima entre puntos en el espacio reducido. Controla qué tan compactos son los grupos en la visualización. Valores pequeños producen grupos apretados; valores grandes los esparcen.
```{python}
try:
    import umap
    from sklearn.datasets import load_digits
    from sklearn.preprocessing import StandardScaler
    import matplotlib.pyplot as plt

    digits = load_digits()
    X = StandardScaler().fit_transform(digits.data)

    reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=42)
    X_umap = reducer.fit_transform(X)

    plt.figure(figsize=(8, 6))
    scatter = plt.scatter(X_umap[:, 0], X_umap[:, 1], c=digits.target,
                          cmap="tab10", s=8, alpha=0.8)
    plt.colorbar(scatter, label="Dígito")
    plt.title("UMAP (n_neighbors=15, min_dist=0.1) — dataset de dígitos")
    plt.xlabel("UMAP 1"); plt.ylabel("UMAP 2")
    plt.tight_layout()
    plt.show()

except ImportError:
    print("Instalar umap-learn: pip install umap-learn")
```
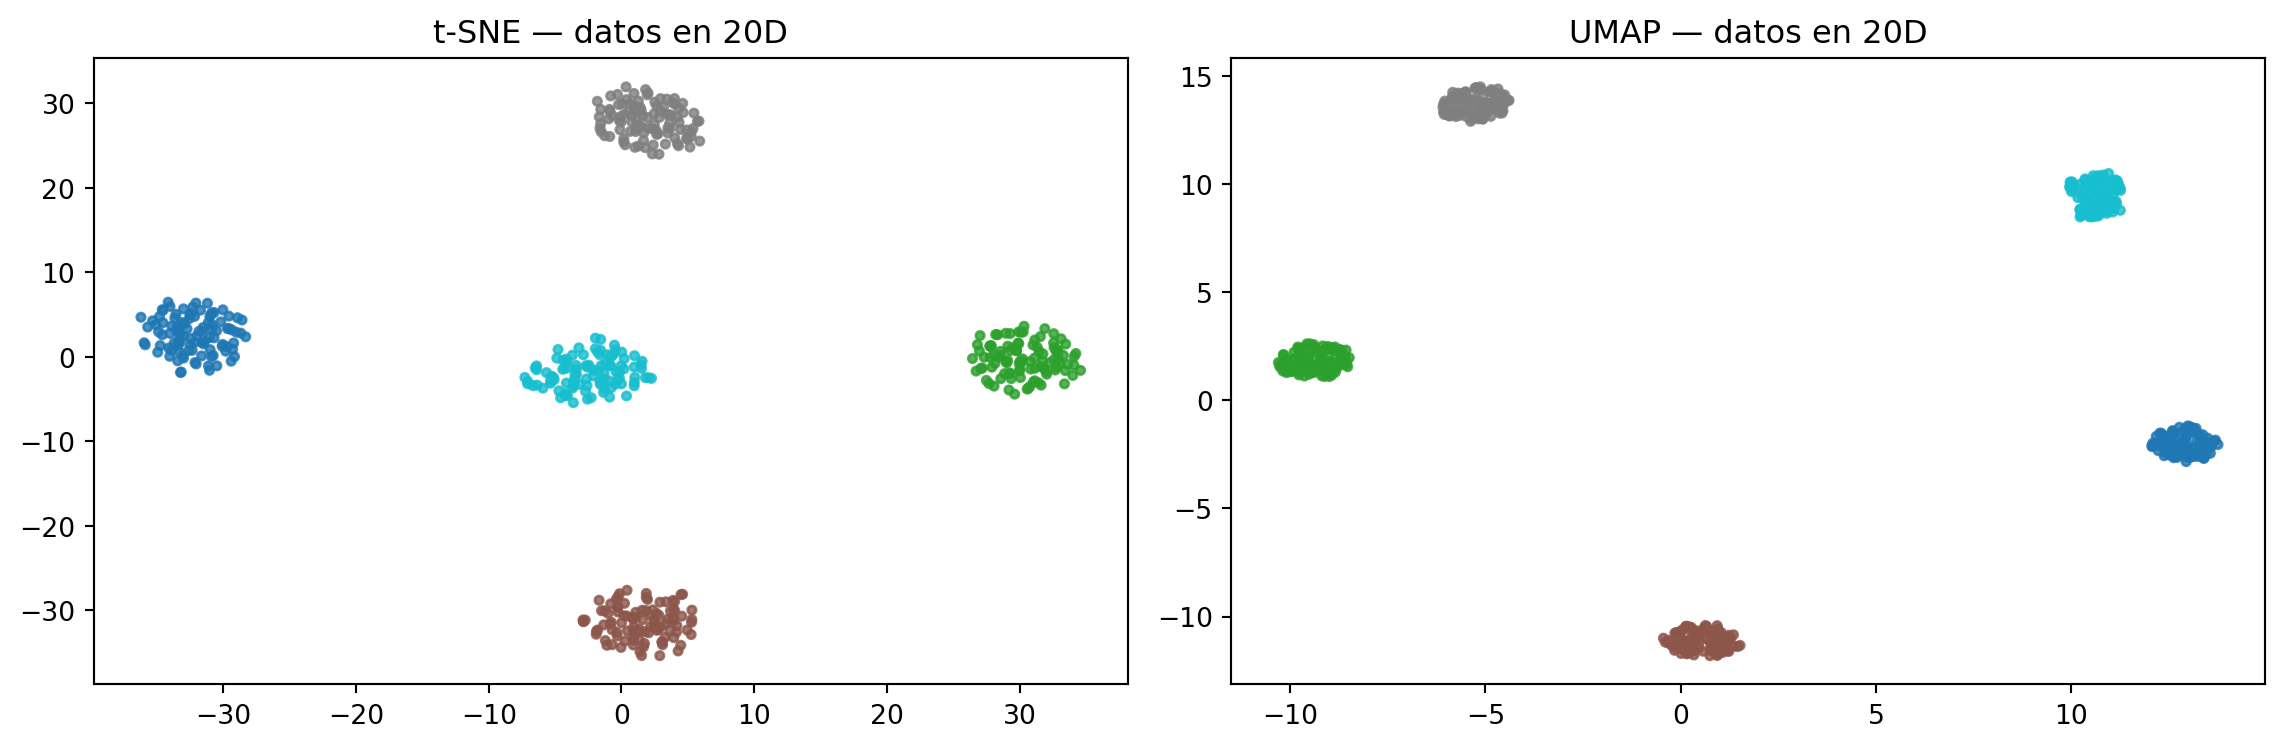
## Comparación t-SNE vs UMAP
| Característica | t-SNE | UMAP |
|---|---|---|
| Fundamento | Divergencia KL, distribución $t$ | Topología difusa, manifold learning |
| Velocidad | $O(n^2)$ ingenuo, $O(n\log n)$ con BH | $O(n^{1.14})$ aproximado |
| Preservación global | Limitada | Mejor que t-SNE |
| Reproducibilidad | Estocástico, varía entre corridas | Más estable con `random_state` |
| Hiperparámetros | Perplejidad, tasa aprendizaje | `n_neighbors`, `min_dist` |
| Escalabilidad | Hasta ~100k puntos | Hasta millones de puntos |
| Uso en clustering | Solo visualización | Sí, como preprocessing |
```{python}
from sklearn.datasets import make_blobs
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
import numpy as np

X_high, y = make_blobs(n_samples=500, n_features=20, centers=5,
                       cluster_std=2.0, random_state=42)
X_std = StandardScaler().fit_transform(X_high)

tsne = TSNE(n_components=2, perplexity=30, random_state=42,
            learning_rate="auto", init="pca")
X_tsne = tsne.fit_transform(X_std)

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
axes[0].scatter(X_tsne[:, 0], X_tsne[:, 1], c=y, cmap="tab10", s=10, alpha=0.8)
axes[0].set_title("t-SNE — datos en 20D")

try:
    import umap
    reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=42)
    X_umap = reducer.fit_transform(X_std)
    axes[1].scatter(X_umap[:, 0], X_umap[:, 1], c=y, cmap="tab10", s=10, alpha=0.8)
    axes[1].set_title("UMAP — datos en 20D")
except ImportError:
    axes[1].text(0.5, 0.5, "Instalar umap-learn", ha="center", va="center")
    axes[1].set_title("UMAP (no instalado)")

plt.tight_layout()
plt.show()
```
## Autoencoder básico para reducción de dimensionalidad
Un autoencoder es una red neuronal que aprende una representación comprimida de los datos. Consiste en un codificador que mapea la entrada a un espacio latente de dimensión reducida, y un decodificador que reconstruye la entrada desde ese espacio latente. El entrenamiento minimiza el error de reconstrucción.
```{=html}
<div id="ae-wrap" style="font-family:Georgia,serif;max-width:700px;margin:2em auto;background:#f9fafc;border:1px solid #d0d7e3;border-radius:10px;padding:20px 24px;box-shadow:0 2px 12px rgba(30,60,120,.07);">
<div style="text-align:center;margin-bottom:12px;">
<span style="font-size:1.05em;font-weight:bold;color:#1a2e45;">Autoencoder — compresión y reconstrucción</span><br>
<span style="font-size:0.81em;color:#666;">Ajusta la dimensión del espacio latente y observa cómo cambia el error de reconstrucción</span>
</div>
<div style="display:flex;align-items:center;gap:12px;margin-bottom:10px;flex-wrap:wrap;">
<label style="font-size:0.83em;color:#444;">Dim. latente = <strong id="ae-dv">2</strong></label>
<input id="ae-dsl" type="range" min="1" max="8" step="1" value="2" style="flex:1;min-width:150px;accent-color:#1a3a5c;">
</div>
<canvas id="ae-cv" style="display:block;width:100%;border-radius:6px;border:1px solid #e0e5ed;background:#fff;"></canvas>
<div id="ae-info" style="text-align:center;font-size:0.82em;padding:5px 10px;background:#fff;border:1px solid #e0e5ed;border-radius:5px;margin-top:8px;min-height:22px;"></div>
</div>
<script>
(function(){
const cv=document.getElementById('ae-cv');
const W=680,H=300,DPR=window.devicePixelRatio||1;
cv.width=W*DPR;cv.height=H*DPR;cv.style.width=W+'px';cv.style.height=H+'px';
const ctx=cv.getContext('2d');ctx.scale(DPR,DPR);
const IN_DIM=16; // simulate 16D input
// Approximate reconstruction error curve (monotone decreasing with latent dim)
function reconErr(d){
// sigmoidal decay: high error at d=1, near 0 at d=8
return 1.0*Math.exp(-0.55*(d-1));
}
// Information preserved
function infoPreserved(d){return 1-reconErr(d);}
function drawArch(latDim){
ctx.clearRect(0,0,W,H);
ctx.fillStyle='#f8f9fb';ctx.fillRect(0,0,W,H);
const layers=[IN_DIM,8,latDim,8,IN_DIM];
const names=['Entrada\n('+IN_DIM+'D)','Enc 1\n(8)','Latente\n('+latDim+'D)','Dec 1\n(8)','Salida\n('+IN_DIM+'D)'];
const nL=layers.length;
const lx=Array.from({length:nL},(_,i)=>W*0.08+i*W*0.21);
const maxN=IN_DIM;
const maxH=H*0.7;
const CY=H*0.42;
const rNode=5;
// Draw connections
for(let l=0;l<nL-1;l++){
const n1=Math.min(layers[l],10),n2=Math.min(layers[l+1],10);
for(let i=0;i<n1;i++)for(let j=0;j<n2;j++){
const y1=CY-(n1-1)*9+(i*2)*(n1>1?9/(n1-1)*9:0)/9-n1*4.5+i*9;
const y2=CY-n2*4.5+j*9;
ctx.strokeStyle='rgba(100,120,180,0.08)';ctx.lineWidth=0.8;
ctx.beginPath();ctx.moveTo(lx[l],y1);ctx.lineTo(lx[l+1],y2);ctx.stroke();
}
}
// Draw nodes
layers.forEach((n,li)=>{
const show=Math.min(n,10);
const more=n>10;
const isLatent=li===2;
const col=isLatent?'#f59e0b':li<2?'#2563eb':'#dc2626';
for(let i=0;i<show;i++){
const ny=CY-show*4.5+i*9;
ctx.beginPath();ctx.arc(lx[li],ny,rNode,0,2*Math.PI);
ctx.fillStyle=col+'cc';ctx.fill();
ctx.strokeStyle='#fff';ctx.lineWidth=1.5;ctx.stroke();
}
if(more){ctx.fillStyle=col;ctx.font='10px Georgia,serif';ctx.textAlign='center';ctx.fillText('⋮',lx[li],CY+show*4.5+12);}
const lbl=names[li];
ctx.fillStyle=isLatent?'#92400e':col;ctx.font=(isLatent?'bold ':'')+`10px Georgia,serif`;ctx.textAlign='center';
lbl.split('\n').forEach((s,si)=>ctx.fillText(s,lx[li],CY+show*4.5+26+si*12));
});
// Bottleneck brace
ctx.strokeStyle='#f59e0b';ctx.lineWidth=2;
ctx.beginPath();ctx.moveTo(lx[2]-18,H*0.12);ctx.lineTo(lx[2]-18,H*0.75);
ctx.moveTo(lx[2]+18,H*0.12);ctx.lineTo(lx[2]+18,H*0.75);ctx.stroke();
ctx.fillStyle='#92400e';ctx.font='bold 9px Georgia,serif';ctx.textAlign='center';
ctx.fillText('cuello',lx[2],H*0.09);
// Error bar chart (right panel)
const bx=W*0.88,by=H*0.15,bh=H*0.7,bw=W*0.06;
const err=reconErr(latDim);
const info=infoPreserved(latDim);
ctx.fillStyle='#dc2626cc';ctx.fillRect(bx-bw,by+bh*(1-err),bw,bh*err);
ctx.fillStyle='#16a34acc';ctx.fillRect(bx,by+bh*(1-info),bw,bh*info);
ctx.strokeStyle='#9aa3b5';ctx.lineWidth=1;
ctx.strokeRect(bx-bw,by,bw,bh);ctx.strokeRect(bx,by,bw,bh);
ctx.fillStyle='#dc2626';ctx.font='9px Georgia,serif';ctx.textAlign='center';
ctx.fillText('Error',bx-bw/2,by+bh+12);ctx.fillText((err*100).toFixed(0)+'%',bx-bw/2,by+bh*(1-err)-4);
ctx.fillStyle='#16a34a';ctx.fillText('Info',bx+bw/2,by+bh+12);ctx.fillText((info*100).toFixed(0)+'%',bx+bw/2,by+bh*(1-info)-4);
// Labels
ctx.fillStyle='#2563eb';ctx.font='bold 10px Georgia,serif';ctx.textAlign='center';
ctx.fillText('Codificador',lx[1],H*0.06);
ctx.fillStyle='#dc2626';ctx.fillText('Decodificador',lx[3],H*0.06);
document.getElementById('ae-info').innerHTML=
`Dimensión latente = <strong>${latDim}</strong> / ${IN_DIM} · `+
`Error de reconstrucción ≈ <strong style="color:#dc2626">${(err*100).toFixed(0)}%</strong> · `+
`Información preservada ≈ <strong style="color:#16a34a">${(info*100).toFixed(0)}%</strong>`;
}
document.getElementById('ae-dsl').addEventListener('input',function(){
const d=parseInt(this.value);
document.getElementById('ae-dv').textContent=d;
drawArch(d);
});
drawArch(2);
})();
</script>
```
```{python}
import numpy as np
from sklearn.datasets import load_digits
from sklearn.preprocessing import MinMaxScaler

# Autoencoder con PyTorch (si disponible) o simulado con sklearn
try:
    import torch
    import torch.nn as nn

    digits = load_digits()
    X = MinMaxScaler().fit_transform(digits.data).astype(np.float32)
    X_tensor = torch.tensor(X)

    class Autoencoder(nn.Module):
        def __init__(self, latent_dim):
            super().__init__()
            self.encoder = nn.Sequential(
                nn.Linear(64, 32), nn.ReLU(),
                nn.Linear(32, latent_dim)
            )
            self.decoder = nn.Sequential(
                nn.Linear(latent_dim, 32), nn.ReLU(),
                nn.Linear(32, 64), nn.Sigmoid()
            )
        def forward(self, x):
            return self.decoder(self.encoder(x))

    ae = Autoencoder(latent_dim=2)
    optimizer = torch.optim.Adam(ae.parameters(), lr=1e-3)
    criterion = nn.MSELoss()

    for epoch in range(200):
        out = ae(X_tensor)
        loss = criterion(out, X_tensor)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    with torch.no_grad():
        Z = ae.encoder(X_tensor).numpy()

    print(f"Error de reconstrucción final (MSE): {loss.item():.6f}")
    print(f"Espacio latente: {Z.shape}")

except ImportError:
    print("PyTorch no disponible. Usando PCA como aproximación.")
    from sklearn.decomposition import PCA
    digits = load_digits()
    X = MinMaxScaler().fit_transform(digits.data)
    pca = PCA(n_components=2)
    Z = pca.fit_transform(X)
    rec = pca.inverse_transform(Z)
    mse = ((X - rec)**2).mean()
    print(f"PCA 2 componentes — MSE de reconstrucción: {mse:.6f}")
    print(f"Varianza explicada: {pca.explained_variance_ratio_.sum():.4f}")
```
## Precauciones y buenas prácticas
Las técnicas de reducción no lineal son herramientas de visualización, no de inferencia estadística. Varias advertencias son importantes:
**No interpretar distancias como absolutas.** Las distancias en el espacio 2D de t-SNE o UMAP no son proporcionales a las distancias originales. Dos puntos cercanos en la visualización no necesariamente son similares en el espacio original.
**Resultados estocásticos.** t-SNE produce resultados distintos en cada corrida salvo que se fije la semilla aleatoria. UMAP es más estable pero sigue siendo estocástico.
**La estructura global no se preserva en t-SNE.** Los grupos lejanos en la visualización de t-SNE no necesariamente están más separados en el espacio original. UMAP preserva mejor la estructura global.
**No usar como único criterio para clustering.** Una apariencia de grupos en 2D no implica que existan grupos reales en el espacio original. Confirmar con métricas internas o externas.
```{python}
from sklearn.manifold import TSNE
from sklearn.datasets import make_blobs
from sklearn.preprocessing import StandardScaler
import numpy as np

# Demostración: correr t-SNE múltiples veces con distintas semillas
X, y = make_blobs(n_samples=200, centers=3, cluster_std=0.8, random_state=0)
X_std = StandardScaler().fit_transform(X)

for seed in [0, 42, 123]:
    tsne = TSNE(n_components=2, perplexity=30, random_state=seed,
                learning_rate="auto", init="pca", n_iter=500)
    Z = tsne.fit_transform(X_std)
    spread = Z.std(axis=0).mean()
    print(f"Semilla {seed:3d} — dispersión media en 2D: {spread:.3f}")
```
## Cuándo usar cada método
| Escenario | Recomendación |
|---|---|
| Visualización rápida, <50k puntos | t-SNE con perplejidad 30 |
| Visualización de millones de puntos | UMAP |
| Se necesita reproducibilidad | UMAP con `random_state` |
| Reducción para clustering posterior | UMAP (preserva mejor estructura global) |
| Reconstrucción aproximada | Autoencoder |
| Interpretabilidad de los ejes | PCA |
| Alta dimensión con manifold no lineal | UMAP o t-SNE después de PCA inicial |