---
title: "El problema de clasificación"
pagetitle: "El problema de clasificación: fronteras, generalización y sobreajuste"
open-graph:
description: "Introducción a la clasificación supervisada: variables predictoras y objetivo, frontera de decisión, referencia mínima, error de entrenamiento y de prueba, clasificador de Bayes, sobreajuste y compromiso sesgo-varianza, con laboratorio interactivo."
twitter-card:
description: "Introducción a la clasificación supervisada: variables predictoras y objetivo, frontera de decisión, referencia mínima, error de entrenamiento y de prueba, clasificador de Bayes, sobreajuste y compromiso sesgo-varianza, con laboratorio interactivo."
description: "Introducción a la clasificación supervisada: variables predictoras y objetivo, frontera de decisión, referencia mínima, error de entrenamiento y de prueba, clasificador de Bayes, sobreajuste y compromiso sesgo-varianza, con laboratorio interactivo."
author: "Diego Villalba"
lang: es
format:
html:
toc: true
toc-depth: 3
toc-title: "Contenido"
code-fold: true
code-tools: true
code-summary: "Mostrar código"
theme: cosmo
highlight-style: github
execute:
echo: true
warning: false
message: false
bibliography: [referencias_fundamentos_clasificacion.bib, referencias_clasificacion.bib, referencias_arboles_regresion_lineal.bib, ../../references.bib]
jupyter: python3
---
{{< include ../preprocesamiento/_labkit.qmd >}}
En el ciclo CRISP-DM, la clasificación pertenece a la fase de **modelado**: ya entendimos el negocio, exploramos los datos y los preparamos; ahora queremos una regla que, a partir de lo que sabemos de un caso, anticipe a qué grupo pertenece. El capítulo anterior, sobre clasificación con reglas de asociación, mostró un primer ejemplo de esa idea. Esta parte del libro la desarrolla con las familias de clasificadores más usadas: vecinos cercanos, árboles y ensambles, modelos lineales, clasificadores probabilísticos y redes neuronales.
Antes de estudiar cualquiera de ellos conviene fijar el vocabulario y, sobre todo, la pregunta que los une: **¿cómo sabemos que un clasificador aprendió algo útil y no solo memorizó los datos?** Este capítulo responde con un ejemplo de diez clientes que se puede calcular a mano y con un laboratorio en el que el lector controla la complejidad de un clasificador y observa cuándo deja de generalizar.
## El problema de clasificación
Un problema de clasificación tiene dos ingredientes:
- **Variables predictoras** (*features*) $\mathbf{x} = (x_1, \ldots, x_p)$: lo que sabemos de cada caso antes de decidir.
- **Variable objetivo** (*target*) $y$, que toma valores en un conjunto **finito** de clases $\mathcal{C} = \{c_1, \ldots, c_K\}$.
Un **clasificador** es una función $f$ que asigna una clase a cada vector de predictoras, $\hat{y} = f(\mathbf{x})$. Se construye con un conjunto de **entrenamiento** de ejemplos etiquetados $\mathcal{D} = \{(\mathbf{x}_i, y_i)\}_{i=1}^{n}$ y se juzga por su desempeño en ejemplos **nuevos**.
| Dominio | Predictoras $\mathbf{x}$ | Objetivo $y$ |
|---|---|---|
| Crédito | ingreso, endeudamiento, historial | paga / no paga |
| Salud | edad, presión, glucosa | diabetes sí / no |
| Correo | frecuencia de palabras, remitente | spam / no spam |
| Botánica | largo y ancho de pétalos | *setosa*, *versicolor*, *virginica* |
| Imágenes | intensidad de cada píxel | dígito 0, 1, …, 9 |
: Ejemplos de problemas de clasificación. {#tbl-ejemplos-clasificacion}
Tres distinciones aparecerán a lo largo de la parte:
- **Binaria o multiclase.** Con $K = 2$ clases el problema es binario y suele hablarse de clase **positiva** (la que interesa detectar: fraude, enfermedad, impago) y **negativa**. Con $K > 2$ es multiclase. Cuando cada caso puede tener varias etiquetas a la vez (una película que es comedia *y* drama) el problema es **multietiqueta**, que no tratamos aquí.
- **Clasificación o regresión.** Si $y$ es numérica y continua (precio, temperatura) el problema es de **regresión**. Varios métodos de esta parte, como los árboles y los vecinos cercanos, sirven para ambas tareas.
- **Clase o puntaje.** Muchos clasificadores no entregan solo una clase, sino un **puntaje** o una **probabilidad estimada** $\hat{p}(y = c \mid \mathbf{x})$. La clase se obtiene después, comparando ese puntaje con un **umbral**. Separar ambas etapas será clave en el capítulo de métricas.
## Intuición: ¿pagará el préstamo?
Una financiera registró a diez clientes a los que prestó dinero. De cada uno conoce su **ingreso** mensual (miles de pesos) y su **endeudamiento** (porcentaje del ingreso comprometido en deudas), y si **pagó** el préstamo.
| Cliente | Ingreso | Endeudamiento (%) | ¿Pagó? |
|---|---:|---:|---|
| 1 | 20 | 20 | sí |
| 2 | 25 | 30 | sí |
| 3 | 32 | 25 | sí |
| 4 | 38 | 35 | sí |
| 5 | 15 | 40 | sí |
| 6 | 30 | 58 | sí |
| 7 | 12 | 55 | no |
| 8 | 22 | 60 | no |
| 9 | 35 | 62 | no |
| 10 | 28 | 48 | no |
: Conjunto de entrenamiento: diez clientes, seis pagaron y cuatro no. {#tbl-clientes}
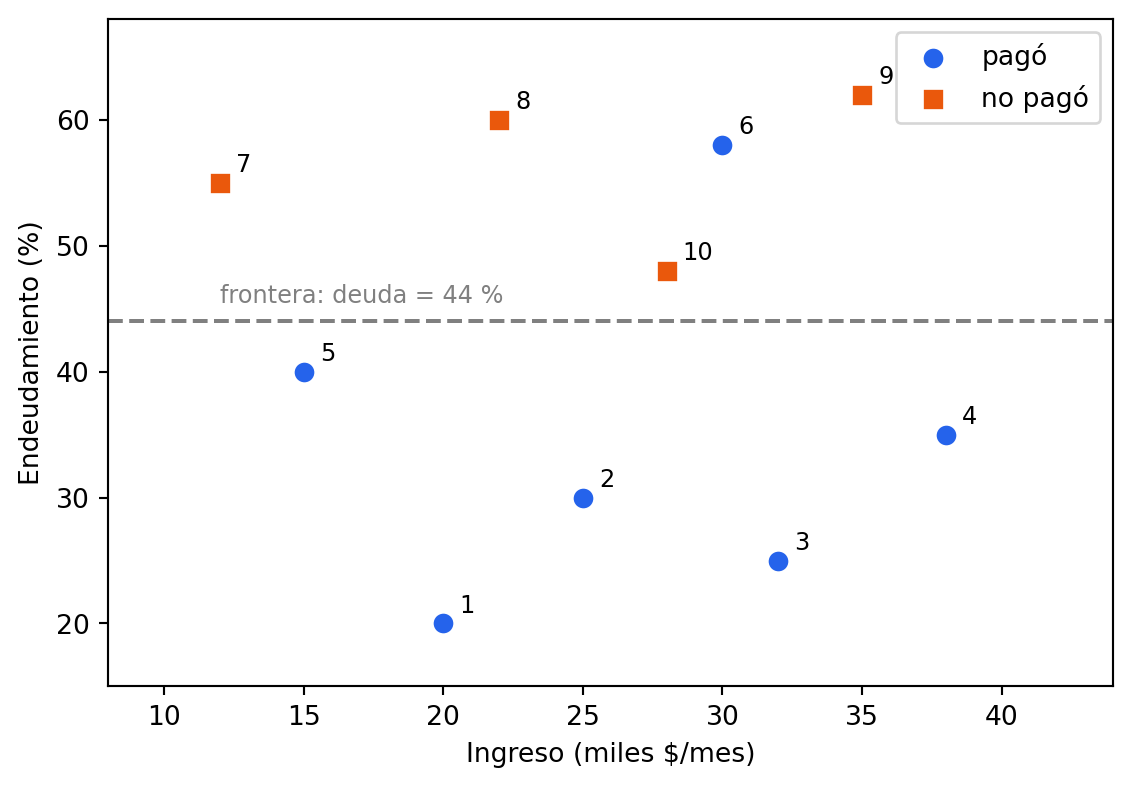
Sin fórmulas ya se ve un patrón: quien compromete menos del 45 % de su ingreso tiende a pagar. El ingreso parece importar poco. Hay una **excepción**: el cliente 6 pagó con un endeudamiento del 58 %. ¿Es un caso que debe aprenderse o es ruido, un cliente que pagó por razones que los datos no registran (una herencia, un aval)? Esa pregunta, aprender la regla general sin aprender las excepciones, es el corazón de este capítulo.
```{python}
#| label: fig-clientes
#| fig-cap: "Los diez clientes de entrenamiento. La línea discontinua es la frontera de la regla «endeudamiento ≤ 44 % ⇒ paga» que se construye en el Paso 2. El cliente 6 queda del lado equivocado."
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

clientes = pd.DataFrame({
    "ingreso": [20, 25, 32, 38, 15, 30, 12, 22, 35, 28],
    "deuda":   [20, 30, 25, 35, 40, 58, 55, 60, 62, 48],
    "paga":    [1, 1, 1, 1, 1, 1, 0, 0, 0, 0],
}, index=range(1, 11))

nuevos = pd.DataFrame({
    "ingreso": [18, 31, 26, 36, 40],
    "deuda":   [35, 60, 45, 30, 50],
    "paga":    [1, 0, 0, 1, 1],
}, index=list("ABCDE"))

fig, ax = plt.subplots(figsize=(6, 4.2))
for clase, color, marca, nombre in [(1, "#2563eb", "o", "pagó"), (0, "#ea580c", "s", "no pagó")]:
    d = clientes[clientes.paga == clase]
    ax.scatter(d.ingreso, d.deuda, c=color, marker=marca, s=70, label=nombre, edgecolor="white")
for i, fila in clientes.iterrows():
    ax.annotate(str(i), (fila.ingreso, fila.deuda), textcoords="offset points", xytext=(6, 4), fontsize=9)
ax.axhline(44, ls="--", c="gray")
ax.text(12, 45.5, "frontera: deuda = 44 %", color="gray", fontsize=9)
ax.set(xlabel="Ingreso (miles $/mes)", ylabel="Endeudamiento (%)", xlim=(8, 44), ylim=(15, 68))
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()
```
## Construcción paso a paso
### Paso 1. La referencia mínima
El clasificador más simple ignora las predictoras y responde siempre la clase más frecuente. Aquí, «sí paga», con una exactitud de $6/10 = 0.60$. A este clasificador se le llama **referencia** (*baseline*) y todo modelo debe superarlo; si no, no aprendió nada de las predictoras[^baseline].
### Paso 2. Una regla de un solo corte
Busquemos la mejor regla de la forma «si el endeudamiento es a lo más $t$, entonces paga». Ordenamos los valores de endeudamiento y probamos un corte $t$ en el punto medio entre cada par de valores consecutivos:
| Corte $t$ | Clasificados «paga» | Errores | Quiénes fallan |
|---:|---|---:|---|
| 32.5 | 1, 2, 3 | 3 | 4, 5, 6 |
| 37.5 | 1, 2, 3, 4 | 2 | 5, 6 |
| **44.0** | **1, 2, 3, 4, 5** | **1** | **6** |
| 51.5 | 1–5 y 10 | 2 | 6, 10 |
| 59.0 | 1–7 y 10 | 2 | 7, 10 |
: Errores de entrenamiento de la regla «deuda ≤ t ⇒ paga» para algunos cortes. {#tbl-cortes}
El mejor corte es $t = 44$ (punto medio entre 40 y 48), con un solo error: el cliente 6. Haciendo lo mismo con el ingreso, el mejor corte comete 3 errores, así que el endeudamiento es la variable más informativa. Esta regla de una sola pregunta, llamada **tocón de decisión** (*decision stump*), acierta $9/10 = 0.90$ en entrenamiento.
Geométricamente, la regla divide el plano en dos **regiones de decisión** separadas por la recta horizontal $\text{deuda} = 44$: la **frontera de decisión** de la @fig-clientes.
### Paso 3. Memorizar: el vecino más cercano
Otra estrategia es no resumir nada: guardar los diez clientes y, ante uno nuevo, responder lo mismo que el cliente **más parecido**, medido con la distancia euclidiana[^distancia]. Este es el clasificador del **vecino más cercano** (1-NN).
En entrenamiento acierta $10/10$ por construcción: el vecino más cercano de cada cliente es él mismo. Pero ¿qué responde ante un cliente nuevo con ingreso 31 y endeudamiento 60? Calculamos su distancia a los tres clientes más próximos:
$$
\begin{aligned}
d(\text{nuevo}, 6) &= \sqrt{(31-30)^2 + (60-58)^2} = \sqrt{5} \approx 2.24 \quad (\text{pagó}),\\
d(\text{nuevo}, 9) &= \sqrt{(31-35)^2 + (60-62)^2} = \sqrt{20} \approx 4.47 \quad (\text{no pagó}),\\
d(\text{nuevo}, 8) &= \sqrt{(31-22)^2 + (60-60)^2} = 9.00 \quad (\text{no pagó}).
\end{aligned}
$$
El más cercano es el cliente 6, la excepción, así que 1-NN predice «paga» para alguien con 60 % de endeudamiento. Si en lugar de un vecino consultamos a los **tres** más cercanos y votamos (3-NN), ganan dos «no» contra un «sí»: la votación diluye la excepción.
### Paso 4. La prueba: cinco clientes nuevos
La financiera observa a cinco clientes que **no** se usaron para construir las reglas:
| Cliente | Ingreso | Deuda (%) | Real | Referencia | Corte 44 | 1-NN | 3-NN |
|---|---:|---:|---|---|---|---|---|
| A | 18 | 35 | sí | sí ✓ | sí ✓ | sí ✓ | sí ✓ |
| B | 31 | 60 | no | sí ✗ | no ✓ | sí ✗ | no ✓ |
| C | 26 | 45 | no | sí ✗ | no ✓ | no ✓ | sí ✗ |
| D | 36 | 30 | sí | sí ✓ | sí ✓ | sí ✓ | sí ✓ |
| E | 40 | 50 | sí | sí ✓ | no ✗ | no ✗ | no ✗ |
: Predicciones sobre el conjunto de prueba. {#tbl-prueba}
Resumimos el desempeño de los cuatro clasificadores en ambos conjuntos:
| Clasificador | Exactitud en entrenamiento | Exactitud en prueba |
|---|---:|---:|
| Referencia (siempre «sí») | 6/10 = 0.60 | 3/5 = 0.60 |
| Corte en deuda = 44 | 9/10 = 0.90 | 4/5 = 0.80 |
| 1-NN | **10/10 = 1.00** | 3/5 = 0.60 |
| 3-NN | 9/10 = 0.90 | 3/5 = 0.60 |
: Exactitud de entrenamiento frente a exactitud de prueba. {#tbl-resumen-intro}
Tres lecciones que se repetirán en toda la parte:
1. **La exactitud de entrenamiento es optimista.** El 1-NN es perfecto en los datos que memorizó y no mejor que la referencia en datos nuevos.
2. **Más flexible no es mejor.** La regla de un solo corte es la menos flexible de las tres que usan predictoras y es la que mejor generaliza aquí, porque se niega a aprender la excepción.
3. **Con pocos datos, la evaluación es ruidosa.** Cinco clientes de prueba son muy pocos: un solo caso, el E, cambia la exactitud en 0.20. Los capítulos de evaluación muestran cómo obtener estimaciones más estables.
## Formalización
### Pérdida, riesgo y error empírico
Para medir los errores usamos la **pérdida 0-1**, que vale 1 si la predicción falla y 0 si acierta: $L(y, \hat{y}) = \mathbb{1}[y \neq \hat{y}]$. Lo que realmente queremos minimizar es el **riesgo** o error esperado sobre la población de la que vienen los datos[^esperanza]:
$$
R(f) = \mathbb{E}_{(\mathbf{x}, y)}\big[\mathbb{1}[y \neq f(\mathbf{x})]\big] = P\big(y \neq f(\mathbf{x})\big).
$$ {#eq-riesgo}
Como no conocemos la población, lo aproximamos con un promedio sobre una muestra, el **error empírico**:
$$
\hat{R}_{\mathcal{S}}(f) = \frac{1}{|\mathcal{S}|} \sum_{(\mathbf{x}_i, y_i) \in \mathcal{S}} \mathbb{1}[y_i \neq f(\mathbf{x}_i)].
$$ {#eq-riesgo-empirico}
Si $\mathcal{S}$ es el conjunto de entrenamiento, $\hat{R}$ es el **error de entrenamiento**; si $\mathcal{S}$ es un conjunto de prueba independiente, es el **error de prueba**. Solo el segundo es una estimación honesta de $R(f)$, porque $f$ se eligió precisamente para que el primero fuera pequeño.
### Regiones y fronteras de decisión
Todo clasificador parte el espacio de predictoras en **regiones de decisión** $\mathcal{R}_c = \{\mathbf{x} : f(\mathbf{x}) = c\}$. Las **fronteras de decisión** son los bordes entre regiones. La forma de esas fronteras distingue a las familias de clasificadores: rectas o hiperplanos en los modelos lineales, escalones paralelos a los ejes en los árboles, fronteras poligonales en el vecino más cercano y curvas suaves en las redes neuronales.
### El mejor clasificador posible: el clasificador de Bayes
Supongamos que conociéramos la probabilidad de cada clase dado $\mathbf{x}$, $p(c \mid \mathbf{x}) = P(y = c \mid \mathbf{x})$[^condicional]. Entonces la regla que minimiza el riesgo de la @eq-riesgo es elegir la clase más probable:
$$
f^{*}(\mathbf{x}) = \arg\max_{c \in \mathcal{C}} \, p(c \mid \mathbf{x}).
$$ {#eq-bayes-optimo}
Este es el **clasificador de Bayes**. Su riesgo, el **error de Bayes** $R^{*} = \mathbb{E}_{\mathbf{x}}\big[1 - \max_c p(c \mid \mathbf{x})\big]$, es el mínimo alcanzable por **cualquier** clasificador. No es cero cuando las clases se traslapan: dos clientes con el mismo ingreso y el mismo endeudamiento pueden comportarse distinto, y ninguna regla basada solo en esas dos variables puede acertar ambos. Ese error es **irreducible** con las predictoras disponibles; solo se reduce midiendo variables nuevas.
Todos los clasificadores de esta parte pueden leerse como intentos de aproximar $f^{*}$ a partir de una muestra finita:
- los **vecinos cercanos** estiman $p(c \mid \mathbf{x})$ con la proporción de cada clase entre los vecinos;
- los **árboles** la estiman con la proporción de cada clase en la hoja;
- la **regresión logística** modela $p(c \mid \mathbf{x})$ directamente con una función paramétrica;
- los **clasificadores bayesianos** modelan $p(\mathbf{x} \mid c)$ y $P(c)$ y aplican el teorema de Bayes.
Los dos últimos ilustran una distinción importante: los modelos **discriminativos** aprenden la frontera o $p(c \mid \mathbf{x})$; los **generativos** aprenden cómo se generan los datos de cada clase[^generativo].
### Generalización, sobreajuste y subajuste
Un clasificador **generaliza** cuando su error de prueba se parece a su error de entrenamiento y ambos son bajos. Hay dos maneras de fallar:
- **Subajuste** (*underfitting*): el modelo es demasiado rígido para el patrón real; ambos errores son altos. La referencia del Paso 1 es el caso extremo.
- **Sobreajuste** (*overfitting*): el modelo es tan flexible que aprende también el ruido de la muestra; el error de entrenamiento es bajo y el de prueba, alto. El 1-NN del Paso 3 es el caso extremo.
La **complejidad** (o flexibilidad) de un clasificador se controla con **hiperparámetros**[^hiperparametro]: el número de vecinos $k$, la profundidad de un árbol, la regularización de un modelo lineal. Al aumentar la complejidad, el error de entrenamiento baja casi siempre, mientras que el de prueba suele dibujar una **U**: baja mientras el modelo aprende el patrón y sube cuando empieza a aprender el ruido.
Esta U es la cara visible del **compromiso sesgo–varianza** [@geman1992neural]. Un modelo rígido tiene **sesgo**: aunque lo entrenáramos con muchas muestras distintas, se equivocaría de forma sistemática. Un modelo flexible tiene **varianza**: con otra muestra de entrenamiento produciría una frontera muy distinta[^sesgo-varianza]. El error de prueba se descompone, de forma aproximada, en
$$
\text{error de prueba} \;\approx\; \underbrace{R^{*}}_{\text{irreducible}} \;+\; \text{sesgo} \;+\; \text{varianza},
$$
y elegir la complejidad es buscar el punto donde la suma es mínima. Con más datos, la varianza baja y el punto óptimo se desplaza hacia modelos más flexibles.
### Paramétricos y no paramétricos
Los clasificadores **paramétricos** (regresión logística, discriminante lineal, Naive Bayes) resumen los datos en un número fijo de parámetros; después de entrenarlos se pueden desechar los datos. Los **no paramétricos** (vecinos cercanos, árboles sin límite de profundidad) crecen con los datos: el 1-NN *es* el conjunto de entrenamiento. Los primeros suelen tener más sesgo y menos varianza; los segundos, lo contrario.
## Laboratorio: complejidad y generalización
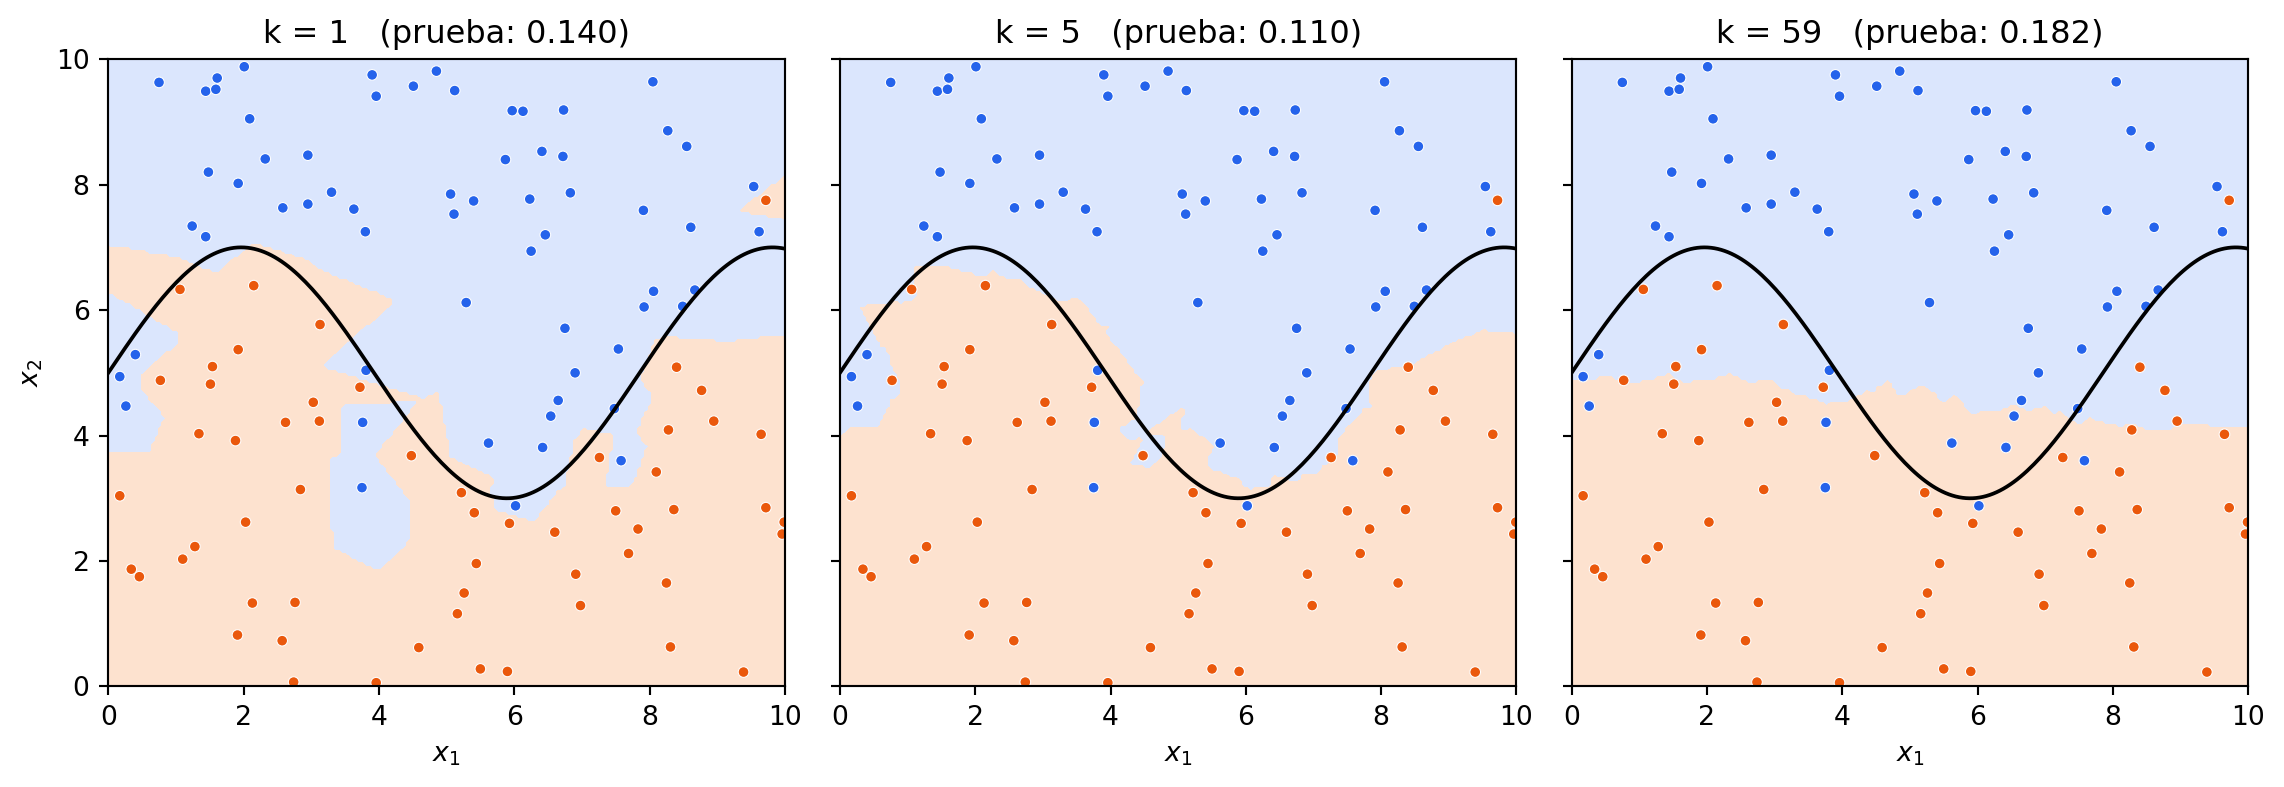
El laboratorio usa el clasificador de $k$ vecinos más cercanos ($k$-NN): para un punto nuevo busca los $k$ puntos de entrenamiento más próximos y responde la clase mayoritaria entre ellos. El hiperparámetro $k$ controla la complejidad: con $k = 1$ la frontera rodea cada punto; con $k$ grande se vuelve suave y, en el extremo, todo el plano recibe la clase mayoritaria.
Tiene dos conjuntos de datos. **Diez clientes** reproduce las @tbl-prueba y @tbl-resumen-intro. **Muestra grande** usa 120 puntos de entrenamiento y 400 de prueba simulados a partir de una probabilidad real conocida, de modo que se puede calcular el error de Bayes (alrededor de 0.09) y compararlo con lo que logra $k$-NN.
::: {.content-visible when-format="html"}
```{=html}
<div class="plab" id="gen-lab">
<p class="plab-eyebrow">Laboratorio · Generalización</p>
<h3 class="plab-title">¿Cuántos vecinos hay que consultar?</h3>
<p class="plab-sub">Mueve k y observa la frontera de decisión y los dos errores. Las regiones sombreadas son la predicción del clasificador en cada punto del plano; los puntos con borde grueso son errores.</p>
<div class="plab-controls">
<div class="plab-field">Datos
<div class="plab-seg" id="gen-data">
<button data-value="small" aria-pressed="true">Diez clientes</button>
<button data-value="big">Muestra grande</button>
</div>
</div>
<div class="plab-field">Mostrar
<div class="plab-seg" id="gen-show">
<button data-value="train" aria-pressed="true">Entrenamiento</button>
<button data-value="test">Prueba</button>
</div>
</div>
<label>Vecinos k: <b id="gen-k-v"></b><input type="range" id="gen-k" min="1" max="9" step="2" value="1"></label>
<label id="gen-n-wrap">Tamaño de entrenamiento: <b id="gen-n-v"></b><input type="range" id="gen-n" min="20" max="120" step="10" value="120"></label>
</div>
<div class="plab-stats">
<div class="plab-stat"><span>Error de entrenamiento</span><strong id="gen-etr"></strong></div>
<div class="plab-stat"><span>Error de prueba</span><strong id="gen-ete"></strong></div>
<div class="plab-stat"><span>Error de la referencia (mayoritaria)</span><strong id="gen-base"></strong></div>
<div class="plab-stat"><span id="gen-bayes-l">Error de Bayes</span><strong id="gen-bayes"></strong></div>
</div>
<div class="plab-grid">
<div class="plab-panel">
<h4>Regiones de decisión</h4>
<svg id="gen-svg" role="img" aria-label="Plano con las regiones de decisión de k vecinos y los puntos de entrenamiento o prueba"></svg>
<div class="plab-legend">
<span><i class="dot" style="background:var(--lab-s1)"></i><span id="gen-l1">clase 1</span></span>
<span><i class="dot" style="background:var(--lab-s2)"></i><span id="gen-l0">clase 0</span></span>
<span><i class="dot" style="background:transparent;border:2px solid var(--lab-text)"></i>mal clasificado</span>
<span><i style="background:var(--lab-s3)"></i>frontera de Bayes (muestra grande)</span>
</div>
</div>
<div class="plab-panel">
<h4>Error según k</h4>
<svg id="gen-curve" role="img" aria-label="Error de entrenamiento y de prueba en función del número de vecinos"></svg>
<div class="plab-legend">
<span><i style="background:var(--lab-s1)"></i>entrenamiento</span>
<span><i style="background:var(--lab-s4)"></i>prueba</span>
<span><i style="background:var(--lab-s3)"></i>error de Bayes</span>
<span><i class="dot" style="background:var(--lab-s2)"></i>k actual</span>
</div>
</div>
</div>
<div class="plab-panel" id="gen-tab-wrap" style="margin-top:1rem">
<h4>Predicciones para los clientes de prueba</h4>
<div id="gen-tab" class="plab-scroll"></div>
</div>
<p class="plab-note" id="gen-note" aria-live="polite"></p>
</div>
<script>
(() => {
const K = window.LabKit, root = document.getElementById('gen-lab');
const $ = s => root.querySelector(s);
const BIG = {"tr":[[5.12,9.5,1],[1.44,9.49,1],[3.12,4.23,0],[8.28,4.09,0],[5.5,0.28,0],[7.54,5.38,1],[3.3,7.88,1],[3.03,4.53,0],[1.34,4.03,0],[2.03,2.62,0],[7.5,2.8,0],[4.85,9.81,1],[9.62,7.25,1],[5.41,2.77,0],[1.61,9.7,1],[5.16,1.16,0],[6.23,7.77,1],[6.13,9.17,1],[0.4,5.29,1],[4.59,0.62,0],[6.41,8.53,1],[5.93,2.6,0],[8.4,5.09,0],[5.11,7.53,1],[1.48,8.2,1],[6.83,7.87,1],[1.92,8.02,1],[1.91,0.82,0],[8.55,8.61,1],[8.77,4.72,0],[2.74,0.07,0],[6.46,7.2,1],[8.36,2.82,0],[2.15,6.39,0],[8.05,9.64,1],[1.51,4.82,0],[8.95,4.23,0],[5.9,0.24,0],[6.73,9.19,1],[8.27,8.86,1],[6.6,2.46,0],[7.69,2.12,0],[8.31,0.63,0],[8.25,1.65,0],[3.75,3.17,1],[6.91,1.79,0],[3.96,0.06,0],[2.62,4.21,0],[1.06,6.33,0],[3.8,7.25,1],[6.54,4.31,1],[8.67,6.32,1],[8.1,3.42,0],[5.44,1.96,0],[9.96,2.43,0],[2.57,0.73,0],[2.58,7.63,1],[6.98,1.29,0],[3.76,4.21,1],[6.65,4.56,1],[5.87,8.4,1],[7.26,3.65,0],[4.48,3.68,0],[1.1,2.03,0],[2.84,3.14,0],[3.13,5.77,0],[9.72,7.75,0],[7.91,7.59,1],[5.97,9.18,1],[6.9,5.0,1],[0.77,4.88,0],[2.13,1.33,0],[5.06,7.85,1],[2.95,7.69,1],[5.26,1.49,0],[9.65,4.02,0],[2.95,8.47,1],[1.24,7.34,1],[1.88,3.92,0],[2.32,8.41,1],[3.9,9.75,1],[6.25,6.94,1],[5.22,3.09,0],[3.96,9.41,1],[2.01,9.88,1],[7.58,3.6,1],[6.42,3.81,1],[3.81,5.04,1],[0.17,4.94,1],[9.72,2.85,0],[7.48,4.43,1],[2.09,9.05,1],[0.17,3.04,0],[9.99,2.62,0],[8.49,6.06,1],[8.06,6.3,1],[3.63,7.61,1],[0.26,4.47,1],[3.72,4.77,0],[1.28,2.23,0],[5.62,3.88,1],[7.92,6.05,1],[8.61,7.32,1],[6.02,2.88,1],[7.83,2.51,0],[0.75,9.63,1],[5.4,7.74,1],[5.29,6.12,1],[0.34,1.87,0],[6.75,5.71,1],[1.59,9.52,1],[1.54,5.1,0],[1.44,7.17,1],[2.76,1.34,0],[0.46,1.75,0],[1.92,5.37,0],[4.51,9.57,1],[9.54,7.97,1],[6.72,8.45,1],[9.39,0.23,0]],"te":[[2.62,2.98,0],[8.14,0.92,0],[6.0,7.29,1],[1.88,0.55,0],[2.75,6.57,1],[5.62,1.5,0],[4.33,6.69,1],[4.23,6.33,1],[9.67,6.83,0],[3.92,1.87,0],[3.46,5.11,0],[8.91,7.76,1],[3.18,9.24,1],[4.71,6.94,1],[1.07,1.05,0],[2.02,8.84,1],[6.8,8.49,1],[6.44,4.07,1],[5.17,5.93,1],[8.62,4.38,0],[8.92,6.14,0],[8.29,4.98,0],[6.93,3.39,0],[5.23,2.16,0],[1.01,0.39,0],[7.02,4.56,0],[8.98,8.35,1],[3.85,9.74,1],[5.92,7.66,1],[4.07,1.96,1],[1.72,1.81,0],[6.04,1.13,0],[0.2,8.33,1],[0.99,4.51,0],[4.88,6.2,1],[5.04,9.37,1],[7.5,5.74,1],[6.17,5.07,1],[9.65,2.27,0],[6.89,5.55,1],[0.42,2.96,0],[9.27,7.85,1],[0.13,2.97,0],[0.1,8.27,1],[1.1,0.57,0],[9.82,4.46,0],[3.18,0.49,0],[3.9,3.66,0],[5.23,0.07,0],[1.48,2.1,0],[4.41,3.02,0],[6.13,2.85,0],[9.1,9.62,1],[0.59,2.09,0],[5.63,7.71,1],[0.64,1.85,0],[4.57,6.69,1],[9.03,8.67,1],[7.94,0.53,0],[9.77,6.15,0],[0.86,2.55,0],[6.21,3.86,1],[4.47,8.05,1],[8.24,5.47,0],[7.92,4.06,0],[9.74,6.05,0],[9.68,0.44,0],[8.83,5.59,1],[7.14,1.93,0],[5.49,2.89,0],[1.05,0.03,0],[9.07,6.71,1],[2.05,2.58,0],[4.66,8.18,1],[1.18,9.68,1],[9.44,2.45,0],[6.41,3.6,0],[6.97,0.87,0],[4.7,5.88,1],[6.26,6.93,1],[8.91,2.41,0],[1.53,3.91,0],[5.69,9.61,1],[7.11,7.38,1],[9.73,2.68,0],[2.59,4.23,0],[2.95,6.51,0],[9.52,1.54,0],[5.18,6.78,1],[4.93,9.14,1],[7.37,8.82,1],[1.12,1.96,0],[0.66,8.29,1],[9.63,0.14,0],[7.89,7.28,0],[9.08,2.7,0],[7.15,2.37,0],[0.76,7.45,1],[0.42,7.0,1],[2.83,4.87,0],[8.92,2.43,0],[4.68,3.55,0],[1.9,4.74,0],[1.82,7.99,1],[6.15,2.83,0],[9.73,3.45,0],[6.71,7.33,1],[2.65,0.12,0],[8.93,9.56,1],[1.7,1.54,0],[4.33,5.98,1],[9.89,9.63,1],[9.88,2.46,0],[5.99,4.36,1],[2.31,0.65,0],[1.69,3.58,0],[0.88,1.51,0],[0.45,6.23,1],[4.93,2.44,0],[5.26,4.24,1],[6.59,9.33,1],[3.53,6.45,1],[2.19,9.4,1],[6.18,1.59,0],[2.57,1.59,0],[1.79,3.07,0],[8.23,4.57,0],[2.77,4.19,0],[2.67,7.34,1],[0.59,2.89,0],[3.23,1.82,0],[7.38,1.8,0],[3.0,0.56,0],[7.56,3.64,0],[6.56,2.17,0],[0.22,3.22,0],[7.79,8.37,1],[3.49,8.47,1],[0.5,5.22,1],[2.57,4.39,0],[2.22,8.94,1],[3.02,9.45,1],[1.09,4.3,0],[4.43,7.09,1],[3.45,4.92,0],[0.7,3.11,0],[7.25,1.06,0],[4.63,2.37,0],[1.65,1.21,0],[8.14,6.87,1],[3.79,3.92,0],[7.28,6.04,1],[9.16,9.19,1],[4.82,6.59,1],[5.45,3.1,1],[4.54,7.21,1],[5.53,6.32,1],[4.87,9.53,1],[7.76,1.31,0],[8.14,9.18,1],[8.17,3.43,0],[3.68,2.43,0],[0.56,4.72,0],[8.5,7.69,1],[6.62,8.47,1],[6.59,2.23,0],[8.03,3.68,0],[8.9,3.26,0],[0.92,7.3,1],[1.08,8.7,1],[4.12,7.8,1],[0.53,5.44,0],[6.77,1.3,0],[6.08,1.43,0],[3.04,3.65,0],[6.2,1.3,0],[1.85,7.81,1],[7.16,4.54,1],[2.82,6.92,1],[4.68,3.12,0],[8.75,2.02,0],[8.04,6.18,0],[6.46,6.82,1],[7.48,8.81,1],[9.21,2.55,0],[1.64,8.96,1],[2.04,2.22,0],[8.05,9.66,1],[8.45,5.17,0],[3.76,9.89,1],[7.36,6.29,1],[0.11,1.95,0],[0.13,9.07,1],[2.36,1.71,0],[5.83,2.03,1],[5.47,9.5,1],[8.64,2.45,0],[9.16,3.99,0],[5.23,3.25,0],[10.0,3.07,0],[7.37,6.2,1],[6.89,1.04,0],[5.37,9.97,1],[5.63,1.97,0],[0.53,3.3,0],[7.46,0.25,0],[0.49,6.57,0],[8.82,4.39,0],[6.24,2.57,0],[2.73,4.75,0],[2.19,4.54,0],[1.48,9.24,1],[6.48,0.94,0],[1.93,8.29,1],[3.72,2.6,0],[0.23,6.75,1],[5.7,8.4,1],[1.7,7.52,1],[8.27,8.24,1],[7.46,4.42,1],[0.47,6.44,1],[0.26,0.86,0],[4.09,1.21,0],[4.52,8.51,1],[1.74,7.98,1],[9.98,0.37,0],[4.23,7.08,1],[7.32,2.8,0],[8.09,3.71,1],[2.01,5.18,0],[6.12,8.38,1],[6.64,0.83,0],[5.75,3.44,0],[7.05,0.45,0],[6.57,7.92,1],[0.4,0.15,0],[8.92,8.95,1],[1.77,9.22,1],[4.07,5.19,1],[4.71,3.35,1],[8.84,6.11,0],[9.32,6.22,0],[9.25,5.15,0],[4.75,5.71,1],[0.06,7.68,1],[1.4,9.44,1],[0.44,7.08,0],[7.69,5.42,0],[0.96,8.12,1],[3.21,2.88,0],[6.92,9.72,1],[0.96,4.36,0],[6.73,2.77,1],[9.25,6.03,0],[0.76,1.55,0],[1.43,4.56,0],[9.1,1.12,0],[1.51,2.12,0],[5.73,4.3,1],[4.18,1.45,0],[8.24,4.79,1],[8.66,0.3,0],[4.58,3.68,1],[8.41,6.92,0],[5.21,1.61,0],[6.83,8.96,1],[7.77,9.67,1],[5.91,3.14,1],[2.21,7.99,1],[8.12,6.35,0],[7.82,4.86,0],[8.52,6.95,1],[2.42,5.88,0],[6.56,2.03,0],[9.36,8.06,0],[1.45,2.2,0],[0.02,9.39,1],[1.74,8.34,1],[5.12,0.57,0],[2.11,2.58,0],[7.64,3.68,0],[1.42,9.46,1],[5.15,0.67,0],[9.73,6.75,0],[4.41,1.46,0],[6.93,0.97,0],[9.39,7.52,1],[7.13,7.7,1],[8.64,4.69,0],[8.12,1.1,0],[7.0,7.51,1],[2.11,1.11,0],[9.17,8.92,1],[1.1,5.89,0],[1.81,2.05,0],[9.29,6.63,0],[7.58,2.82,0],[7.76,6.69,1],[3.46,4.96,0],[2.49,5.95,0],[1.87,4.49,0],[8.55,6.58,1],[6.02,1.12,0],[8.22,6.2,1],[9.48,9.34,1],[9.32,5.34,0],[7.7,1.02,0],[0.45,7.86,1],[6.73,9.47,1],[3.04,4.95,0],[7.87,6.09,1],[8.49,3.95,0],[8.45,8.61,1],[9.03,3.98,0],[9.08,3.09,0],[5.94,9.8,1],[6.44,5.92,1],[3.61,5.14,0],[4.91,6.78,1],[5.4,3.18,0],[1.91,9.87,1],[6.19,1.73,0],[3.38,6.5,1],[2.39,8.95,1],[5.41,6.81,1],[6.64,1.62,0],[9.32,8.46,1],[1.46,5.7,0],[5.28,3.1,0],[3.75,2.59,0],[6.31,4.29,1],[1.0,2.27,0],[1.52,6.29,0],[5.54,3.93,1],[5.47,6.29,1],[2.17,0.56,0],[9.62,1.86,0],[2.42,7.04,1],[9.86,1.24,0],[4.02,8.56,1],[0.85,2.5,0],[6.14,8.29,1],[1.03,4.16,0],[5.92,5.47,1],[5.36,9.93,1],[9.84,2.1,0],[2.56,4.0,0],[1.01,1.46,0],[5.65,9.87,1],[2.94,1.98,0],[6.17,2.98,1],[0.14,0.94,0],[8.78,1.09,0],[6.41,4.19,1],[7.69,5.09,0],[2.31,2.11,0],[2.35,2.34,0],[2.51,2.99,0],[5.98,5.28,1],[0.69,4.21,0],[9.3,9.4,1],[3.2,1.56,0],[2.93,1.33,0],[2.59,9.25,1],[8.77,4.52,0],[5.5,7.01,1],[7.01,6.94,1],[7.36,5.91,1],[1.33,6.87,0],[6.69,1.62,0],[1.95,6.37,0],[3.86,8.11,1],[2.77,6.66,1],[6.15,1.11,1],[2.78,3.53,0],[3.02,0.91,0],[2.36,5.37,0],[2.26,6.36,0],[4.15,4.56,1],[2.07,7.87,1],[0.77,9.44,1],[5.89,9.44,1],[5.49,3.52,1],[3.7,9.29,1],[5.21,3.94,0],[1.56,1.52,0],[4.16,4.52,0],[8.04,1.22,0],[4.54,1.33,0],[2.54,4.93,0],[8.77,1.32,0],[1.74,7.06,0],[5.27,0.88,0],[6.81,9.58,1],[7.38,9.96,1],[7.43,3.29,1],[8.0,5.68,0],[0.91,3.62,0],[9.46,6.55,0],[3.7,7.09,1]]};
const SETS = {
small: {
tr: [[20,20,1],[25,30,1],[32,25,1],[38,35,1],[15,40,1],[30,58,1],[12,55,0],[22,60,0],[35,62,0],[28,48,0]],
te: [[18,35,1],[31,60,0],[26,45,0],[36,30,1],[40,50,1]],
x: [5, 60], y: [15, 70], xl: 'ingreso (miles $/mes)', yl: 'endeudamiento (%)', l1: 'pagó', l0: 'no pagó', kmax: 9
},
big: { tr: BIG.tr, te: BIG.te, x: [0, 10], y: [0, 10], xl: 'x₁', yl: 'x₂', l1: 'clase 1', l0: 'clase 0', kmax: 59 }
};
// Probabilidad real de la clase 1 en la muestra grande (permite calcular el error de Bayes).
const pTrue = (a, b) => 1 / (1 + Math.exp(-1.6 * (b - 5 - 2 * Math.sin(0.8 * a))));
const bayes = K.mean(BIG.te.map(p => { const q = pTrue(p[0], p[1]); return Math.min(q, 1 - q); }));
// Etiquetas de los vecinos ordenados por distancia (orden estable, como numpy kind='stable').
const order = (tr, a, b) => tr.map((p, i) => [(p[0] - a) ** 2 + (p[1] - b) ** 2, i])
.sort((u, v) => u[0] - v[0] || u[1] - v[1]).map(u => u[1]);
const vote = (tr, ord, k) => { let s = 0; for (let j = 0; j < k; j++) s += tr[ord[j]][2]; return s / k > 0.5 ? 1 : 0; };
const dataSeg = K.segmented($('#gen-data'), () => { syncControls(); render(); });
const showSeg = K.segmented($('#gen-show'), render);
function syncControls() {
const S = SETS[dataSeg.get()], kIn = $('#gen-k');
kIn.max = S.kmax;
if (+kIn.value > S.kmax) kIn.value = S.kmax;
$('#gen-n-wrap').style.display = dataSeg.get() === 'big' ? '' : 'none';
$('#gen-tab-wrap').style.display = dataSeg.get() === 'small' ? '' : 'none';
}
function render() {
const key = dataSeg.get(), S = SETS[key], k = +$('#gen-k').value;
const n = key === 'big' ? +$('#gen-n').value : S.tr.length;
const tr = S.tr.slice(0, n), te = S.te;
$('#gen-k-v').textContent = k;
$('#gen-n-v').textContent = n;
$('#gen-l1').textContent = S.l1; $('#gen-l0').textContent = S.l0;
const ordTr = tr.map(p => order(tr, p[0], p[1])), ordTe = te.map(p => order(tr, p[0], p[1]));
const err = (set, ords, kk) => set.filter((p, i) => vote(tr, ords[i], kk) !== p[2]).length;
const kmax = Math.min(S.kmax, n % 2 ? n : n - 1);
const ks = []; for (let kk = 1; kk <= kmax; kk += 2) ks.push(kk);
const curve = ks.map(kk => [kk, err(tr, ordTr, kk) / tr.length, err(te, ordTe, kk) / te.length]);
const eTr = err(tr, ordTr, k), eTe = err(te, ordTe, k);
const ones = tr.filter(p => p[2] === 1).length, maj = ones * 2 >= tr.length ? 1 : 0;
const eBase = te.filter(p => p[2] !== maj).length;
$('#gen-etr').textContent = `${eTr}/${tr.length} = ${K.fmt(eTr / tr.length, 3)}`;
$('#gen-ete').textContent = `${eTe}/${te.length} = ${K.fmt(eTe / te.length, 3)}`;
$('#gen-base').textContent = `${K.fmt(eBase / te.length, 3)} en prueba`;
$('#gen-bayes').textContent = key === 'big' ? K.fmt(bayes, 3) : 'desconocido';
// Regiones de decisión sobre una rejilla.
const c = K.chart($('#gen-svg'), { width: 380, height: 380, x: S.x, y: S.y, margin: { left: 46, right: 12, top: 12, bottom: 40 } });
const G = 46, dx = (S.x[1] - S.x[0]) / G, dy = (S.y[1] - S.y[0]) / G;
for (let i = 0; i < G; i++) for (let j = 0; j < G; j++) {
const a = S.x[0] + (i + 0.5) * dx, b = S.y[0] + (j + 0.5) * dy;
const cls = vote(tr, order(tr, a, b), k);
const r = c.rect(a - dx / 2, b - dy / 2, a + dx / 2, b + dy / 2, cls ? 's1' : 's2');
r.style.fillOpacity = 0.16; r.style.stroke = 'none';
}
c.axes({ xTicks: 5, yTicks: 5, xLabel: S.xl, yLabel: S.yl, grid: false, xFmt: v => K.fmt(v, 0) });
if (key === 'big') {
const fr = []; for (let a = 0; a <= 10.001; a += 0.1) fr.push([a, K.clamp(5 + 2 * Math.sin(0.8 * a), 0, 10)]);
c.path(fr, 's3 line dash');
}
const showTest = showSeg.get() === 'test', pts = showTest ? te : tr, ords = showTest ? ordTe : ordTr;
const rad = key === 'big' ? 3.6 : 6;
pts.forEach((p, i) => {
const wrong = vote(tr, ords[i], k) !== p[2];
const d = c.dot(p[0], p[1], rad, (p[2] ? 's1' : 's2') + ' dot');
if (wrong) { d.style.stroke = 'var(--lab-text)'; d.style.strokeWidth = 2.2; }
});
if (key === 'small') {
pts.forEach((p, i) => c.text(p[0], p[1], showTest ? 'ABCDE'[i] : String(i + 1), { dx: 8, dy: -6, class: 'strong' }));
}
// Curva de error frente a k.
const ymax = Math.max(0.3, ...curve.map(u => Math.max(u[1], u[2]))) * 1.08;
const cc = K.chart($('#gen-curve'), { width: 380, height: 260, x: [0, kmax + 1], y: [0, ymax], margin: { left: 46, bottom: 40 } });
cc.axes({ xTicks: 6, yTicks: 5, xLabel: 'k (vecinos)', yLabel: 'error', xFmt: v => K.fmt(v, 0), yFmt: v => K.fmt(v, 2) });
if (key === 'big') { cc.line(0, bayes, kmax + 1, bayes, 's3 line dash thin'); }
cc.path(curve.map(u => [u[0], u[1]]), 's1 line');
cc.path(curve.map(u => [u[0], u[2]]), 's4 line');
cc.dot(k, eTe / te.length, 6, 's2 dot');
cc.dot(k, eTr / tr.length, 4, 's2 dot');
// Tabla del ejemplo de diez clientes.
if (key === 'small') {
$('#gen-tab').innerHTML = '<table class="plab-table"><thead><tr><th>Cliente</th><th>Ingreso</th><th>Deuda</th><th>Vecinos (más cercano primero)</th><th>Predicción</th><th>Real</th></tr></thead><tbody>' +
te.map((p, i) => {
const o = ordTe[i].slice(0, k), pr = vote(tr, ordTe[i], k);
return `<tr${pr !== p[2] ? ' class="hl"' : ''}><td>${'ABCDE'[i]}</td><td>${p[0]}</td><td>${p[1]}</td><td>${o.map(j => `${j + 1} (${K.fmt(Math.hypot(tr[j][0] - p[0], tr[j][1] - p[1]), 2)})`).join(', ')}</td><td>${pr ? 'sí' : 'no'}</td><td>${p[2] ? 'sí' : 'no'}</td></tr>`;
}).join('') + '</tbody></table><p class="plab-sub" style="margin:.4rem 0 0">Entre paréntesis, la distancia euclidiana. Resaltadas: predicciones erróneas.</p>';
}
// Retroalimentación.
const best = curve.reduce((b, u) => u[2] < b[2] ? u : b, curve[0]);
const note = $('#gen-note');
if (eTr === 0 && k === 1) {
note.className = 'plab-note warn';
note.textContent = `Con k = 1 el error de entrenamiento es 0: cada punto es su propio vecino más cercano. El error de prueba (${K.fmt(eTe / te.length, 3)}) muestra lo que realmente se aprendió. La frontera rodea incluso los puntos aislados: el modelo memoriza el ruido.`;
} else if (key === 'big' && k >= 39) {
note.className = 'plab-note warn';
note.textContent = `Con k = ${k} la frontera es demasiado suave: ambos errores suben (entrenamiento ${K.fmt(eTr / tr.length, 3)}, prueba ${K.fmt(eTe / te.length, 3)}). El modelo ya no sigue la curva real: subajuste.`;
} else {
note.className = 'plab-note good';
note.textContent = `Error de prueba ${K.fmt(eTe / te.length, 3)} frente a ${K.fmt(eTr / tr.length, 3)} en entrenamiento.` +
(key === 'big' ? ` El error de Bayes (${K.fmt(bayes, 3)}) es el mínimo posible; en esta muestra de prueba, el menor error de k-NN se alcanza con k = ${best[0]} (${K.fmt(best[2], 3)}). Ojo: elegir k mirando la prueba es hacer trampa; el capítulo de validación muestra cómo elegirlo sin tocarla.` : ' Con diez clientes, un solo caso cambia mucho el resultado.');
}
}
root.querySelectorAll('input[type=range]').forEach(el => el.addEventListener('input', render));
syncControls();
render();
})();
</script>
```
:::
::: {.content-visible when-format="pdf"}
En la versión web, este laboratorio muestra las regiones de decisión de $k$-NN y los errores de entrenamiento y prueba en función de $k$. Valores de referencia. *Diez clientes*: con $k = 1$, error de entrenamiento 0/10 y de prueba 2/5; con $k = 3$, 1/10 y 2/5. *Muestra grande* (120 puntos de entrenamiento, 400 de prueba, error de Bayes ≈ 0.092): con $k = 1$ el error de entrenamiento es 0 y el de prueba 0.138; con $k = 5$, 0.083 y 0.110 (el mínimo de prueba); con $k = 59$, 0.158 y 0.183.
:::
**Guía del laboratorio.**
1. Con *Diez clientes* y $k = 1$, comprueba la @tbl-prueba: ¿qué vecino decide la predicción del cliente B? ¿A qué distancia está?
2. Predice antes de mover: con $k = 3$, ¿cambia la predicción de B? ¿Y la de C? Compruébalo en la tabla y explica por qué C empeora.
3. Cambia a *Muestra grande* con $k = 1$ y alterna entre *Entrenamiento* y *Prueba*. ¿Por qué no hay puntos con borde grueso en entrenamiento?
4. Recorre $k$ de 1 a 59. Localiza la U del error de prueba y el valor de $k$ donde se alcanza el mínimo. ¿Qué tan lejos queda del error de Bayes?
5. Con $k = 5$, baja el tamaño de entrenamiento a 20. ¿Qué le pasa a la frontera y al error de prueba? ¿Dónde está ahora el mínimo de la curva?
6. Explica con tus palabras por qué el error de entrenamiento casi siempre crece con $k$, mientras que el de prueba no.
## El flujo de trabajo de un clasificador
Las lecciones anteriores se convierten en un procedimiento que seguiremos en todos los capítulos:
1. **Definir la clase positiva, la métrica y la referencia.** ¿Qué error es más costoso? ¿Cuánto acierta responder siempre la clase mayoritaria? Las métricas se estudian en el capítulo siguiente sobre evaluación.
2. **Separar datos de prueba antes de cualquier otra cosa.** El conjunto de prueba se guarda y se usa **una sola vez**, al final.
3. **Preparar las predictoras dentro de un *pipeline*.** Imputación, escalado y codificación se ajustan solo con el entrenamiento y se aplican después a la prueba, para evitar la **fuga de datos**[^fuga].
4. **Elegir hiperparámetros con validación**, nunca con la prueba: se reserva una parte del entrenamiento (validación) o se usa validación cruzada.
5. **Comparar con la referencia y con un modelo simple.** Un modelo complejo debe justificar su costo frente a uno interpretable.
6. **Evaluar una sola vez en prueba y reportar** la métrica junto con su incertidumbre.
```{mermaid}
%%| label: fig-flujo-clasificacion
%%| fig-cap: "Flujo de trabajo. El conjunto de prueba se separa al inicio y solo se usa en la evaluación final."
%%| echo: false
flowchart TD
    D[Datos etiquetados] --> E[Entrenamiento]
    D --> P[Prueba: se guarda]
    E --> V[Validación cruzada: elegir modelo e hiperparámetros]
    V --> F[Ajuste final con todo el entrenamiento]
    F --> R[Evaluación única en prueba]
    P --> R
```
## Un mapa de los clasificadores de esta parte
| Familia | Idea | Frontera típica | Interpretabilidad | Capítulo |
|---|---|---|---|---|
| Vecinos cercanos | Responder como los casos más parecidos | Poligonal, muy flexible | Media (por ejemplos) | Vecinos más cercanos |
| Árboles de decisión | Preguntas sucesivas que parten los datos | Escalones paralelos a los ejes | Alta (reglas) | Árboles (ID3), CART |
| Ensambles | Combinar muchos árboles | Escalones finos, casi suave | Baja (requiere SHAP) | Ensambles, XGBoost |
| Modelos lineales | Puntaje lineal $\mathbf{w}^\top\mathbf{x} + b$ | Recta o hiperplano | Alta (coeficientes) | Lineales, logística |
| Máquinas de soporte vectorial | Margen máximo, núcleos | Hiperplano o curva (con núcleo) | Media | SVM |
| Probabilísticos | Modelar $p(\mathbf{x} \mid c)$ y aplicar Bayes | Lineal o cuadrática | Alta | Bayesianos, GMM |
| Redes neuronales | Composición de transformaciones no lineales | Curva arbitraria | Baja | Redes, PyTorch y JAX |
: Familias de clasificadores estudiadas en esta parte. {#tbl-mapa-clasificadores}
No existe un clasificador que sea el mejor en todos los problemas[^nfl]. Por eso el método importa más que el algoritmo: definir bien la métrica, validar sin fugas y comparar contra referencias.
**Más de dos clases.** Algunos clasificadores (árboles, vecinos, Naive Bayes, regresión logística multinomial, redes) manejan $K > 2$ clases de forma natural. Otros son binarios por diseño y se extienden con dos estrategias: **uno contra el resto** (OvR), que entrena $K$ clasificadores «clase $c$ contra todas las demás» y elige el de mayor puntaje, y **uno contra uno** (OvO), que entrena $K(K-1)/2$ clasificadores por pares y decide por votación. `scikit-learn` aplica estas estrategias automáticamente cuando hace falta.
## Implementación en Python
### La interfaz de `scikit-learn`
Todos los clasificadores de `scikit-learn` comparten la misma interfaz [@pedregosa2011]: se crean con sus hiperparámetros, se ajustan con `fit(X, y)` y predicen con `predict(X)`. Muchos ofrecen además `predict_proba(X)`, la probabilidad estimada de cada clase, y `score(X, y)`, la exactitud. Reproducimos la @tbl-resumen-intro con cuatro clasificadores: `DummyClassifier` es la referencia, un árbol de profundidad 1 es el tocón y `KNeighborsClassifier` es $k$-NN.
```{python}
#| label: intro-sklearn-manual
from sklearn.dummy import DummyClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier

X_tr, y_tr = clientes[["ingreso", "deuda"]], clientes["paga"]
X_te, y_te = nuevos[["ingreso", "deuda"]], nuevos["paga"]

modelos = {
    "Referencia (mayoritaria)": DummyClassifier(strategy="most_frequent"),
    "Tocón (árbol de profundidad 1)": DecisionTreeClassifier(max_depth=1, random_state=0),
    "1-NN": KNeighborsClassifier(n_neighbors=1),
    "3-NN": KNeighborsClassifier(n_neighbors=3),
}
filas = []
for nombre, modelo in modelos.items():
    modelo.fit(X_tr, y_tr)
    filas.append({"clasificador": nombre,
                  "exactitud entrenamiento": modelo.score(X_tr, y_tr),
                  "exactitud prueba": modelo.score(X_te, y_te),
                  "predicciones A–E": "".join("S" if p else "N" for p in modelo.predict(X_te))})
pd.DataFrame(filas)
```
El árbol de profundidad 1 encontró el mismo corte que calculamos a mano. Lo podemos leer directamente:
```{python}
#| label: intro-tocon
from sklearn.tree import export_text
print(export_text(modelos["Tocón (árbol de profundidad 1)"], feature_names=["ingreso", "deuda"]))
```
El método `predict_proba` de 3-NN devuelve la proporción de vecinos de cada clase. Para el cliente B, dos de sus tres vecinos no pagaron:
```{python}
#| label: intro-proba
proba = modelos["3-NN"].predict_proba(X_te)
pd.DataFrame(proba, index=nuevos.index, columns=["P(no paga)", "P(paga)"]).round(3)
```
### La curva de complejidad con la muestra grande
Generamos los mismos datos que usa el laboratorio. La probabilidad real de la clase 1 depende de una frontera curva, $x_2 = 5 + 2\sin(0.8\,x_1)$, y se suaviza con una función logística; así las clases se traslapan cerca de la frontera y el error de Bayes no es cero.
```{python}
#| label: intro-muestra-grande
def prob_clase1(X):
    return 1 / (1 + np.exp(-1.6 * (X[:, 1] - 5 - 2 * np.sin(0.8 * X[:, 0]))))

def generar(n, semilla):
    rng = np.random.default_rng(semilla)
    X = rng.uniform(0, 10, size=(n, 2)).round(2)
    y = (rng.uniform(size=n) < prob_clase1(X)).astype(int)
    return X, y

X_big, y_big = generar(120, semilla=1)        # entrenamiento
X_test, y_test = generar(400, semilla=2)      # prueba

p_real = prob_clase1(X_test)
error_bayes = np.minimum(p_real, 1 - p_real).mean()
print(f"Error de Bayes estimado en la muestra de prueba: {error_bayes:.3f}")
```
```{python}
#| label: fig-curva-complejidad
#| fig-cap: "Error de entrenamiento y de prueba de k-NN según el número de vecinos. El error de entrenamiento crece con k; el de prueba dibuja una U con mínimo cerca de k = 5. La línea verde es el error de Bayes, el mínimo alcanzable por cualquier clasificador."
import plotly.graph_objects as go

ks = list(range(1, 60, 2))
err_tr, err_te = [], []
for k in ks:
    knn = KNeighborsClassifier(n_neighbors=k, algorithm="brute").fit(X_big, y_big)
    err_tr.append(1 - knn.score(X_big, y_big))
    err_te.append(1 - knn.score(X_test, y_test))

fig = go.Figure()
fig.add_trace(go.Scatter(x=ks, y=err_tr, name="entrenamiento", mode="lines+markers", line=dict(color="#2563eb")))
fig.add_trace(go.Scatter(x=ks, y=err_te, name="prueba", mode="lines+markers", line=dict(color="#7c3aed")))
fig.add_hline(y=error_bayes, line=dict(color="#16a34a", dash="dash"), annotation_text="error de Bayes")
fig.update_layout(xaxis_title="k (número de vecinos)", yaxis_title="error de clasificación",
                  height=380, margin=dict(l=10, r=10, t=20, b=40), legend=dict(x=0.02, y=0.98))
fig.show()
```
```{python}
#| label: fig-fronteras-k
#| fig-cap: "Regiones de decisión de k-NN con k = 1, 5 y 59 sobre los 120 puntos de entrenamiento. La curva negra es la frontera del clasificador de Bayes. Con k = 1 la frontera rodea puntos aislados (sobreajuste); con k = 59 es demasiado suave (subajuste)."
from matplotlib.colors import ListedColormap

g1, g2 = np.meshgrid(np.linspace(0, 10, 200), np.linspace(0, 10, 200))
malla = np.c_[g1.ravel(), g2.ravel()]
fig, ejes = plt.subplots(1, 3, figsize=(12, 4.2), sharey=True)
for ax, k in zip(ejes, [1, 5, 59]):
    knn = KNeighborsClassifier(n_neighbors=k, algorithm="brute").fit(X_big, y_big)
    zona = knn.predict(malla).reshape(g1.shape)
    ax.contourf(g1, g2, zona, levels=[-0.5, 0.5, 1.5], cmap=ListedColormap(["#fde2cf", "#dbe6fd"]))
    ax.scatter(X_big[:, 0], X_big[:, 1], c=np.where(y_big == 1, "#2563eb", "#ea580c"), s=16, edgecolor="white", lw=0.4)
    x1 = np.linspace(0, 10, 200)
    ax.plot(x1, 5 + 2 * np.sin(0.8 * x1), c="black", lw=1.4)
    ax.set(title=f"k = {k}   (prueba: {1 - knn.score(X_test, y_test):.3f})", xlabel="$x_1$", xlim=(0, 10), ylim=(0, 10))
ejes[0].set_ylabel("$x_2$")
plt.tight_layout()
plt.show()
```
Los números coinciden con el laboratorio: el mínimo del error de prueba está en $k = 5$ con 0.110, todavía unos dos puntos porcentuales por encima del error de Bayes. Esa diferencia se debe a que 120 puntos son una muestra finita; con más datos, $k$-NN se acerca al clasificador de Bayes[^consistencia].
## Resumen
- Un clasificador asigna una de $K$ clases a cada vector de predictoras; se entrena con ejemplos etiquetados y se juzga por su error en ejemplos nuevos.
- Toda evaluación debe compararse con la **referencia** de la clase mayoritaria.
- El error de entrenamiento es optimista. El error de prueba, sobre datos que no participaron en ninguna decisión, es la estimación honesta del riesgo.
- El **clasificador de Bayes** elige la clase más probable dada $\mathbf{x}$; su error es el mínimo posible y no es cero cuando las clases se traslapan.
- La complejidad se controla con hiperparámetros. Poca complejidad produce **subajuste** (sesgo); demasiada, **sobreajuste** (varianza). El error de prueba dibuja una U.
El siguiente capítulo estudia a fondo el primer clasificador que usamos aquí, los $k$ vecinos más cercanos: cómo medir la distancia, por qué hay que escalar las variables y qué ocurre cuando hay muchas dimensiones.
[^baseline]: Con clases muy desbalanceadas la referencia es engañosamente alta: si el 97 % de las transacciones son legítimas, «nunca hay fraude» acierta el 97 %. Por eso el capítulo de métricas introduce medidas que no se dejan engañar por el desbalance.
[^distancia]: La **distancia euclidiana** entre $\mathbf{a}$ y $\mathbf{b}$ es $\sqrt{\sum_j (a_j - b_j)^2}$, la longitud del segmento que los une. Aquí las dos variables tienen rangos parecidos; cuando no es así, hay que escalarlas primero, como se explica en el capítulo de vecinos cercanos.
[^esperanza]: La **esperanza** $\mathbb{E}[\cdot]$ es el promedio de una cantidad sobre todos los casos posibles, ponderado por su probabilidad. El riesgo es, entonces, la proporción de errores que cometería el clasificador sobre la población completa, de la cual nuestros datos son solo una muestra.
[^condicional]: $P(y = c \mid \mathbf{x})$ es una **probabilidad condicional**: la proporción de casos de clase $c$ entre todos los que tienen exactamente las predictoras $\mathbf{x}$. Por ejemplo, entre todos los clientes con ingreso 30 y endeudamiento 58, la fracción que paga.
[^generativo]: Un modelo **generativo** aprende la distribución conjunta $p(\mathbf{x}, y) = p(\mathbf{x} \mid y)\,P(y)$ y con ella podría simular datos nuevos de cada clase; luego clasifica con el teorema de Bayes. Un modelo **discriminativo** solo aprende lo necesario para separar las clases. Los primeros funcionan bien con pocos datos si sus supuestos son correctos; los segundos suelen ganar con muchos datos.
[^hiperparametro]: Un **hiperparámetro** es una opción del algoritmo que se fija antes de entrenar ($k$, profundidad máxima, tasa de aprendizaje). Los **parámetros**, en cambio, los aprende el algoritmo a partir de los datos (los coeficientes de un modelo lineal, los cortes de un árbol).
[^sesgo-varianza]: Formalmente, el **sesgo** mide cuánto se aleja la predicción *promedio* (sobre muchas muestras de entrenamiento posibles) de la predicción del clasificador de Bayes, y la **varianza** mide cuánto fluctúa la predicción de una muestra a otra. Para la pérdida cuadrática la descomposición es exacta; para la pérdida 0-1 es solo aproximada, pero la intuición es la misma [@hastie2009].
[^fuga]: La **fuga de datos** (*data leakage*) ocurre cuando información del conjunto de prueba influye en el entrenamiento, por ejemplo al escalar con la media de todos los datos. El resultado es una evaluación optimista que no se sostiene en producción.
[^nfl]: Este resultado se conoce como el teorema de **no hay almuerzo gratis** (*no free lunch*) [@wolpert1996lack]: promediado sobre todos los problemas posibles, ningún algoritmo de aprendizaje supera a otro. Un algoritmo gana en un problema concreto porque sus supuestos encajan con la estructura de ese problema.
[^consistencia]: Se dice que $k$-NN es **consistente**: si $n \to \infty$ y $k \to \infty$ con $k/n \to 0$, su error converge al error de Bayes [@stone1977consistent]. En la práctica, la velocidad de esa convergencia empeora rápidamente con el número de variables.
## Referencias {.unnumbered}
::: {#refs}
:::