Entorno listo.65 Implementación Práctica: PyTorch y JAX
En el capitulo anterior construimos redes neuronales desde cero con NumPy: derivamos la regla de la cadena a mano, escribimos cada operación de convolución a mano y controlamos cada actualización de pesos. Ese ejercicio es indispensable para entender por qué funcionan los algoritmos.
Este capitulo es el complemento práctico. Tomamos exactamente los mismos conceptos — forward pass, backprop, descenso por gradiente — y los reimplementamos en frameworks de producción que automatizan lo que ya entendemos.
Hay tres alternativas principales según el nivel de abstracción:
- scikit-learn — Un
MLPClassifiercon la interfazfit/predictde siempre. Ideal para tablas pequeñas; sin control sobre el ciclo de entrenamiento. - PyTorch (Paszke et al. 2019) — Grafos computacionales dinámicos, diferenciación automática y una API orientada a objetos. El estándar de facto en investigación académica.
- JAX (Bradbury et al. 2018) — Paradigma funcional puro: funciones sin estado, PRNG explícito, compilación XLA transparente. Sobre JAX se construye Flax (Heek et al. 2023) (módulos de redes) y Optax (DeepMind et al. 2020) (optimizadores).
La diferencia entre PyTorch y JAX no es solo sintáctica: reflejan dos paradigmas de programación opuestos. PyTorch es imperativo — escribes instrucciones sobre objetos con estado. JAX es funcional — las funciones no tienen estado y se pueden transformar automáticamente. Comprender esta diferencia es el objetivo central de este capítulo.
1 El ecosistema de aprendizaje profundo
1.1 scikit-learn: MLPClassifier
Scikit-learn (Pedregosa et al. 2011) incluye sklearn.neural_network.MLPClassifier, un perceptrón multicapa que se integra sin fricciones en cualquier pipeline de sklearn. Acepta los mismos hiperparámetros conceptuales que ya conocemos: número y tamaño de capas ocultas (hidden_layer_sizes), función de activación, optimizador (lbfgs, sgd o adam) y tasa de aprendizaje. La interfaz es idéntica a la de cualquier otro clasificador de sklearn: fit para entrenar, predict para inferencia y score para exactitud. Esta uniformidad hace que sea trivial sustituirlo por un árbol de decisión o una SVM en un experimento comparativo.
Las limitaciones son igualmente claras. No permite definir arquitecturas personalizadas: capas convolucionales, mecanismos de atención, conexiones residuales o cualquier topología no secuencial están fuera de alcance. El entrenamiento ocurre en CPU y no escala a conjuntos de datos de imagen o texto de tamaño real. La ausencia de control sobre el ciclo de entrenamiento impide aplicar técnicas avanzadas como curriculum learning, ciclos de tasa de aprendizaje o pérdidas compuestas. Para todo esto se requieren frameworks de bajo nivel.
from sklearn.neural_network import MLPClassifier
from sklearn.datasets import make_moons
import numpy as np
X, y = make_moons(n_samples=400, noise=0.2, random_state=42)
clf = MLPClassifier(hidden_layer_sizes=(16, 16), max_iter=500, random_state=42)
clf.fit(X, y)
print(f"Accuracy: {clf.score(X, y):.3f}")1.2 PyTorch
PyTorch (Paszke et al. 2019) introdujo en 2017 el grafo computacional dinámico (define-by-run): el grafo se construye al vuelo mientras se ejecutan operaciones sobre tensores, no antes. A diferencia del grafo estático de TensorFlow 1.x, el código de PyTorch es Python normal — se puede depurar con print y pdb, y las estructuras de control funcionan exactamente como se esperaría.
El motor de diferenciación automática se llama Autograd. Cuando un tensor tiene requires_grad=True, cada operación sobre él registra un nodo en el grafo. Al llamar .backward() sobre la pérdida escalar, Autograd recorre el grafo en sentido inverso y acumula los gradientes en el atributo .grad de cada parámetro.
La clase base para todo modelo es nn.Module. Su contrato: el constructor __init__ declara las capas, y el método forward describe el cómputo. El ciclo de entrenamiento es explícito — el programador escribe cada paso. Esa explicitación es una característica, no un defecto: da control total.
1.3 JAX
JAX (Bradbury et al. 2018) parte de una premisa diferente: las transformaciones funcionales son ciudadanos de primera clase. El núcleo son cuatro transformaciones componibles:
| Transformación | Qué hace |
|---|---|
jax.grad(f) |
Diferenciación automática de funciones escalares |
jax.jit(f) |
Compilación XLA transparente |
jax.vmap(f) |
Vectorización sobre dimensiones de lote |
jax.pmap(f) |
Paralelismo en múltiples dispositivos |
Para beneficiarse de jax.jit, las funciones deben ser puras: sin efectos secundarios, sin estado global mutable. Los pesos del modelo se pasan como pytrees (diccionarios/listas de arrays JAX) que JAX recorre automáticamente.
Flax (Heek et al. 2023) añade una API de módulos similar a nn.Module, manteniendo la disciplina funcional: model.init(key, x) devuelve los parámetros y model.apply(params, x) ejecuta el forward pass sin modificar nada internamente. Optax (DeepMind et al. 2020) provee los optimizadores.
1.4 Comparativa de frameworks
La elección entre frameworks depende del caso de uso. Para prototipado rápido con datos tabulares, sklearn es imbatible en simplicidad. Para investigación en arquitecturas novedosas o fine-tuning de modelos preentrenados del ecosistema HuggingFace, PyTorch es el estándar de facto. Para investigación que requiere transformaciones funcionales, diferenciación de orden superior o integración nativa con TPUs de Google, JAX es la opción más poderosa. El siguiente radar resume estas características de forma comparativa.
Mostrar código
import plotly.graph_objects as go
categories = [
"Facilidad de uso",
"Flexibilidad",
"Velocidad de prototipado",
"Escalabilidad",
"Soporte para investigacion"
]
frameworks = {
"scikit-learn": {"scores": [5, 2, 5, 2, 1], "color": "rgba(99,110,250,0.6)"},
"PyTorch": {"scores": [3, 5, 4, 5, 5], "color": "rgba(239,85,59,0.6)"},
"JAX": {"scores": [2, 5, 3, 5, 5], "color": "rgba(0,204,150,0.6)"},
}
fig = go.Figure()
for name, data in frameworks.items():
scores = data["scores"] + [data["scores"][0]]
cats = categories + [categories[0]]
fig.add_trace(go.Scatterpolar(
r=scores,
theta=cats,
fill="toself",
name=name,
line_color=data["color"],
fillcolor=data["color"],
opacity=0.7
))
fig.update_layout(
polar=dict(
radialaxis=dict(visible=True, range=[0, 5], tickfont=dict(size=10)),
angularaxis=dict(tickfont=dict(size=11))
),
showlegend=True,
title=dict(
text="Comparativa de frameworks de aprendizaje profundo",
x=0.5,
font=dict(size=15)
),
legend=dict(orientation="h", yanchor="bottom", y=-0.15, xanchor="center", x=0.5),
height=480,
margin=dict(t=60, b=80)
)
fig.show()2 Dataset a explorar
Para los siguientes ejemplos utilizaremos el conocido dataset make_moons, un clásico para ilustrar clasificadores no lineales.
from sklearn.datasets import make_moons
X, y = make_moons(n_samples=600, noise=0.25, random_state=SEED)
plt.scatter(X[:,0],X[:,1], c = y, cmap=plt.cm.Spectral)
plt.title("Make Moons Dataset")Text(0.5, 1.0, 'Make Moons Dataset')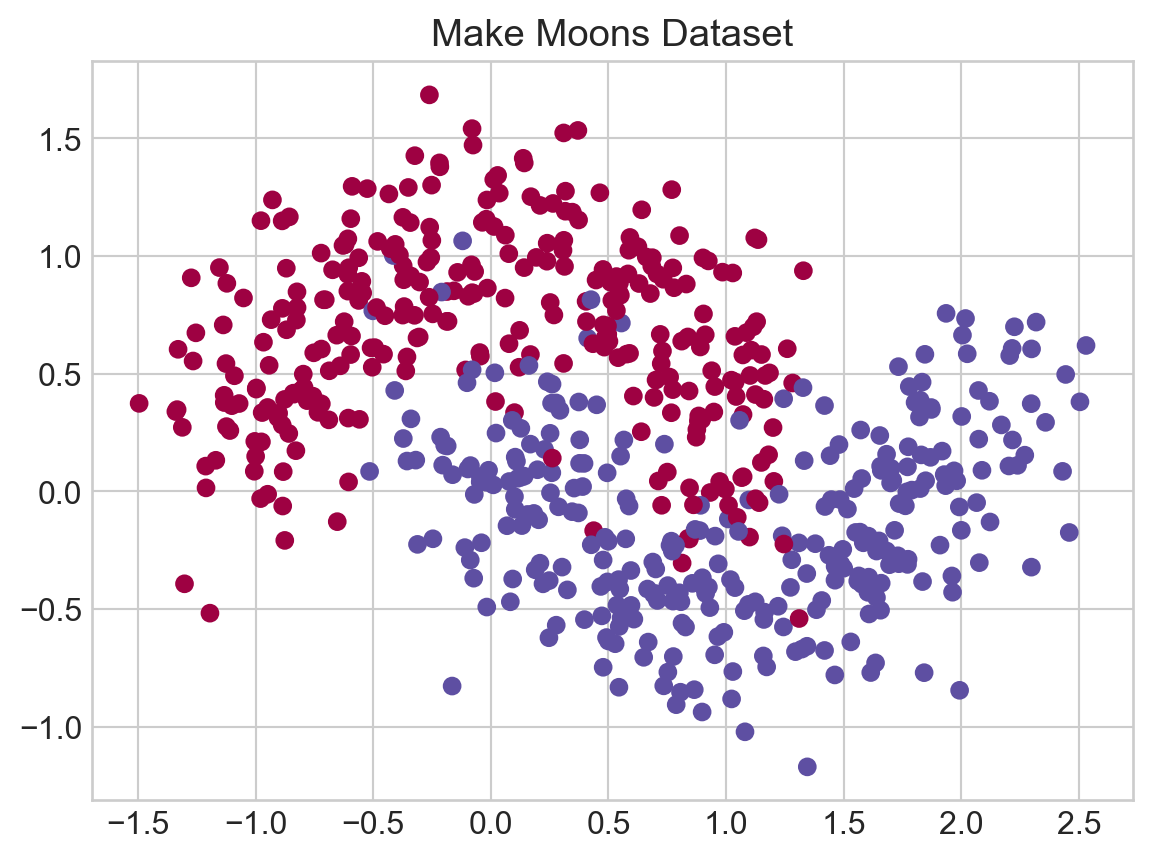
3 Preparación de datos
Antes de entrenar con PyTorch o JAX, los datos deben dividirse en conjuntos de entrenamiento y validación, y convertirse al formato esperado por cada framework.
3.1 Train-test split
Una partición típica es 80% entrenamiento, 20% validación, con la misma semilla aleatoria para reproducibilidad.
Mostrar código
from sklearn.model_selection import train_test_split
X_train, X_val, y_train, y_val = train_test_split(
X, y,
test_size=0.2,
random_state=SEED,
stratify=y
)
print(f"Entrenamiento: {X_train.shape[0]} muestras")
print(f"Validacion: {X_val.shape[0]} muestras")
print(f"Clases en train: {np.bincount(y_train)}")
print(f"Clases en val: {np.bincount(y_val)}")Entrenamiento: 480 muestras
Validacion: 120 muestras
Clases en train: [240 240]
Clases en val: [60 60]3.2 Comparativa: sklearn MLPClassifier
Como punto de partida, entrenemos un MLP de sklearn sobre el mismo dataset. Este es el clasificador “caja negra” que posteriormente comparamos con PyTorch y JAX.
Mostrar código
from sklearn.neural_network import MLPClassifier
clf_sk = MLPClassifier(
hidden_layer_sizes=(32, 32),
max_iter=500,
random_state=SEED
)
clf_sk.fit(X_train, y_train)
sklearn_train_acc = clf_sk.score(X_train, y_train)
sklearn_val_acc = clf_sk.score(X_val, y_val)
print(f"sklearn MLP | Train acc: {sklearn_train_acc:.3f} | Val acc: {sklearn_val_acc:.3f}")sklearn MLP | Train acc: 0.954 | Val acc: 0.933La ventaja de sklearn es la sencillez: una linea para instanciar, una linea para entrenar, una linea para predecir. La desventaja es que no vemos las curvas de convergencia ni tenemos control sobre el ciclo de entrenamiento.
4 PyTorch: fundamentos
4.1 Tensores y autograd
Los tensores de PyTorch son analogos a los arrays de NumPy: admiten las mismas operaciones aritméticas, indexación y broadcasting. La diferencia fundamental es que un tensor puede residir en GPU (mediante .to("cuda")) y puede tener activado el rastreo de gradientes mediante requires_grad=True.
¿Que significa “rastreo de gradientes”? Cuando estableces requires_grad=True en un tensor, PyTorch comienza a registrar cada operación que le aplicas. Cada operación crea un nodo en un grafo computacional, junto con la función que permitira calcular el gradiente local cuando sea necesario. Es como dejar un rastro de “breadcrumbs” a través de tus cálculos.
El ciclo de gradientes: backward() y accumulation.
Para un parámetro \(\theta\) y una pérdida escalar \(\mathcal{L}\), la llamada loss.backward() computa todos los gradientes simultaneamente:
\[ \frac{\partial \mathcal{L}}{\partial \theta} \quad \forall \theta \text{ con } \texttt{requires\_grad=True} \tag{1}\]
El gradiente resultante se almacena en theta.grad.
Atrapas y detalles implementación: .backward() no reemplaza el gradiente en .grad; acumula (suma). Esto significa que si llamas .backward() dos veces sin limpiar gradientes intermedios, los valores se suman:
# Ejemplo: acumulacion no intencional
w = torch.tensor([2.0], requires_grad=True)
loss1 = w ** 2
loss1.backward()
print(w.grad) # tensor([4.0]) ← 2*w en w=2
loss2 = w ** 3
loss2.backward()
print(w.grad) # tensor([16.0]) ← 4 + 3*w^2 = 4 + 12 = 16Por eso cada ciclo de entrenamiento debe llamar optimizer.zero_grad() antes de .backward(). Sin esta linea, el gradiente del epoch \(t\) se sumaría al del epoch \(t-1\), produciendo actualizaciones completamente incorrectas que oscilan sin convergencia.
La regla de la cadena, automatizada.
Para funciones compuestas, Autograd aplica la regla de la cadena automáticamente. Consideremos:
\[z = (w \cdot x + b)^2 \quad \text{y} \quad \mathcal{L} = z\]
El gradiente respecto a \(w\) es: \[\frac{\partial \mathcal{L}}{\partial w} = \frac{\partial \mathcal{L}}{\partial z} \cdot \frac{\partial z}{\partial (wx+b)} \cdot \frac{\partial (wx+b)}{\partial w} = 1 \cdot 2(wx + b) \cdot x = 2(wx + b) \cdot x\]
Autograd calcula esto recorriendo el grafo en sentido inverso, aplicando la regla de la cadena nodo a nodo. La siguiente figura ilustra este grafo para valores concretos \(w = 0.5\), \(x = 2.0\), \(b = 0.3\).
Mostrar código
import plotly.graph_objects as go
import numpy as np
# Node positions (x, y)
nodes = {
"x": (0.0, 2.0),
"w": (0.0, 0.0),
"b": (0.0, 4.0),
"mul": (1.5, 1.0),
"add": (3.0, 2.0),
"sq": (4.5, 2.0),
"L": (6.0, 2.0),
}
node_labels = {
"x": "x = 2.0",
"w": "w = 0.5",
"b": "b = 0.3",
"mul": "w*x = 1.0",
"add": "z1 = 1.3",
"sq": "z = 1.69",
"L": "L = 1.69",
}
# Forward edges: (from, to)
forward_edges = [
("x", "mul"),
("w", "mul"),
("mul", "add"),
("b", "add"),
("add", "sq"),
("sq", "L"),
]
# Backward annotations: (edge, formula)
backward_annots = [
(("x", "mul"), "dL/dx = 2z1*w = 1.3"),
(("w", "mul"), "dL/dw = 2z1*x = 2.6"),
(("b", "add"), "dL/db = 2z1 = 2.6"),
(("mul", "add"),"dL/dmul = 2z1 = 2.6"),
(("add", "sq"), "dL/dadd = 2z1 = 2.6"),
(("sq", "L"), "dL/dsq = 1"),
]
fig = go.Figure()
# Draw forward edges (black arrows)
for (src, dst) in forward_edges:
x0, y0 = nodes[src]
x1, y1 = nodes[dst]
fig.add_annotation(
x=x1, y=y1, ax=x0, ay=y0,
xref="x", yref="y", axref="x", ayref="y",
showarrow=True,
arrowhead=3, arrowsize=1.3, arrowwidth=2,
arrowcolor="black"
)
# Draw backward gradient annotations (orange dashed)
for ((src, dst), formula) in backward_annots:
x0, y0 = nodes[src]
x1, y1 = nodes[dst]
# midpoint for label
mx = (x0 + x1) / 2
my = (y0 + y1) / 2 - 0.35
fig.add_annotation(
x=x0, y=y0, ax=x1, ay=y1,
xref="x", yref="y", axref="x", ayref="y",
showarrow=True,
arrowhead=2, arrowsize=1.1, arrowwidth=1.5,
arrowcolor="orange",
opacity=0.85
)
fig.add_annotation(
x=mx, y=my,
text=formula,
showarrow=False,
font=dict(size=8, color="darkorange"),
bgcolor="rgba(255,255,220,0.8)",
bordercolor="orange",
borderwidth=1
)
# Draw nodes
node_x = [v[0] for v in nodes.values()]
node_y = [v[1] for v in nodes.values()]
node_text = [node_labels[k] for k in nodes.keys()]
fig.add_trace(go.Scatter(
x=node_x, y=node_y,
mode="markers+text",
marker=dict(size=42, color="steelblue", line=dict(color="white", width=2)),
text=node_text,
textposition="top center",
textfont=dict(size=9),
hoverinfo="none"
))
# Legend items (manual)
fig.add_trace(go.Scatter(
x=[None], y=[None], mode="lines",
line=dict(color="black", width=2),
name="Forward pass"
))
fig.add_trace(go.Scatter(
x=[None], y=[None], mode="lines",
line=dict(color="orange", width=2, dash="dash"),
name="Backward pass (gradientes)"
))
fig.update_layout(
title=dict(
text="Grafo computacional y propagacion hacia atras en PyTorch",
x=0.5, font=dict(size=14)
),
xaxis=dict(visible=False, range=[-0.5, 6.8]),
yaxis=dict(visible=False, range=[-0.8, 5.0]),
showlegend=True,
legend=dict(x=0.01, y=0.01),
height=400,
margin=dict(t=60, b=20, l=20, r=20),
plot_bgcolor="white"
)
fig.show()4.2 El patrón nn.Module
La clase nn.Module es la pieza central de PyTorch para definir modelos. Toda arquitectura, ya sea un MLP simple o un transformador con miles de millones de parámetros, es una subclase de nn.Module. El contrato es sencillo: el constructor __init__ declara las capas y sub-modulos (que deben ser atributos de la instancia para que PyTorch los registre), y el método forward describe el cómputo que convierte una entrada en una salida.
Mostrar código
import torch
import torch.nn as nn
class MLP(nn.Module):
def __init__(self, input_dim, hidden_dims, output_dim):
super().__init__()
dims = [input_dim] + hidden_dims + [output_dim]
layers = []
for i in range(len(dims) - 1):
layers.append(nn.Linear(dims[i], dims[i+1]))
if i < len(dims) - 2:
layers.append(nn.ReLU())
self.net = nn.Sequential(*layers)
def forward(self, x):
return self.net(x)nn.Linear(in, out) implementa \(y = xW^T + b\) con inicialización de Kaiming. nn.ReLU() aplica \(\max(0, z)\) elemento a elemento. nn.Sequential encadena módulos: la salida de cada uno es la entrada del siguiente.
Los métodos más útiles de cualquier nn.Module:
model.parameters()— itera sobre todos los tensores conrequires_grad=True. Se pasa directamente al optimizador.model.state_dict()— diccionario con los valores actuales de todos los parámetros. Permite guardar y cargar contorch.save/torch.load.model.train()/model.eval()— cambia el modo del modelo.
4.3 El ciclo de entrenamiento
El ciclo de entrenamiento explícito es una de las características más apreciadas de PyTorch. A diferencia de los frameworks que ocultan el bucle interno (como Keras o sklearn), PyTorch expone cada paso, lo que facilita la implementación de lógicas de entrenamiento no estándar y permite debuggear exactamente que sucede en cada momento.
El patrón de 5 pasos.
El ciclo de entrenamiento en PyTorch sigue un patrón rigido que se repite en cada epoch:
for epoch in range(n_epochs):
model.train() # Paso 1 — modo entrenamiento
optimizer.zero_grad() # Paso 2 — limpiar gradientes
logits = model(X_train) # Paso 3 — forward pass
loss = criterion(logits, y_train)
loss.backward() # Paso 4 — backward pass
optimizer.step() # Paso 5 — actualizar pesosEl siguiente laboratorio recorre cada paso:
Laboratorio · PyTorch
Los cinco pasos de una iteración de entrenamiento
Recorre los pasos y, en el panel inferior, observa qué ocurre si se omite optimizer.zero_grad() al minimizar la pérdida L(w) = (w − 3)² con SGD desde w = 0.
Trayectoria de w
con zero_grad()sin zero_grad()óptimo w = 3
Primeros pasos
Paso 5: optimizer.step() — Usar gradientes para actualizar.
El optimizador lee los gradientes en .grad y actualiza los parámetros. Para SGD simple: \[\theta := \theta - \eta \cdot \nabla \mathcal{L}(\theta)\]
Para Adam (el optimizador que usamos), mantiene exponential moving averages de los gradientes y sus cuadrados, y calcula updates adaptativos por parámetro.
Función de pérdida numéricamente estable.
5 Clasificación con PyTorch
5.1 Convertir arrays NumPy a tensores PyTorch
El primer paso es convertir los arrays NumPy a tensores PyTorch. Los tensores permiten diferenciación automática (rastreo de gradientes) y pueden ejecutarse en GPU para velocidad.
import torch
import torch.nn as nn
# Conversion a tensores — especificar dtype explicitamente
X_tr = torch.tensor(X_train, dtype=torch.float32)
y_tr = torch.tensor(y_train, dtype=torch.float32).unsqueeze(1) # shape: (N, 1)
X_vl = torch.tensor(X_val, dtype=torch.float32)
y_vl = torch.tensor(y_val, dtype=torch.float32).unsqueeze(1)
print(f"X_tr: {X_tr.shape} y_tr: {y_tr.shape}")
print(f"X_vl: {X_vl.shape} y_vl: {y_vl.shape}")
# Output:
# X_tr: torch.Size([480, 2]) y_tr: torch.Size([480, 1])
# X_vl: torch.Size([120, 2]) y_vl: torch.Size([120, 1])X_tr: torch.Size([480, 2]) y_tr: torch.Size([480, 1])
X_vl: torch.Size([120, 2]) y_vl: torch.Size([120, 1])¿Por que unsqueeze(1)?
Note que y_train comienza como un vector 1D de shape (480,). Lo convertimos a shape (480, 1) con .unsqueeze(1).
¿Por que? Porque nn.BCEWithLogitsLoss espera que la predicción del modelo y la etiqueta tengan exactamente la misma forma. Nuestro modelo es un MLP de arquitectura \([2 \to 32 \to 32 \to 1]\), que para un lote de \(N=480\) produce un tensor de shape (480, 1). Para que el cálculo de pérdida funcione correctamente, la etiqueta debe tener la misma forma.
Sin el unsqueeze(1), intentaras hacer BCEWithLogitsLoss con shapes (480, 1) y (480,), que causaría un error de broadcasting.
5.2 Definición del modelo MLP
En PyTorch, todo modelo es una subclase de nn.Module. La arquitectura es \([2 \to 32 \to 32 \to 1]\) con activaciones ReLU en las capas ocultas y una salida lineal (logit).
Mostrar código
class MLP(nn.Module):
def __init__(self, input_dim, hidden_dims, output_dim):
super().__init__()
dims = [input_dim] + hidden_dims + [output_dim]
layers = []
for i in range(len(dims) - 1):
layers.append(nn.Linear(dims[i], dims[i+1]))
# Activacion ReLU en todas excepto la ultima capa
if i < len(dims) - 2:
layers.append(nn.ReLU())
self.net = nn.Sequential(*layers)
def forward(self, x):
return self.net(x)
# Instanciar
torch.manual_seed(SEED)
model_pt = MLP(2, [32, 32], 1)
# Contar parametros
n_params = sum(p.numel() for p in model_pt.parameters())
print(f"Total de parametros: {n_params:,}")
print(model_pt)Total de parametros: 1,185
MLP(
(net): Sequential(
(0): Linear(in_features=2, out_features=32, bias=True)
(1): ReLU()
(2): Linear(in_features=32, out_features=32, bias=True)
(3): ReLU()
(4): Linear(in_features=32, out_features=1, bias=True)
)
)El modelo tiene: capa 1 (\(2 \times 32 + 32\) parámetros) + capa 2 (\(32 \times 32 + 32\)) + capa 3 (\(32 \times 1 + 1\)) = \(64 + 32 + 1024 + 32 + 32 + 1 = 1185\) parámetros en total.
5.3 Ciclo de entrenamiento con PyTorch
Aplicamos el patrón descrito en la sección anterior a un problema de clasificación binaria con make_moons. Este conjunto de datos es un clásico de prueba para fronteras de decisión no lineales: dos semilunares entrelazadas que no son separables linealmente. Una red con dos capas ocultas de 32 neuronas con activación ReLU debería aprender la frontera correctamente.
La arquitectura es \([2 \to 32 \to 32 \to 1]\): la capa de entrada recibe las dos coordenadas \((x_1, x_2)\), las dos capas ocultas aprenden representaciones no lineales, y la capa de salida produce un único logit que se convierte en probabilidad mediante la sigmoide. Para la clasificación, el umbral es 0.5: si \(\sigma(z) > 0.5\) se predice clase 1, de lo contrario clase 0.
El ciclo de entrenamiento sigue el patrón de cinco pasos que se repite en cada epoch:
Mostrar código
torch.manual_seed(SEED)
model_pt = MLP(2, [32, 32], 1)
optimizer = torch.optim.Adam(model_pt.parameters(), lr=0.01)
criterion = nn.BCEWithLogitsLoss()
train_losses, val_losses = [], []
train_accs, val_accs = [], []
for epoch in range(300):
# ════ FASE DE ENTRENAMIENTO ════
model_pt.train()
# Paso 1 & 2: Limpiar y forward
optimizer.zero_grad()
logits = model_pt(X_tr) # Shape: (480, 1) — predicciones del lote
# Paso 3: Calcular perdida
loss = criterion(logits, y_tr) # Shape: escalar
# Paso 4: Backward — calcula gradientes automaticamente
loss.backward()
# Paso 5: Actualizar — los pesos se modifican usando los gradientes
optimizer.step()
# ════ FASE DE EVALUACION (sin gradientes) ════
with torch.no_grad():
model_pt.eval()
val_logits = model_pt(X_vl) # Shape: (120, 1)
val_loss = criterion(val_logits, y_vl).item() # .item() -> float escalar
# Convertir logits a probabilidades [0, 1] y luego a predicciones binarias
train_pred = (torch.sigmoid(logits) >= 0.5).float() # Shape: (480, 1)
train_acc = (train_pred == y_tr).float().mean().item()
val_pred = (torch.sigmoid(val_logits) >= 0.5).float()
val_acc = (val_pred == y_vl).float().mean().item()
train_losses.append(loss.item())
val_losses.append(val_loss)
train_accs.append(train_acc)
val_accs.append(val_acc)
print(f"Epoch 300 | Train acc: {train_accs[-1]:.3f} | Val acc: {val_accs[-1]:.3f}")Epoch 300 | Train acc: 0.956 | Val acc: 0.925Desglose detallado de cada sección.
Fase de entrenamiento:
model_pt.train()— Activa modo entrenamiento para capas como Dropout.optimizer.zero_grad()— Crucial: Limpia los gradientes antiguos. Sin esto,.backward()acumularía gradientes sobre los anteriores.logits = model_pt(X_tr)— Forward pass: propaga el lote a través de la red. Output shape(480, 1).loss = criterion(logits, y_tr)— Calcula pérdida comparando predicciones vs etiquetas verdaderas.loss.backward()— Backward pass: recorre el grafo en reversa, acumulando gradientes en.gradde cada parámetro.optimizer.step()— Lee los gradientes y actualiza los pesos según la regla del optimizador (Adam).
Fase de evaluación:
with torch.no_grad(): Desactiva el rastreo de gradientes. No necesitamos gradientes para evaluación, así que esto ahorra memoria y tiempo.model_pt.eval(): Desactiva comportamientos aleatorios como Dropout y congela estadísticas de BatchNorm.- Convertimos logits a probabilidades con
torch.sigmoid()y aplicamos umbral 0.5 para clasificación binaria. .item()convierte un tensor escalar a un número Python para poder imprimir o almacenar.
Puntos críticos para entender.
- Los gradientes solo se calculan en
loss.backward(), no enloss.backward() + optimizer.step().step()solo lee los gradientes que ya fueron calculados. torch.no_grad()es esencial en evaluación porque no necesitamos gradientes y ahorrar memoria/tiempo es importante con lotes grandes.- La evaluación usa el mismo modelo pero modo diferente (
model_pt.eval()vsmodel_pt.train()), lo que afecta como se comportan capas especiales.
Mostrar código
import torch
import torch.nn as nn
import numpy as np
from sklearn.datasets import make_moons
import plotly.graph_objects as go
from plotly.subplots import make_subplots
# ---- Data preparation ----
X_np, y_np = make_moons(n_samples=500, noise=0.25, random_state=42)
n_train = int(0.8 * len(X_np))
idx = np.random.RandomState(42).permutation(len(X_np))
train_idx, val_idx = idx[:n_train], idx[n_train:]
X_train = torch.tensor(X_np[train_idx], dtype=torch.float32)
y_train = torch.tensor(y_np[train_idx], dtype=torch.float32).unsqueeze(1)
X_val = torch.tensor(X_np[val_idx], dtype=torch.float32)
y_val = torch.tensor(y_np[val_idx], dtype=torch.float32).unsqueeze(1)
# ---- Model definition ----
class MLP(nn.Module):
def __init__(self, input_dim, hidden_dims, output_dim):
super().__init__()
dims = [input_dim] + hidden_dims + [output_dim]
layers = []
for i in range(len(dims) - 1):
layers.append(nn.Linear(dims[i], dims[i+1]))
if i < len(dims) - 2:
layers.append(nn.ReLU())
self.net = nn.Sequential(*layers)
def forward(self, x):
return self.net(x)
torch.manual_seed(42)
model_pt = MLP(2, [32, 32], 1)
optimizer = torch.optim.Adam(model_pt.parameters(), lr=0.01)
criterion = nn.BCEWithLogitsLoss()
# ---- Training ----
train_losses, val_losses = [], []
train_accs, val_accs = [], []
for epoch in range(300):
model_pt.train()
optimizer.zero_grad()
logits = model_pt(X_train)
loss = criterion(logits, y_train)
loss.backward()
optimizer.step()
with torch.no_grad():
train_pred = (torch.sigmoid(logits) >= 0.5).float()
train_acc = (train_pred == y_train).float().mean().item()
model_pt.eval()
val_logits = model_pt(X_val)
val_loss = criterion(val_logits, y_val).item()
val_pred = (torch.sigmoid(val_logits) >= 0.5).float()
val_acc = (val_pred == y_val).float().mean().item()
train_losses.append(loss.item())
val_losses.append(val_loss)
train_accs.append(train_acc)
val_accs.append(val_acc)
epochs = list(range(1, 301))
# ---- Figure ----
fig = make_subplots(rows=1, cols=2,
subplot_titles=["Perdida (BCE)", "Exactitud"])
fig.add_trace(go.Scatter(x=epochs, y=train_losses, name="Train loss",
line=dict(color="steelblue", width=2)), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs, y=val_losses, name="Val loss",
line=dict(color="salmon", width=2, dash="dash")), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs, y=train_accs, name="Train acc",
line=dict(color="steelblue", width=2), showlegend=False), row=1, col=2)
fig.add_trace(go.Scatter(x=epochs, y=val_accs, name="Val acc",
line=dict(color="salmon", width=2, dash="dash"), showlegend=False), row=1, col=2)
fig.update_xaxes(title_text="Epoch")
fig.update_yaxes(title_text="BCE Loss", row=1, col=1)
fig.update_yaxes(title_text="Accuracy", row=1, col=2)
fig.update_layout(
title=dict(text="Entrenamiento del MLP en PyTorch (make_moons)", x=0.5, font=dict(size=14)),
height=400,
legend=dict(orientation="h", yanchor="bottom", y=-0.25, xanchor="center", x=0.5)
)
fig.show()Las curvas de pérdida muestran el comportamiento típico de un modelo bien ajustado: la pérdida de entrenamiento disminuye monotonamente mientras que la pérdida de validación converge a un valor cercano pero ligeramente superior, indicando que el modelo generaliza sin sobreajuste significativo. Las curvas de exactitud muestran que ambas fracciones (entrenamiento y validación) alcanzan valores por encima del 90% tras los primeros 50 epochs, con una mejora marginal en los epochs restantes.
5.4 Sensibilidad a la tasa de aprendizaje
La tasa de aprendizaje \(\eta\) es el hiperparámetro más crítico de cualquier red neuronal. Un valor demasiado bajo produce convergencia lenta o estancamiento en minimos locales poco favorables; un valor demasiado alto provoca oscilaciones en la pérdida o incluso divergencia. La siguiente figura entrena cuatro instancias del mismo MLP con tasas de aprendizaje que cubren tres ordenes de magnitud, permitiendo observar estos regímenes de forma directa.
Mostrar código
import torch
import torch.nn as nn
import numpy as np
from sklearn.datasets import make_moons
import plotly.graph_objects as go
X_lr, y_lr = make_moons(n_samples=500, noise=0.25, random_state=42)
n_tr_lr = int(0.8 * len(X_lr))
idx_lr = np.random.RandomState(42).permutation(len(X_lr))
X_tr_lr = torch.tensor(X_lr[idx_lr[:n_tr_lr]], dtype=torch.float32)
y_tr_lr = torch.tensor(y_lr[idx_lr[:n_tr_lr]], dtype=torch.float32).unsqueeze(1)
X_vl_lr = torch.tensor(X_lr[idx_lr[n_tr_lr:]], dtype=torch.float32)
y_vl_lr = torch.tensor(y_lr[idx_lr[n_tr_lr:]], dtype=torch.float32).unsqueeze(1)
learning_rates = [0.0005, 0.005, 0.05, 0.5]
lr_colors = ["#636EFA", "#00CC96", "#EF553B", "#AB63FA"]
n_ep_lr = 300
epochs_lr = list(range(1, n_ep_lr + 1))
criterion_lr = nn.BCEWithLogitsLoss()
fig = go.Figure()
for lr, color in zip(learning_rates, lr_colors):
torch.manual_seed(42)
net = nn.Sequential(
nn.Linear(2, 32), nn.ReLU(),
nn.Linear(32, 32), nn.ReLU(),
nn.Linear(32, 1)
)
opt_lr = torch.optim.Adam(net.parameters(), lr=lr)
vl_curve = []
for _ in range(n_ep_lr):
net.train()
opt_lr.zero_grad()
loss_lr = criterion_lr(net(X_tr_lr), y_tr_lr)
loss_lr.backward()
opt_lr.step()
with torch.no_grad():
net.eval()
vl_curve.append(criterion_lr(net(X_vl_lr), y_vl_lr).item())
fig.add_trace(go.Scatter(
x=epochs_lr, y=vl_curve,
name=f"lr = {lr}",
line=dict(color=color, width=2)
))
fig.add_shape(type="line",
x0=0, x1=n_ep_lr, y0=0.15, y1=0.15,
line=dict(color="gray", dash="dot", width=1))
fig.add_annotation(
x=250, y=0.12,
text="Umbral de buen ajuste",
showarrow=False, font=dict(size=10, color="gray"))
fig.update_layout(
title=dict(text="Sensibilidad a la tasa de aprendizaje (val loss)", x=0.5, font=dict(size=14)),
xaxis_title="Epoch",
yaxis_title="Perdida de validacion (BCE)",
legend=dict(orientation="h", yanchor="bottom", y=-0.22, xanchor="center", x=0.5),
height=420,
margin=dict(t=60, b=80)
)
fig.show()La frontera de decisión aprendida por la red se puede visualizar evaluando el modelo sobre una malla densa de puntos en el espacio de entrada. Cada punto de la malla recibe una probabilidad predicha \(\hat{p} = \sigma(f_\theta(x))\), y la isocurva \(\hat{p} = 0.5\) define la frontera de decisión.
Mostrar código
import plotly.graph_objects as go
import numpy as np
import torch
# Build grid
x1_range = np.linspace(X_np[:, 0].min() - 0.5, X_np[:, 0].max() + 0.5, 200)
x2_range = np.linspace(X_np[:, 1].min() - 0.5, X_np[:, 1].max() + 0.5, 200)
xx1, xx2 = np.meshgrid(x1_range, x2_range)
grid = np.c_[xx1.ravel(), xx2.ravel()]
grid_t = torch.tensor(grid, dtype=torch.float32)
model_pt.eval()
with torch.no_grad():
probs = torch.sigmoid(model_pt(grid_t)).numpy().reshape(200, 200)
final_val_acc = val_accs[-1]
# Scatter colors
colors_train = ["#EF553B" if c == 1 else "#636EFA" for c in y_np[train_idx]]
fig = go.Figure()
fig.add_trace(go.Contour(
x=x1_range, y=x2_range, z=probs,
colorscale="RdBu_r",
opacity=0.75,
showscale=True,
colorbar=dict(title="P(clase=1)"),
contours=dict(
start=0, end=1, size=0.05,
showlines=False
)
))
# White decision boundary at 0.5
fig.add_trace(go.Contour(
x=x1_range, y=x2_range, z=probs,
showscale=False,
contours=dict(
start=0.5, end=0.5, size=0,
coloring="lines"
),
line=dict(color="white", width=3),
name="Frontera (p=0.5)"
))
fig.add_trace(go.Scatter(
x=X_np[train_idx, 0], y=X_np[train_idx, 1],
mode="markers",
marker=dict(
color=y_np[train_idx].tolist(),
colorscale=[[0, "#636EFA"], [1, "#EF553B"]],
size=6, line=dict(color="white", width=0.5)
),
name="Puntos de entrenamiento"
))
fig.add_annotation(
x=0.02, y=0.97, xref="paper", yref="paper",
text=f"Val accuracy: {final_val_acc:.3f}",
showarrow=False,
font=dict(size=12, color="white"),
bgcolor="rgba(0,0,0,0.5)",
bordercolor="white", borderwidth=1
)
fig.update_layout(
title=dict(text="Frontera de decision del MLP entrenado con PyTorch", x=0.5, font=dict(size=14)),
xaxis_title="x1", yaxis_title="x2",
height=480,
legend=dict(orientation="h", yanchor="bottom", y=-0.15, xanchor="center", x=0.5)
)
fig.show()La frontera de decisión resultante es claramente no lineal: la red ha aprendido a separar las dos lunas con una curva suave que sigue la estructura geométrica de los datos. La isocurva blanca en \(\hat{p} = 0.5\) delimita la región de incertidumbre máxima, donde el modelo considera igualmente probables ambas clases. Las regiones de color intenso corresponden a zonas de alta confianza en la predicción.
5.5 Animación del aprendizaje
Una de las visualizaciones más reveladoras del proceso de entrenamiento de una red neuronal es observar como evoluciona la frontera de decisión a lo largo de las épocas. Al comienzo del entrenamiento, con pesos aleatorios pequeños, la frontera es casi lineal porque las activaciones ReLU operan en su región lineal. A medida que los pesos crecen y las no linealidades se activan, la frontera adquiere curvatura progresivamente hasta ajustarse a la geometría de los datos. El deslizador permite navegar por este proceso epoch a epoch.
Mostrar código
import torch
import torch.nn as nn
import numpy as np
from sklearn.datasets import make_moons
import plotly.graph_objects as go
# Dataset
X_an, y_an = make_moons(n_samples=500, noise=0.25, random_state=42)
n_tr_an = int(0.8 * len(X_an))
idx_an = np.random.RandomState(42).permutation(len(X_an))
X_tr_an = torch.tensor(X_an[idx_an[:n_tr_an]], dtype=torch.float32)
y_tr_an = torch.tensor(y_an[idx_an[:n_tr_an]], dtype=torch.float32).unsqueeze(1)
# Decision boundary grid
h_an = 0.05
x0_min, x0_max = X_an[:, 0].min() - 0.4, X_an[:, 0].max() + 0.4
x1_min, x1_max = X_an[:, 1].min() - 0.4, X_an[:, 1].max() + 0.4
gx, gy = np.meshgrid(np.arange(x0_min, x0_max, h_an),
np.arange(x1_min, x1_max, h_an))
grid_an = torch.tensor(np.c_[gx.ravel(), gy.ravel()], dtype=torch.float32)
gx_vals = np.arange(x0_min, x0_max, h_an)
gy_vals = np.arange(x1_min, x1_max, h_an)
# Train and capture snapshots every 10 epochs
torch.manual_seed(42)
net_an = nn.Sequential(
nn.Linear(2, 32), nn.ReLU(),
nn.Linear(32, 32), nn.ReLU(),
nn.Linear(32, 1)
)
opt_an = torch.optim.Adam(net_an.parameters(), lr=0.01)
crit_an = nn.BCEWithLogitsLoss()
snap_epochs = [0] + list(range(10, 301, 10))
snapshots_an = []
with torch.no_grad():
net_an.eval()
zz0 = torch.sigmoid(net_an(grid_an)).numpy().reshape(gx.shape)
snapshots_an.append((0, zz0.copy()))
for ep in range(1, 301):
net_an.train()
opt_an.zero_grad()
crit_an(net_an(X_tr_an), y_tr_an).backward()
opt_an.step()
if ep in snap_epochs:
with torch.no_grad():
net_an.eval()
zz = torch.sigmoid(net_an(grid_an)).numpy().reshape(gx.shape)
snapshots_an.append((ep, zz.copy()))
cl0_an = X_an[y_an == 0]
cl1_an = X_an[y_an == 1]
def make_frame_data(zz):
return [
go.Contour(z=zz, x=gx_vals, y=gy_vals,
colorscale="RdBu", zmin=0, zmax=1,
showscale=False, opacity=0.65,
contours=dict(showlines=False)),
go.Contour(z=zz, x=gx_vals, y=gy_vals,
colorscale=[[0, "white"], [1, "white"]],
zmin=0.495, zmax=0.505, showscale=False,
contours=dict(coloring="lines", showlines=True,
start=0.5, end=0.5, size=0.01),
line=dict(color="white", width=2.5)),
go.Scatter(x=cl0_an[:, 0], y=cl0_an[:, 1], mode="markers",
marker=dict(color="#EF553B", size=5, opacity=0.85),
name="Clase 0", showlegend=False),
go.Scatter(x=cl1_an[:, 0], y=cl1_an[:, 1], mode="markers",
marker=dict(color="#636EFA", size=5, opacity=0.85),
name="Clase 1", showlegend=False),
]
frames_an = [
go.Frame(data=make_frame_data(zz),
name=str(ep),
layout=go.Layout(title_text=f"Epoch {ep} | frontera de decision"))
for ep, zz in snapshots_an
]
init_ep_an, init_zz_an = snapshots_an[0]
init_data = make_frame_data(init_zz_an)
init_data[0]["showscale"] = True
init_data[0]["colorbar"] = dict(title="P(clase 1)", len=0.7)
fig = go.Figure(data=init_data, frames=frames_an)
slider_steps = [
dict(args=[[str(ep)],
dict(mode="immediate",
frame=dict(duration=0, redraw=True),
transition=dict(duration=0))],
label=str(ep), method="animate")
for ep, _ in snapshots_an
]
fig.update_layout(
title=dict(text=f"Epoch 0 | frontera de decision", x=0.5, font=dict(size=14)),
xaxis=dict(title="x1", showgrid=False),
yaxis=dict(title="x2", showgrid=False, scaleanchor="x"),
height=530,
margin=dict(t=60, b=130),
updatemenus=[dict(
type="buttons", showactive=False,
y=-0.1, x=0.5, xanchor="center",
buttons=[
dict(label="Reproducir",
method="animate",
args=[None, dict(frame=dict(duration=180, redraw=True),
fromcurrent=True, mode="immediate")]),
dict(label="Pausa",
method="animate",
args=[[None], dict(frame=dict(duration=0, redraw=False),
mode="immediate")])
]
)],
sliders=[dict(
active=0,
steps=slider_steps,
currentvalue=dict(prefix="Epoch: ", font=dict(size=12)),
pad=dict(t=45, b=10),
len=0.9, x=0.05
)]
)
fig.show()6 CNN con PyTorch
6.1 Arquitectura CNN en PyTorch
Para ilustrar las redes convolucionales en PyTorch utilizamos digits de sklearn: 1797 imágenes de dígitos manuscritos en escala de grises de \(8 \times 8\) píxeles y 10 clases. Es considerablemente más pequeño que MNIST (\(28 \times 28\)), pero suficiente para demostrar la arquitectura sin tiempos de espera largos.
Convención de forma: channels-first.
Las capas clave de la arquitectura:
nn.Conv2d(in, out, kernel_size, padding)— aplicaoutfiltros dekernel × kernela la entrada. Conpadding=1ykernel_size=3, las dimensiones espaciales se conservan.nn.MaxPool2d(2)— reduce dimensiones a la mitad seleccionando el máximo en ventanas \(2\times2\).nn.Flatten()— convierte el tensor 4D a un vector 1D para capas densas.nn.Dropout(0.3)— desactiva aleatoriamente el 30% de las neuronas. Solo activo enmodel.train().
El flujo de dimensiones con la arquitectura abajo es:
Entrada: (N, 1, 8, 8)
Conv1 + ReLU: (N, 16, 8, 8) ← 16 filtros 3×3, padding conserva tamaño
MaxPool: (N, 16, 4, 4) ← reducción ×2
Conv2 + ReLU: (N, 32, 4, 4) ← 32 filtros 3×3
MaxPool: (N, 32, 2, 2) ← reducción ×2
Flatten: (N, 128) ← 32 × 2 × 2 = 128
Dense + ReLU: (N, 64)
Dropout: (N, 64)
Salida: (N, 10) ← 10 logits para 10 dígitosMostrar código
import torch
import torch.nn as nn
import numpy as np
from sklearn.datasets import load_digits
import plotly.graph_objects as go
from plotly.subplots import make_subplots
# ---- Data ----
digits = load_digits()
X_dig = digits.data.astype(np.float32) / 16.0 # normalize to [0, 1]
y_dig = digits.target.astype(np.int64)
rng = np.random.RandomState(42)
idx_dig = rng.permutation(len(X_dig))
n_tr = int(0.8 * len(X_dig))
tr_idx, vl_idx = idx_dig[:n_tr], idx_dig[n_tr:]
X_tr_t = torch.tensor(X_dig[tr_idx].reshape(-1, 1, 8, 8))
y_tr_t = torch.tensor(y_dig[tr_idx])
X_vl_t = torch.tensor(X_dig[vl_idx].reshape(-1, 1, 8, 8))
y_vl_t = torch.tensor(y_dig[vl_idx])
# ---- Model ----
class CNN(nn.Module):
def __init__(self):
super().__init__()
self.features = nn.Sequential(
nn.Conv2d(1, 16, kernel_size=3, padding=1), # (N, 16, 8, 8)
nn.ReLU(),
nn.MaxPool2d(2), # (N, 16, 4, 4)
nn.Conv2d(16, 32, kernel_size=3, padding=1), # (N, 32, 4, 4)
nn.ReLU(),
nn.MaxPool2d(2), # (N, 32, 2, 2)
)
self.classifier = nn.Sequential(
nn.Flatten(),
nn.Linear(32 * 2 * 2, 64),
nn.ReLU(),
nn.Dropout(0.3),
nn.Linear(64, 10),
)
def forward(self, x):
return self.classifier(self.features(x))
torch.manual_seed(42)
cnn_pt = CNN()
opt_cnn = torch.optim.Adam(cnn_pt.parameters(), lr=1e-3)
crit_cnn = nn.CrossEntropyLoss()
cnn_tr_losses, cnn_vl_losses = [], []
cnn_tr_accs, cnn_vl_accs = [], []
for epoch in range(50):
cnn_pt.train()
opt_cnn.zero_grad()
logits_cnn = cnn_pt(X_tr_t)
loss_cnn = crit_cnn(logits_cnn, y_tr_t)
loss_cnn.backward()
opt_cnn.step()
with torch.no_grad():
tr_pred = logits_cnn.argmax(dim=1)
tr_acc = (tr_pred == y_tr_t).float().mean().item()
cnn_pt.eval()
vl_logits = cnn_pt(X_vl_t)
vl_loss = crit_cnn(vl_logits, y_vl_t).item()
vl_pred = vl_logits.argmax(dim=1)
vl_acc = (vl_pred == y_vl_t).float().mean().item()
cnn_tr_losses.append(loss_cnn.item())
cnn_vl_losses.append(vl_loss)
cnn_tr_accs.append(tr_acc)
cnn_vl_accs.append(vl_acc)
epochs_cnn = list(range(1, 51))
fig = make_subplots(rows=1, cols=2,
subplot_titles=["Perdida (Cross-Entropy)", "Exactitud"])
fig.add_trace(go.Scatter(x=epochs_cnn, y=cnn_tr_losses, name="Train loss",
line=dict(color="steelblue", width=2)), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs_cnn, y=cnn_vl_losses, name="Val loss",
line=dict(color="salmon", width=2, dash="dash")), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs_cnn, y=cnn_tr_accs, name="Train acc",
line=dict(color="steelblue", width=2), showlegend=False), row=1, col=2)
fig.add_trace(go.Scatter(x=epochs_cnn, y=cnn_vl_accs, name="Val acc",
line=dict(color="salmon", width=2, dash="dash"), showlegend=False), row=1, col=2)
fig.update_xaxes(title_text="Epoch")
fig.update_yaxes(title_text="Cross-Entropy Loss", row=1, col=1)
fig.update_yaxes(title_text="Accuracy", row=1, col=2)
fig.update_layout(
title=dict(text="Entrenamiento de la CNN en PyTorch (digits)", x=0.5, font=dict(size=14)),
height=400,
legend=dict(orientation="h", yanchor="bottom", y=-0.25, xanchor="center", x=0.5)
)
fig.show()La CNN converge rápidamente en las imágenes de \(8 \times 8\) de digits. La exactitud de validación supera el 95% en pocos epochs, lo que refleja que estas imágenes son relativamente fáciles para una red convolucional: los patrones de cada digito son altamente consistentes y la resolución baja no introduce demasiada variabilidad. El Dropout con tasa 0.3 previene el sobreajuste, como se observa en la cercanía entre las curvas de entrenamiento y validación.
Una métrica especialmente útil para la clasificación multiclase es la matriz de confusión, que muestra cuantas instancias de la clase verdadera \(i\) fueron predichas como clase \(j\). Los elementos diagonales corresponden a predicciones correctas; los elementos fuera de la diagonal revelan que pares de clases se confunden entre si, lo que puede guiar el análisis de errores y el ajuste de la arquitectura.
Mostrar código
import plotly.graph_objects as go
import numpy as np
import torch
# Compute confusion matrix
cnn_pt.eval()
with torch.no_grad():
vl_preds_np = cnn_pt(X_vl_t).argmax(dim=1).numpy()
vl_true_np = y_vl_t.numpy()
n_classes = 10
conf_mat = np.zeros((n_classes, n_classes), dtype=int)
for t, p in zip(vl_true_np, vl_preds_np):
conf_mat[t, p] += 1
labels = [str(i) for i in range(10)]
text_mat = [[str(conf_mat[i, j]) for j in range(n_classes)] for i in range(n_classes)]
fig = go.Figure(go.Heatmap(
z=conf_mat.tolist(),
x=labels, y=labels,
colorscale="Blues",
text=text_mat,
texttemplate="%{text}",
textfont=dict(size=11),
colorbar=dict(title="Conteo")
))
fig.update_layout(
title=dict(text="Matriz de confusion -- CNN en PyTorch (digits)", x=0.5, font=dict(size=14)),
xaxis=dict(title="Prediccion", tickfont=dict(size=11)),
yaxis=dict(title="Etiqueta real", tickfont=dict(size=11), autorange="reversed"),
height=500,
width=560
)
fig.show()La diagonal dominante en la matriz de confusión confirma el buen desempeno del modelo. Las confusiones más frecuentes suelen ocurrir entre digitos con morfología similar: el 4 y el 9 comparten una curvatura superior cerrada, y el 3 y el 8 tienen regiones de activación superpuestas. Estos errores son consistentes con los que comete un clasificador humano cuando la escritura es ambigua, lo que sugiere que el modelo ha aprendido representaciones genuinamente relevantes y no artefactos espurios.
6.2 Filtros aprendidos por la primera capa convolucional
Una propiedad notable de las CNNs es que sus filtros no son disenados manualmente: emergen del proceso de optimización como los detectores de características más útiles para la tarea. En los primeros niveles de una CNN entrenada en imágenes naturales (ImageNet), los filtros suelen especializarse en bordes orientados, manchas de color y texturas de baja frecuencia. En nuestra CNN entrenada sobre digitos 8x8, la primera capa aprende 16 filtros 3x3 que capturan los patrones más discriminativos de la escritura numérica.
Mostrar código
import numpy as np
import plotly.graph_objects as go
from plotly.subplots import make_subplots
# Extract conv1 weights: shape (16, 1, 3, 3) -> (16, 3, 3)
conv1_w = cnn_pt.features[0].weight.detach().numpy()[:, 0, :, :] # (16, 3, 3)
n_filt = conv1_w.shape[0] # 16
fig = make_subplots(
rows=2, cols=8,
subplot_titles=[f"F{i+1}" for i in range(n_filt)],
horizontal_spacing=0.02,
vertical_spacing=0.14
)
for i in range(n_filt):
row = i // 8 + 1
col = i % 8 + 1
w = conv1_w[i]
vmax = max(abs(w.min()), abs(w.max())) + 1e-6
show_cb = (i == n_filt - 1)
fig.add_trace(
go.Heatmap(
z=w,
colorscale="RdBu",
zmin=-vmax, zmax=vmax,
showscale=show_cb,
colorbar=dict(title="w", len=0.45, y=0.25, thickness=12)
if show_cb else None,
xgap=1, ygap=1
),
row=row, col=col
)
fig.update_xaxes(showticklabels=False, row=row, col=col)
fig.update_yaxes(showticklabels=False, row=row, col=col)
fig.update_layout(
title=dict(text="Filtros aprendidos — Conv1 (16 filtros 3x3)", x=0.5, font=dict(size=14)),
height=310,
margin=dict(t=55, b=15, l=10, r=30)
)
fig.show()7 JAX: fundamentos
7.1 El paradigma funcional
JAX (Bradbury et al. 2018) redefine completamente la relación entre Python y el hardware de aceleración. La diferencia no es solo técnica; es una filosofía de programación fundamentalmente diferente.
La diferencia central, en concreto:
El modelo es un objeto con estado mutable: los pesos viven dentro de él y el optimizador los modifica en su lugar.
model = nn.Linear(5, 3) # crea un objeto con pesos internos
y = model(x) # los pesos están DENTRO del objeto
print(model.weight.grad) # los gradientes también
optimizer.step() # modifica model.weight en su lugarVentaja: intuitivo y fácil de depurar. Costo: más difícil de compilar y de transformar.
Las funciones son puras: el estado (los pesos) vive fuera y se pasa explícitamente.
params = model.init(key, x) # los pesos son un diccionario (pytree)
y = model.apply(params, x) # función pura: los params se PASAN
new_params = optax.apply_updates(params, updates)
# params no cambió: new_params es un objeto distintoVentaja: componible, compilable y reproducible. Costo: más verboso; depurar es más difícil.
¿Que es programación funcional pura?
La diferencia central: en PyTorch el estado vive dentro del objeto modelo y muta con cada paso. En JAX el estado son datos externos que pasas explícitamente y que nunca se modifican — cada operación produce valores nuevos.
Las cuatro transformaciones de JAX.
JAX proporciona cuatro transformaciones componibles:
1. jax.grad(f) — Diferenciación automática
def loss(w):
return jnp.sum(w ** 2)
g = jax.grad(loss)(jnp.array([1., 2., 3.])) # → [2., 4., 6.]Retorna directamente los gradientes como pytree. No acumula en .grad — los gradientes son valores de retorno, no efectos secundarios.
2. jax.jit(f) — Compilación XLA
@jax.jit
def forward(params, x):
return x @ params["W"] + params["b"]
forward(params, x) # Primera vez: traza + compila (lento)
forward(params, x) # Siguientes: ejecuta compilado (rápido)3. jax.vmap(f) — Vectorización automática
Transforma una función que opera sobre un solo ejemplo en una que opera sobre un lote entero, sin escribir índices de lote.
4. jax.pmap(f) — Paralelismo entre dispositivos
Ejecuta en paralelo sobre múltiples GPUs/TPUs. Poco común para usuarios nuevos.
7.2 Parámetros como pytrees: estado explícito
En JAX no existe un objeto “modelo” que contenga estado interno. En su lugar, los parámetros son estructuras de datos Python explicitas (diccionarios, listas, tuplas, o combinaciones anidadas) que contienen los arrays de JAX. Estos se pasan explícitamente como argumentos a cada función.
¿Por qué es ventajoso?
- Inspeccionables: Puedes ver exactamente qué parámetros tiene tu modelo en cualquier momento.
- Serializables: Guardar y cargar es trivial — solo serializa el diccionario.
- Transformables: JAX entiende estas estructuras y puede aplicar transformaciones automáticamente.
Pytrees: contenedores anidados de datos.
Un pytree es cualquier estructura de datos Python donde las “hojas” (elementos más profundos) son arrays JAX. Ejemplos:
# Pytree simple — diccionario
params_simple = {
"W": [jnp.array([[1., 2.], [3., 4.]]), # Layer 1 weights
jnp.array([[5., 6.], [7., 8.]])], # Layer 2 weights
"b": [jnp.array([0.1, 0.2]), # Layer 1 bias
jnp.array([0.3])] # Layer 2 bias
}
# Pytree más complejo — anidación arbitraria
params_complex = {
"encoder": {
"dense1": {"W": jnp.array(...), "b": jnp.array(...)},
"dense2": {"W": jnp.array(...), "b": jnp.array(...)}
},
"decoder": {"W": jnp.array(...), "b": jnp.array(...)}
}JAX transforma automáticamente cada hoja.
La magia de JAX es que cuando usas transformaciones como jax.grad() sobre una función que recibe un pytree, JAX retorna un pytree con la misma estructura.
def loss_fn(params, x, y):
# params es un pytree (diccionario)
yhat = mlp_forward(params, x)
return jnp.mean((yhat - y) ** 2)
# jax.grad retorna una función que toma params y retorna gradientes
grad_loss = jax.grad(loss_fn)
grads = grad_loss(params, x, y)
# grads es un pytree con EXACTAMENTE la misma estructura que params
# Cada leaf es el gradiente del peso correspondienteEsto significa que actualizaciones de parámetros son triviales:
# Actualización manual — iteraría sobre la estructura completa
for layer_name in params.keys():
for param_name in params[layer_name].keys():
params[layer_name][param_name] -= learning_rate * grads[layer_name][param_name]
# Con optax (optimizador JAX) — automático
updates, new_opt_state = optimizer.update(grads, opt_state, params)
new_params = optax.apply_updates(params, updates)Ejemplo completo: forward pass con parámetros pytree.
Mostrar código
import jax
import jax.numpy as jnp
def mlp_forward(params, x):
"""
Forward pass que usa un pytree de parametros.
params["W"] es una lista de matrices (capas)
params["b"] es una lista de vectores (biases)
"""
# Capas ocultas con ReLU
for i in range(len(params["W"]) - 1):
# x @ params["W"][i] hace: (batch, in) @ (in, out) -> (batch, out)
x = jnp.maximum(0, x @ params["W"][i] + params["b"][i])
# Capa final: sin activación (logit)
x = x @ params["W"][-1] + params["b"][-1]
return x.squeeze(-1) # (batch, 1) -> (batch,)7.3 Visualización: grad de la entropía cruzada
Para ilustrar jax.grad de forma concreta, calculamos la pérdida de entropía cruzada binaria y su gradiente respecto a un peso escalar \(w\) variando en \([-3, 3]\), con entrada fija \(x = 1\) e etiqueta \(y = 1\). La pérdida es:
\[ \mathcal{L}(w) = -\left[ y \log \sigma(wx) + (1-y) \log(1 - \sigma(wx)) \right] \tag{3}\]
donde \(\sigma(z) = 1 / (1 + e^{-z})\). Con \(y = x = 1\), la pérdida simplifica a \(\mathcal{L}(w) = -\log \sigma(w)\), que es una función decreciente (a mayor \(w\), la predicción \(\sigma(w)\) se acerca a 1 y la pérdida se acerca a 0). El gradiente es \(\partial \mathcal{L} / \partial w = \sigma(w) - 1 \leq 0\), siempre negativo: el descenso por gradiente siempre incrementa \(w\) para que la predicción se acerque a \(y=1\).
Mostrar código
import jax
import jax.numpy as jnp
import numpy as np
import plotly.graph_objects as go
from plotly.subplots import make_subplots
x_fixed = 1.0
y_fixed = 1.0
def bce_single(w):
z = w * x_fixed
sigma = jax.nn.sigmoid(z)
eps = 1e-7
sigma = jnp.clip(sigma, eps, 1 - eps)
return -(y_fixed * jnp.log(sigma) + (1 - y_fixed) * jnp.log(1 - sigma))
grad_bce = jax.grad(bce_single)
w_vals = np.linspace(-3.0, 3.0, 200)
loss_vals = np.array([float(bce_single(float(w))) for w in w_vals])
grad_vals = np.array([float(grad_bce(float(w))) for w in w_vals])
fig = make_subplots(rows=2, cols=1,
subplot_titles=["Perdida BCE", "Gradiente dL/dw"],
shared_xaxes=True, vertical_spacing=0.12)
fig.add_trace(go.Scatter(
x=w_vals, y=loss_vals,
line=dict(color="steelblue", width=2.5),
name="L(w)"
), row=1, col=1)
fig.add_trace(go.Scatter(
x=w_vals, y=grad_vals,
line=dict(color="darkorange", width=2.5),
name="dL/dw"
), row=2, col=1)
fig.add_hline(y=0, line=dict(color="gray", dash="dot", width=1), row=2, col=1)
fig.update_xaxes(title_text="w", row=2, col=1)
fig.update_yaxes(title_text="Perdida", row=1, col=1)
fig.update_yaxes(title_text="Gradiente", row=2, col=1)
fig.update_layout(
title=dict(text="jax.grad: perdida y gradiente de la entropia cruzada", x=0.5, font=dict(size=14)),
height=480,
showlegend=True,
legend=dict(orientation="h", yanchor="bottom", y=-0.12, xanchor="center", x=0.5)
)
fig.show()La figura confirma la intuición matemática: la pérdida es alta y decreciente para \(w\) negativo (la red esta haciendo predicciones incorrectas con alta confianza) y se aproxima a cero a medida que \(w\) crece. El gradiente es siempre negativo, lo que significa que el descenso por gradiente siempre empuja \(w\) hacia valores más grandes. En \(w = 0\) (inicialización típica), el gradiente vale exactamente \(-0.5\), lo que corresponde al caso de incertidumbre máxima donde \(\sigma(0) = 0.5\).
7.4 Derivadas de orden superior: una ventaja exclusiva de JAX
Una capacidad que distingue a JAX de otros frameworks es la diferenciación de orden superior mediante composición de jax.grad. En PyTorch es posible pero requiere configuraciones especiales (create_graph=True); en JAX es natural: jax.grad(jax.grad(f)) es exactamente lo que parece. Esta capacidad es fundamental para métodos de optimización de segundo orden (Newton-Raphson, Gauss-Newton), regularización basada en la traza del Hessiano, y meta-aprendizaje (donde se diferencia a través de un bucle de entrenamiento completo).
La segunda derivada de la pérdida respecto a un peso, \(\partial^2 \mathcal{L} / \partial w^2\), mide la curvatura del paisaje de optimización. Una curvatura alta indica que pequeños cambios en el peso producen grandes cambios en la pérdida; una curvatura baja indica una región plana. Los optimizadores de segundo orden utilizan esta información para dar pasos adaptados a la geometría local, a diferencia de SGD que usa el mismo tamaño de paso en todas las direcciones.
Mostrar código
import jax
import jax.numpy as jnp
import numpy as np
import plotly.graph_objects as go
from plotly.subplots import make_subplots
def bce_ho(w):
sigma = jax.nn.sigmoid(w)
return -jnp.log(jnp.clip(sigma, 1e-7, 1.0 - 1e-7))
grad1_ho = jax.grad(bce_ho)
grad2_ho = jax.grad(jax.grad(bce_ho))
w_ho = np.linspace(-5, 5, 300)
loss_ho = np.array([float(bce_ho(jnp.array(float(w)))) for w in w_ho])
g1_ho = np.array([float(grad1_ho(jnp.array(float(w)))) for w in w_ho])
g2_ho = np.array([float(grad2_ho(jnp.array(float(w)))) for w in w_ho])
fig = make_subplots(
rows=1, cols=3,
subplot_titles=["Perdida L(w)", "Primera derivada dL/dw", "Segunda derivada d2L/dw2"]
)
palette = ["#636EFA", "#EF553B", "#00CC96"]
for col, (vals, name) in enumerate(
zip([loss_ho, g1_ho, g2_ho], ["L(w)", "dL/dw", "d2L/dw2"]), start=1
):
fig.add_trace(
go.Scatter(x=w_ho, y=vals, mode="lines",
line=dict(color=palette[col - 1], width=2.5), name=name),
row=1, col=col
)
fig.add_hline(y=0, line_dash="dot", line_color="gray", line_width=1, row=1, col=col)
fig.add_vline(x=0, line_dash="dot", line_color="gray", line_width=1, row=1, col=col)
fig.add_annotation(
x=0, y=float(grad2_ho(jnp.array(0.0))),
text="Curvatura max en w=0",
showarrow=True, arrowhead=2, ax=60, ay=-30,
font=dict(size=10), row=1, col=3
)
fig.update_xaxes(title_text="w")
fig.update_layout(
title=dict(text="Derivadas de orden superior con jax.grad compuesto", x=0.5, font=dict(size=14)),
showlegend=False,
height=380,
margin=dict(t=70, b=50)
)
fig.show()8 Clasificación con JAX puro
8.1 Cambio de paradigma: funciones puras y pytrees
Implementamos un MLP completo en JAX puro (sin Flax) sobre el mismo conjunto make_moons usado en la sección de PyTorch. Esto permite una comparación directa del código y los resultados. La arquitectura es idéntica: \([2 \to 32 \to 32 \to 1]\).
En JAX puro, no existe un objeto “modelo” con estado interno. Los parámetros son diccionarios Python (pytrees) que se pasan explícitamente como argumentos. Esta disciplina funcional tiene ventajas: los parámetros son inspeccionables, se pueden serializar como dicts, y las transformaciones de JAX pueden recorrerlos automáticamente.
8.2 Inicialización de parámetros JAX
En PyTorch, la inicialización de pesos ocurre automáticamente dentro de nn.Linear(). En JAX puro, debes ser explícito y escribir tu propia función de inicialización.
¿Por qué inicialización explícita?
Porque en JAX no hay objeto modelo con estado. Los parámetros son solo datos que debes crear tú mismo. Esto parece verboso, pero te da control total.
PRNG management — ¿Por qué jax.random.split?
JAX requiere determinismo puro: la misma función con los mismos argumentos debe retornar exactamente lo mismo. Por eso no hay un generador global mutable como en NumPy — la aleatoriedad debe ser explícita.
Función de inicialización con He initialization.
Mostrar código
import jax
import jax.numpy as jnp
import optax
def init_params(layer_dims, key):
"""
Inicializa los parametros del MLP con He initialization.
Args:
layer_dims: Lista de dimensiones, ej. [2, 32, 32, 1]
key: PRNG key de JAX
Returns:
Pytree (diccionario) con estructuras:
{"W": [matriz1, matriz2, ...], "b": [vector1, vector2, ...]}
"""
params = {"W": [], "b": []}
for i in range(len(layer_dims) - 1):
# Dividir key para obtener una key única para esta capa
key, subkey = jax.random.split(key)
# He initialization: los pesos se escalan por sqrt(2 / fan_in)
# Esto ayuda a mantener la varianza consistente a traves de capas profundas
fan_in = layer_dims[i]
W = jax.random.normal(subkey, (layer_dims[i], layer_dims[i+1])) * jnp.sqrt(2.0 / fan_in)
# Biases iniciales en cero (convención)
b = jnp.zeros(layer_dims[i+1])
params["W"].append(W)
params["b"].append(b)
return params
# Inicializar
key = jax.random.PRNGKey(SEED)
params_jax = init_params([2, 32, 32, 1], key)
print(f"Numero de capas: {len(params_jax['W'])}")
for i, (W, b) in enumerate(zip(params_jax["W"], params_jax["b"])):
print(f" Capa {i+1}: W{W.shape} b{b.shape}")
# Output:
# Numero de capas: 3
# Capa 1: W(2, 32) b(32,)
# Capa 2: W(32, 32) b(32,)
# Capa 3: W(32, 1) b(1,)Numero de capas: 3
Capa 1: W(2, 32) b(32,)
Capa 2: W(32, 32) b(32,)
Capa 3: W(32, 1) b(1,)He Initialization — ¿por qué?
Sin inicialización cuidadosa, los parámetros pueden ser demasiado grandes o demasiado pequeños: - Si W es muy pequeño: las activaciones desaparecen (gradientes vanishing). - Si W es muy grande: las activaciones saturan o explotan.
He initialization escala cada matriz de pesos para mantener una varianza consistente. Para ReLU, usamos \(\text{std} = \sqrt{2 / \text{fan\_in}}\), donde fan_in es el número de entradas a la capa.
Comparación: PyTorch vs JAX
| Aspecto | PyTorch | JAX |
|---|---|---|
| Inicialización | Automática en nn.Linear() |
Manual con init_params() |
| Acceso a parámetros | model.parameters() |
params diccionario |
| Aleatoriedad | PRNG global implícito | PRNG key explícito |
| Ventaja | Menos código | Más control, reproducible |
8.3 Forward pass y función de pérdida JAX
Forward pass — operaciones lineales + activaciones.
Mostrar código
def forward_jax(params, x):
"""
Propagacion hacia adelante: MLPx de arquitectura [2 -> 32 -> 32 -> 1].
Capas ocultas: transformación lineal + ReLU
Capa final: transformación lineal + sigmoid (retorna probabilidades en [0, 1])
"""
# Capas ocultas con ReLU
for i in range(len(params["W"]) - 1):
# x @ params["W"][i]: (batch, in) @ (in, out) -> (batch, out)
# + params["b"][i]: agregar bias
# jax.nn.relu: aplicar activación
x = jax.nn.relu(x @ params["W"][i] + params["b"][i])
# Capa final: sin activación (retorna logit)
logit = x @ params["W"][-1] + params["b"][-1]
# .squeeze(-1): convertir shape (batch, 1) -> (batch,)
return jax.nn.sigmoid(logit).squeeze(-1)¿Por qué .squeeze(-1)?
La salida de la capa final antes del squeeze es shape (batch, 1). En JAX, es convención que funciones de pérdida escalar (como binary cross-entropy) reciben vectores 1D (batch,) para compatibilidad con operaciones de reducción.
Comparación de shapes a lo largo del forward pass con entrada X_tr_j de shape (480, 2):
Entrada x: (480, 2)
Despues de capa 1 + ReLU: (480, 32)
Despues de capa 2 + ReLU: (480, 32)
Despues de capa 3: (480, 1) ← logit antes de sigmoid
Despues de sigmoid: (480, 1)
Despues de squeeze(-1): (480,) ← vector 1D de probabilidadesLoss function — binary cross-entropy.
Mostrar código
def bce_loss_jax(params, x, y):
"""
Binary cross-entropy loss.
L = -E[ y*log(yhat) + (1-y)*log(1-yhat) ]
donde yhat es la probabilidad predicha (0 a 1).
"""
# Forward pass: obtener predicciones
yhat = forward_jax(params, x) # Shape: (batch,)
# Clip para evitar log(0) — log(0) no está definido numericamente
eps = 1e-7
yhat = jnp.clip(yhat, eps, 1 - eps) # yhat in [eps, 1-eps]
# BCE formula aplicada elemento a elemento
loss = -(y * jnp.log(yhat) + (1 - y) * jnp.log(1 - yhat))
# Retornar promedio sobre el lote
return jnp.mean(loss)La forma de las variables.
Cuando llamas bce_loss_jax(params, X_tr_j, y_tr_j): - x tiene shape (480, 2) — 480 ejemplos, 2 features - y tiene shape (480,) — 480 etiquetas binarias - yhat tiene shape (480,) — 480 predicciones - loss es un escalar — el promedio de la pérdida de todos los ejemplos
Este es el valor que luego diferenciaras con jax.grad() para obtener los gradientes.
8.4 Preparación de datos JAX
Mostrar código
# Convertir datos a JAX arrays
X_tr_j = jnp.array(X_train, dtype=jnp.float32)
y_tr_j = jnp.array(y_train, dtype=jnp.float32)
X_vl_j = jnp.array(X_val, dtype=jnp.float32)
y_vl_j = jnp.array(y_val, dtype=jnp.float32)
# Inicializar parametros con PRNG key
key = jax.random.PRNGKey(42)
params_jax = init_params([2, 32, 32, 1], key)
# Prueba rapida con datos JAX
y_pred_test = forward_jax(params_jax, X_tr_j[:5])
loss_initial = bce_loss_jax(params_jax, X_tr_j, y_tr_j)
print(f"Predicciones iniciales (primeras 5): {y_pred_test}")
print(f"Perdida inicial: {float(loss_initial):.4f}")Predicciones iniciales (primeras 5): [0.6773608 0.5984973 0.6005721 0.9004446 0.6705811]
Perdida inicial: 0.97618.5 Paso de entrenamiento con JIT compilation
Diferencia filosófica: PyTorch vs JAX.
PyTorch:
for epoch in range(n_epochs):
optimizer.zero_grad()
logits = model(X_train)
loss = criterion(logits, y_train)
loss.backward()
optimizer.step()- El bucle es imperativo — instrucciones paso a paso.
- El estado del modelo y optimizador cambia en cada paso.
- Fácil de debuggear porque el estado es observable en cualquier momento.
JAX:
for epoch in range(n_epochs):
params, opt_state, loss = train_step(params, opt_state, X_train, y_train)- Todo el paso está encapsulado en una función pura que retorna nuevos valores.
- Ningun estado mutable — los parámetros y estado del optimizador son argumentos de entrada y salida.
- Se puede compilar con JIT para velocidad.
El paso de entrenamiento JAX.
Mostrar código
# Optimizador funcional — mantiene su estado externamente
optimizer_jax = optax.adam(learning_rate=0.01)
opt_state_jax = optimizer_jax.init(params_jax) # Estado inicial del optimizador
# Decorador @jax.jit: compila esta función con XLA
@jax.jit
def train_step_jax(params, opt_state, x, y):
"""
Un paso de entrenamiento JAX.
Nota: Esta función es PURA — no modifica nada externamente.
Retorna nuevos valores para params, opt_state y la perdida.
"""
# Paso 1: Calcular perdida Y gradientes simultaneamente
# jax.value_and_grad retorna (pérdida_escalar, gradientes_como_pytree)
loss, grads = jax.value_and_grad(bce_loss_jax)(params, x, y)
# Paso 2: Obtener updates del optimizador
# El optimizador lee los gradientes y retorna direcciones de actualización
# (updates pueden ser diferentes de gradientes — Adam, por ejemplo, modifica los gradientes)
updates, new_opt_state = optimizer_jax.update(grads, opt_state, params)
# Paso 3: Aplicar updates a los parametros
# new_params = params + updates (aproximadamente)
new_params = optax.apply_updates(params, updates)
# Retornar nuevos valores — NADA se modificó internamente
return new_params, new_opt_state, loss
# Prueba: un paso de entrenamiento
params_test, state_test, loss_test = train_step_jax(
params_jax, opt_state_jax, X_tr_j, y_tr_j
)
print(f"Perdida despues de 1 paso: {float(loss_test):.4f}")Perdida despues de 1 paso: 0.9761Desglose línea por línea.
loss, grads = jax.value_and_grad(bce_loss_jax)(params, x, y)
Esto es equivalente a lo que PyTorch hace en dos llamadas separadas:
# PyTorch
loss = criterion(logits, y_train) # Paso 1: calcular pérdida
loss.backward() # Paso 2: calcular gradientes (acumula en .grad)
# JAX — en una sola operación
loss, grads = jax.value_and_grad(bce_loss_jax)(params, x, y)
# loss: escalar
# grads: pytree con misma estructura que params, pero contiene gradientesupdates, new_opt_state = optimizer_jax.update(grads, opt_state, params)
El optimizador Lee los gradientes e internamente mantiene momentos (moving averages). Para Adam, computa:
\[m_t = \beta_1 m_{t-1} + (1-\beta_1) g_t \quad \text{(first moment)}\] \[v_t = \beta_2 v_{t-1} + (1-\beta_2) g_t^2 \quad \text{(second moment)}\] \[\text{update} = \frac{m_t}{\sqrt{v_t} + \epsilon}\]
Esto es todo lo que PyTorch hace en optimizer.step(), pero de forma explícita y retornando los valores.
new_params = optax.apply_updates(params, updates)
Aplica los updates: \[\theta_{\text{new}} = \theta_{\text{old}} + \text{learning\_rate} \times \text{updates}\]
¿Por qué @jax.jit?
El decorador @jax.jit compila la función con XLA la primera vez que se llama: - Primera llamada: JAX traza la función, observa las formas de entrada, y genera código XLA optimizado. Lento — puede tomar varios segundos. - Llamadas subsiguientes con mismas formas: Reutilizan el código compilado. Mucho más rápido.
Para datos de tamaño fijo (como en este ejemplo), la compilación ocurre una sola vez y los 299 epochs siguientes son significativamente más rápidos que en PyTorch eager.
8.6 Bucle de entrenamiento completo
Mostrar código
# Reinicializar para partir desde cero
params_jax = init_params([2, 32, 32, 1], key)
opt_state_jax = optimizer_jax.init(params_jax)
jax_tr_losses, jax_vl_losses = [], []
jax_tr_accs, jax_vl_accs = [], []
for epoch in range(300):
# Paso de entrenamiento (JIT-compilado)
params_jax, opt_state_jax, tr_loss = train_step_jax(
params_jax, opt_state_jax, X_tr_j, y_tr_j
)
# Metricas de validacion (sin compilar, solo para monitoreo)
vl_loss = float(bce_loss_jax(params_jax, X_vl_j, y_vl_j))
# Obtener predicciones (jax.device_get trae del dispositivo acelerado a CPU)
tr_preds = jax.device_get(forward_jax(params_jax, X_tr_j))
vl_preds = jax.device_get(forward_jax(params_jax, X_vl_j))
tr_acc = np.mean((tr_preds >= 0.5).astype(int) == np.array(y_tr_j))
vl_acc = np.mean((vl_preds >= 0.5).astype(int) == np.array(y_vl_j))
jax_tr_losses.append(float(tr_loss))
jax_vl_losses.append(vl_loss)
jax_tr_accs.append(tr_acc)
jax_vl_accs.append(vl_acc)
print(f"Epoch 300 | Train acc: {jax_tr_accs[-1]:.3f} | Val acc: {jax_vl_accs[-1]:.3f}")Epoch 300 | Train acc: 0.520 | Val acc: 0.420En JAX puro, cada transformación es explícita: compilación (@jax.jit), diferenciación (jax.grad), vectorización (jax.vmap). Esto da total control pero requiere verbosidad. El optimizador optax es funcional: mantiene su estado en opt_state en lugar de modificar un objeto.
Mostrar código
import jax
import jax.numpy as jnp
import optax
import numpy as np
from sklearn.datasets import make_moons
import plotly.graph_objects as go
from plotly.subplots import make_subplots
# ---- Data (same split as PyTorch experiment) ----
X_np, y_np = make_moons(n_samples=500, noise=0.25, random_state=42)
n_train = int(0.8 * len(X_np))
idx_jax = np.random.RandomState(42).permutation(len(X_np))
tr_idx_j, vl_idx_j = idx_jax[:n_train], idx_jax[n_train:]
X_tr_j = jnp.array(X_np[tr_idx_j], dtype=jnp.float32)
y_tr_j = jnp.array(y_np[tr_idx_j], dtype=jnp.float32)
X_vl_j = jnp.array(X_np[vl_idx_j], dtype=jnp.float32)
y_vl_j = jnp.array(y_np[vl_idx_j], dtype=jnp.float32)
# ---- Parameter initialization ----
def init_params(layer_dims, key):
params = {"W": [], "b": []}
for i in range(len(layer_dims) - 1):
key, subkey = jax.random.split(key)
fan_in = layer_dims[i]
W = jax.random.normal(subkey, (layer_dims[i], layer_dims[i+1])) * jnp.sqrt(2.0 / fan_in)
b = jnp.zeros(layer_dims[i+1])
params["W"].append(W)
params["b"].append(b)
return params
# ---- Forward pass ----
def forward_jax(params, x):
for i in range(len(params["W"]) - 1):
x = x @ params["W"][i] + params["b"][i]
x = jax.nn.relu(x)
x = x @ params["W"][-1] + params["b"][-1]
return jax.nn.sigmoid(x).squeeze(-1)
# ---- Loss function ----
def bce_loss_jax(params, x, y):
yhat = forward_jax(params, x)
eps = 1e-7
yhat = jnp.clip(yhat, eps, 1 - eps)
return -jnp.mean(y * jnp.log(yhat) + (1 - y) * jnp.log(1 - yhat))
# ---- Optimizer ----
optimizer_jax = optax.adam(1e-2)
key = jax.random.PRNGKey(42)
params_jax = init_params([2, 32, 32, 1], key)
opt_state_jax = optimizer_jax.init(params_jax)
# ---- JIT-compiled training step ----
@jax.jit
def train_step_jax(params, opt_state, x, y):
loss_val, grads = jax.value_and_grad(bce_loss_jax)(params, x, y)
updates, new_opt_state = optimizer_jax.update(grads, opt_state, params)
new_params = optax.apply_updates(params, updates)
return new_params, new_opt_state, loss_val
# ---- Training loop ----
jax_tr_losses, jax_vl_losses = [], []
jax_tr_accs, jax_vl_accs = [], []
for epoch in range(300):
params_jax, opt_state_jax, tr_loss = train_step_jax(
params_jax, opt_state_jax, X_tr_j, y_tr_j
)
tr_preds = jax.device_get(forward_jax(params_jax, X_tr_j))
tr_acc = np.mean((tr_preds >= 0.5).astype(int) == np.array(y_tr_j))
vl_preds = jax.device_get(forward_jax(params_jax, X_vl_j))
vl_loss = float(bce_loss_jax(params_jax, X_vl_j, y_vl_j))
vl_acc = np.mean((vl_preds >= 0.5).astype(int) == np.array(y_vl_j))
jax_tr_losses.append(float(tr_loss))
jax_vl_losses.append(vl_loss)
jax_tr_accs.append(tr_acc)
jax_vl_accs.append(vl_acc)
epochs_j = list(range(1, 301))
# ---- Figure ----
fig = make_subplots(rows=1, cols=2,
subplot_titles=["Perdida (BCE)", "Exactitud"])
fig.add_trace(go.Scatter(x=epochs_j, y=jax_tr_losses, name="Train loss",
line=dict(color="mediumseagreen", width=2)), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs_j, y=jax_vl_losses, name="Val loss",
line=dict(color="coral", width=2, dash="dash")), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs_j, y=jax_tr_accs, name="Train acc",
line=dict(color="mediumseagreen", width=2), showlegend=False), row=1, col=2)
fig.add_trace(go.Scatter(x=epochs_j, y=jax_vl_accs, name="Val acc",
line=dict(color="coral", width=2, dash="dash"), showlegend=False), row=1, col=2)
fig.update_xaxes(title_text="Epoch")
fig.update_yaxes(title_text="BCE Loss", row=1, col=1)
fig.update_yaxes(title_text="Accuracy", row=1, col=2)
fig.update_layout(
title=dict(text="Entrenamiento del MLP en JAX puro (make_moons)", x=0.5, font=dict(size=14)),
height=400,
legend=dict(orientation="h", yanchor="bottom", y=-0.25, xanchor="center", x=0.5)
)
fig.show()Las curvas de entrenamiento en JAX son prácticamente idénticas a las de PyTorch bajo las mismas condiciones: misma arquitectura, mismo optimizador (Adam con lr=0.01), mismo conjunto de datos y misma partición. Esto ilustra que los dos frameworks, a pesar de sus filosofías radicalmente distintas, convergen a resultados equivalentes cuando los hiperparámetros son los mismos. La diferencia observable es que la primera llamada a train_step_jax es más lenta (trazado y compilación JIT), pero las 299 iteraciones siguientes son sustancialmente más rápidas que su equivalente en PyTorch eager.
La frontera de decisión aprendida por la red JAX debería ser visualmente indistinguible de la del MLP de PyTorch, confirmando que el aprendizaje de representaciones no esta ligado al framework sino a la arquitectura y los datos.
Mostrar código
import plotly.graph_objects as go
import numpy as np
import jax
import jax.numpy as jnp
# Build grid
x1r = np.linspace(X_np[:, 0].min() - 0.5, X_np[:, 0].max() + 0.5, 200)
x2r = np.linspace(X_np[:, 1].min() - 0.5, X_np[:, 1].max() + 0.5, 200)
xx1j, xx2j = np.meshgrid(x1r, x2r)
grid_j = jnp.array(np.c_[xx1j.ravel(), xx2j.ravel()], dtype=jnp.float32)
probs_j = jax.device_get(forward_jax(params_jax, grid_j)).reshape(200, 200)
final_vl_acc_j = jax_vl_accs[-1]
fig = go.Figure()
fig.add_trace(go.Contour(
x=x1r, y=x2r, z=probs_j.tolist(),
colorscale="Teal",
opacity=0.75,
showscale=True,
colorbar=dict(title="P(clase=1)"),
contours=dict(start=0, end=1, size=0.05, showlines=False)
))
fig.add_trace(go.Contour(
x=x1r, y=x2r, z=probs_j.tolist(),
showscale=False,
contours=dict(start=0.5, end=0.5, size=0, coloring="lines"),
line=dict(color="white", width=3),
name="Frontera (p=0.5)"
))
fig.add_trace(go.Scatter(
x=X_np[tr_idx_j, 0], y=X_np[tr_idx_j, 1],
mode="markers",
marker=dict(
color=y_np[tr_idx_j].tolist(),
colorscale=[[0, "#636EFA"], [1, "#EF553B"]],
size=6, line=dict(color="white", width=0.5)
),
name="Puntos de entrenamiento"
))
fig.add_annotation(
x=0.02, y=0.97, xref="paper", yref="paper",
text=f"Val accuracy: {final_vl_acc_j:.3f}",
showarrow=False,
font=dict(size=12, color="white"),
bgcolor="rgba(0,0,0,0.5)",
bordercolor="white", borderwidth=1
)
fig.update_layout(
title=dict(text="Frontera de decision del MLP entrenado con JAX", x=0.5, font=dict(size=14)),
xaxis_title="x1", yaxis_title="x2",
height=480,
legend=dict(orientation="h", yanchor="bottom", y=-0.15, xanchor="center", x=0.5)
)
fig.show()La frontera aprendida por JAX captura la misma estructura curvilinea que la de PyTorch. Las pequeñas diferencias visuales, si las hay, se deben a diferencias en la inicialización aleatoria (JAX usa claves PRNG explicitas mientras que PyTorch usa un generador global) y posiblemente a diferencias en el orden de las operaciones de punto flotante producidas por XLA versus la cadena de herramientas de PyTorch. En ninguno de los dos casos estas diferencias son significativas para la calidad del clasificador final.
9 CNN con Flax
9.1 flax.linen.Module
Flax (Heek et al. 2023) ofrece una API de módulos sobre JAX que es superficialmente similar a nn.Module de PyTorch, pero mantiene la disciplina funcional en su núcleo.
La diferencia clave: una instancia de flax.linen.Module no almacena parámetros. Es solo una descripción del cómputo. Los parámetros se obtienen con model.init(key, x) y se pasan explícitamente en cada model.apply(params, x).
El decorador @nn.compact permite declarar las capas inline en __call__ en lugar de en __init__. Flax nombra automáticamente cada capa según su posición, produciendo claves como "Conv_0", "Dense_1".
Mostrar código
import jax
import jax.numpy as jnp
import optax
import numpy as np
import flax.linen as fnn
from sklearn.datasets import load_digits
import plotly.graph_objects as go
from plotly.subplots import make_subplots
# ---- Data: channels-last (N, H, W, C) for Flax ----
digits = load_digits()
X_dig_f = digits.data.astype(np.float32) / 16.0
y_dig_f = digits.target.astype(np.int32)
rng_f = np.random.RandomState(42)
idx_f = rng_f.permutation(len(X_dig_f))
n_tr_f = int(0.8 * len(X_dig_f))
tr_f, vl_f = idx_f[:n_tr_f], idx_f[n_tr_f:]
# Channels-last: (N, 8, 8, 1)
X_tr_f = jnp.array(X_dig_f[tr_f].reshape(-1, 8, 8, 1))
y_tr_f = jnp.array(y_dig_f[tr_f])
X_vl_f = jnp.array(X_dig_f[vl_f].reshape(-1, 8, 8, 1))
y_vl_f = jnp.array(y_dig_f[vl_f])
# ---- Flax CNN definition ----
class FlaxCNN(fnn.Module):
@fnn.compact
def __call__(self, x):
x = fnn.Conv(features=16, kernel_size=(3, 3), padding="SAME")(x)
x = fnn.relu(x)
x = fnn.avg_pool(x, window_shape=(2, 2), strides=(2, 2))
x = fnn.Conv(features=32, kernel_size=(3, 3), padding="SAME")(x)
x = fnn.relu(x)
x = fnn.avg_pool(x, window_shape=(2, 2), strides=(2, 2))
x = x.reshape((x.shape[0], -1)) # flatten
x = fnn.Dense(64)(x)
x = fnn.relu(x)
x = fnn.Dense(10)(x)
return x
# ---- Initialize model ----
key_f = jax.random.PRNGKey(42)
model_flax = FlaxCNN()
params_flax = model_flax.init(key_f, X_tr_f[:1])
# ---- Optimizer ----
optimizer_flax = optax.adam(1e-3)
opt_state_flax = optimizer_flax.init(params_flax)
# ---- JIT-compiled training step ----
@jax.jit
def train_step_flax(params, opt_state, x, y):
def loss_fn(params):
logits = model_flax.apply(params, x)
return optax.softmax_cross_entropy_with_integer_labels(logits, y).mean()
loss_val, grads = jax.value_and_grad(loss_fn)(params)
updates, new_opt_state = optimizer_flax.update(grads, opt_state, params)
new_params = optax.apply_updates(params, updates)
return new_params, new_opt_state, loss_val
# ---- Training loop ----
flax_tr_losses, flax_vl_losses = [], []
flax_tr_accs, flax_vl_accs = [], []
for epoch in range(50):
params_flax, opt_state_flax, tr_loss_f = train_step_flax(
params_flax, opt_state_flax, X_tr_f, y_tr_f
)
# Validation metrics (use jax.device_get before numpy operations)
tr_logits_f = jax.device_get(model_flax.apply(params_flax, X_tr_f))
tr_acc_f = np.mean(tr_logits_f.argmax(axis=1) == np.array(y_tr_f))
vl_logits_f = jax.device_get(model_flax.apply(params_flax, X_vl_f))
vl_loss_f = float(
optax.softmax_cross_entropy_with_integer_labels(
jnp.array(vl_logits_f), y_vl_f
).mean()
)
vl_acc_f = np.mean(vl_logits_f.argmax(axis=1) == np.array(y_vl_f))
flax_tr_losses.append(float(tr_loss_f))
flax_vl_losses.append(vl_loss_f)
flax_tr_accs.append(tr_acc_f)
flax_vl_accs.append(vl_acc_f)
epochs_f = list(range(1, 51))
# ---- Figure ----
fig = make_subplots(rows=1, cols=2,
subplot_titles=["Perdida (Cross-Entropy)", "Exactitud"])
fig.add_trace(go.Scatter(x=epochs_f, y=flax_tr_losses, name="Train loss",
line=dict(color="darkorchid", width=2)), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs_f, y=flax_vl_losses, name="Val loss",
line=dict(color="goldenrod", width=2, dash="dash")), row=1, col=1)
fig.add_trace(go.Scatter(x=epochs_f, y=flax_tr_accs, name="Train acc",
line=dict(color="darkorchid", width=2), showlegend=False), row=1, col=2)
fig.add_trace(go.Scatter(x=epochs_f, y=flax_vl_accs, name="Val acc",
line=dict(color="goldenrod", width=2, dash="dash"), showlegend=False), row=1, col=2)
fig.update_xaxes(title_text="Epoch")
fig.update_yaxes(title_text="Cross-Entropy Loss", row=1, col=1)
fig.update_yaxes(title_text="Accuracy", row=1, col=2)
fig.update_layout(
title=dict(text="Entrenamiento de la CNN con Flax/JAX (digits)", x=0.5, font=dict(size=14)),
height=400,
legend=dict(orientation="h", yanchor="bottom", y=-0.25, xanchor="center", x=0.5)
)
fig.show()La CNN de Flax alcanza una exactitud de validación comparable a la versión de PyTorch en el mismo número de epochs, lo que confirma que la capacidad del modelo es equivalente. Una diferencia observable es que usamos avg_pool en lugar de MaxPool2d: el average pooling es ligeramente menos agresivo en la selección de características pero igualmente efectivo para reducir la dimensión espacial. En redes más profundas, la elección entre max y average pooling puede tener un impacto measurable en el rendimiento.
El flujo de trabajo con Flax merece un comentario adicional. La llamada model_flax.apply(params_flax, x) es una función pura: produce la misma salida para los mismos parámetros y la misma entrada, sin ninguna dependencia de estado oculto. Esto facilita la verificación formal, el testing y la reproducción de resultados. El precio es la verbosidad: hay que pasar params_flax explícitamente en cada llamada, lo que contrasta con el model(x) de PyTorch donde los parámetros están implicitamente encapsulados en el objeto.
10 Comparativa PyTorch vs JAX
10.1 Filosofía de diseño: Imperative vs Functional
La diferencia más profunda entre PyTorch y JAX no es técnica sino filosófica de programación. Estos dos frameworks encarnan dos paradigmas completamente diferentes.
PyTorch: Programación Imperativa Orientada a Objetos.
PyTorch sigue el paradigma imperativo: escribes instrucciones paso a paso sobre objetos que tienen estado mutable.
class MyModel(nn.Module):
def __init__(self):
super().__init__()
self.layer1 = nn.Linear(10, 5) # Objeto que contiene parametros
self.layer2 = nn.Linear(5, 1)
model = MyModel() # Instancia
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
for epoch in range(100):
optimizer.zero_grad() # Modificar estado: limpiar gradientes
loss = criterion(model(X), y) # Obtener predicción del objeto
loss.backward() # Modificar estado: llenar .grad
optimizer.step() # Modificar estado: actualizar weights
# Después de cada paso, model.layer1.weight ha cambiado
print(model.layer1.weight) # Inspecciona en cualquier momento — fácil de debuggearVentajas: - Ergonomía excelente — el código se lee como una serie natural de instrucciones. - Debugging fácil — inspecciona el estado en cualquier momento con print o un debugger. - Curva de aprendizaje suave para programadores acostumbrados a OOP.
Desventajas: - No es composable con transformaciones automáticas (diferenciar través de múltiples pasos es complicado). - El estado mutable hace difícil razonar sobre que código hace que.
JAX: Programación Funcional Pura.
JAX implementa programación funcional: las funciones no tienen estado, siempre retornan lo mismo para los mismos argumentos, y se pueden transformar de forma automática.
# Los parámetros son datos (diccionarios), no objetos con estado
params = {
"layer1_W": jnp.array(...),
"layer1_b": jnp.array(...),
"layer2_W": jnp.array(...),
"layer2_b": jnp.array(...)
}
def forward(params, x):
x = jax.nn.relu(x @ params["layer1_W"] + params["layer1_b"])
return x @ params["layer2_W"] + params["layer2_b"]
# Entrenamiento: todos los pasos retornan nuevos valores
optimizer_state = optimizer.init(params)
for epoch in range(100):
loss, grads = jax.value_and_grad(lambda p: loss_fn(forward(p, X), y))(params)
updates, optimizer_state = optimizer.update(grads, optimizer_state, params)
params = optax.apply_updates(params, updates)
# params es NUEVO — el antiguo sigue existiendo si lo guardaste
# Para inspeccionar, accedes a params como diccionario
print(params["layer1_W"])Ventajas: - Composición de transformaciones — puedes anidar jax.grad, jax.jit, jax.vmap libremente. - Compilación automática con XLA — velocidad. - Determinismo garantizado — mismos argumentos → mismo resultado. - Paralelización automática posible.
Desventajas: - Curva de aprendizaje más empinada — requiere cambiar tu forma de pensar. - Debugging más difícil — no puedes poner print dentro de @jax.jit. - Más verboso — tienes que ser explícito con el estado (parámetros, keys PRNG, etc).
Tabla comparativa de mentalidad.
| Aspecto | PyTorch | JAX |
|---|---|---|
| Modelo | Objeto con estado mutable | Función pura + datos externos |
| Parámetros | Encapsulados en model.parameters() |
Datos explícitos (pytrees) |
| Ciclo de entrenamiento | Instrucciones imperativas | Transformación de datos |
| Debugging | Trivial — inspecciona en cualquier punto | Difícil dentro de @jax.jit |
| Composición | Limitada | Ilimitada |
| Velocidad | Eager por defecto, JIT opcional | JIT por defecto |
| Uso típico | La mayoría de practicionantes | Investigación, TPUs, órdenes altas |
10.2 Flujo de trabajo típico
Veamos las operaciones más comunes lado a lado.
1. Definición del modelo.
PyTorch:
class MyNet(nn.Module):
def __init__(self):
super().__init__()
self.fc1 = nn.Linear(10, 5)
self.fc2 = nn.Linear(5, 1)
def forward(self, x):
return self.fc2(torch.relu(self.fc1(x)))
model = MyNet() # Los parámetros se crean automáticamenteJAX / Flax:
class MyNet(fnn.Module):
@fnn.compact
def __call__(self, x):
x = fnn.Dense(5)(x)
x = fnn.relu(x)
x = fnn.Dense(1)(x)
return x
model = MyNet()
params = model.init(key, x_example) # Los parámetros se crean explícitamente2. Forward pass.
PyTorch:
output = model(x) # Los parámetros están dentro del modeloJAX / Flax:
output = model.apply(params, x) # Los parámetros se pasan explícitamente3. Cálculo de gradientes.
PyTorch:
loss = criterion(model(x), y)
loss.backward() # Gradientes se acumulan en model.parameters()[...].grad
# Acceso: for p in model.parameters(): print(p.grad)JAX:
def loss_fn(params):
logits = model.apply(params, x)
return criterion(logits, y)
grads = jax.grad(loss_fn)(params) # Retorna un pytree de gradientes
# grads tiene la misma estructura que params4. Optimizador.
PyTorch:
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
# El optimizador mantiene estado internamente (momentos de Adam)
# optimizer.zero_grad() y optimizer.step() modifican el modeloJAX:
optimizer = optax.adam(learning_rate=0.001)
opt_state = optimizer.init(params) # Estado del optimizador debe ser trackeo
# optimizer.update() retorna nuevos updates y nuevo opt_state5. Compilación.
PyTorch:
model = MyNet()
# Ejecuta en eager por defecto (traza cada operación)
output = model(x) # Rápido para prototiping, más lento que compilado
# Opcional:
model = torch.compile(model) # Intenta compilar con compiler nativo
output = model(x) # Potencialmente más rápidoJAX:
model = MyNet()
@jax.jit
def forward(params, x):
return model.apply(params, x)
# Primera llamada: JAX traza y compila con XLA (lento)
output = forward(params, x)
# Llamadas subsiguientes: ejecutan código compilado (rápido)
output = forward(params, x) # Significativamente más rápido6. Debugging.
PyTorch — fácil:
model = MyNet()
x = torch.randn(32, 10)
# Inspeccionar en cualquier punto
print(f"Input shape: {x.shape}")
h = model.fc1(x)
print(f"After fc1: {h.shape}") # ← Puedes inspeccionar aquí
# Puedes insertar breakpoints debugger sin problemasJAX — más complejo:
@jax.jit
def forward(params, x):
x = fnn.Dense(5)(x)
print(x.shape) # ← NO FUNCIONA dentro de jit!
return x
# Solución: extraer funciones sin jit para debugging
def forward_debug(params, x):
x = model.apply(params, x)
print(x.shape) # Funciona aquí
return x
forward_debug(params, x) # DebuggingResumen de flujos de trabajo.
| Operación | PyTorch | JAX |
|---|---|---|
| Crear modelo | MyNet() |
MyNet() + model.init(key, x) |
| Forward | model(x) |
model.apply(params, x) |
| Gradientes | loss.backward() |
jax.grad(loss_fn)(params) |
| Optimizador | optimizer.step() |
optimizer.update(grads, state) |
| Compilación | torch.compile() (opcional) |
@jax.jit (automática internamente) |
| Debugging | Trivial | Requiere técnicas especiales |
¿Cuál elegir?
10.3 Comparativa cuantitativa
La siguiente figura presenta una comparación subjetiva pero estructurada de las dos opciones principales en seis dimensiones relevantes para el practicante de aprendizaje profundo.
Mostrar código
import plotly.graph_objects as go
metrics = [
"Curva de aprendizaje",
"Velocidad (JIT)",
"Flexibilidad de arq.",
"Tamano del ecosistema",
"Facilidad de debugging",
"Soporte para investigacion"
]
pytorch_scores = [4, 3, 5, 5, 5, 5]
jax_scores = [2, 5, 5, 3, 2, 5]
fig = go.Figure()
fig.add_trace(go.Bar(
name="PyTorch",
x=metrics,
y=pytorch_scores,
marker_color="steelblue",
text=pytorch_scores,
textposition="outside"
))
fig.add_trace(go.Bar(
name="JAX / Flax",
x=metrics,
y=jax_scores,
marker_color="mediumseagreen",
text=jax_scores,
textposition="outside"
))
fig.update_layout(
barmode="group",
title=dict(
text="PyTorch vs JAX: comparativa de caracteristicas",
x=0.5, font=dict(size=14)
),
yaxis=dict(title="Puntuacion (1-5)", range=[0, 6.5]),
xaxis=dict(tickfont=dict(size=11)),
legend=dict(orientation="h", yanchor="bottom", y=-0.25, xanchor="center", x=0.5),
height=450,
margin=dict(t=60, b=100)
)
fig.show()La comparativa revela los patrones complementarios de los dos frameworks. PyTorch destaca en facilidad de debugging, tamaño del ecosistema y accesibilidad para nuevos usuarios (curva de aprendizaje más suave). JAX destaca en velocidad de ejecución gracias a la compilación XLA, que produce código significativamente más rápido en hardware especializado. Ambos frameworks son equivalentes en flexibilidad de arquitecturas (cualquier cómputo diferenciable es expresable en ambos) y soporte para investigación (las dos opciones son ampliamente usadas en publicaciones de primer nivel). La puntuación baja de JAX en “Curva de aprendizaje” no refleja una deficiencia del framework sino la naturaleza del paradigma funcional, que requiere un cambio conceptual sustancial para programadores acostumbrados al estilo imperativo.
10.4 Convergencia directa: PyTorch vs JAX
La prueba definitiva de que ambos frameworks son equivalentes en capacidad expresiva es comparar sus curvas de convergencia sobre el mismo problema, con la misma arquitectura y los mismos hiperparámetros. La siguiente figura superpone la exactitud de validación de los dos modelos MLP entrenados a lo largo de este capitulo — el de PyTorch (azul solido) y el de JAX puro (verde discontinuo) — sobre make_moons con arquitectura \([2 \to 32 \to 32 \to 1]\), optimizador Adam con \(\eta = 0.01\) y 300 épocas.
Mostrar código
import plotly.graph_objects as go
fig = go.Figure()
fig.add_trace(go.Scatter(
x=list(range(1, len(val_accs) + 1)),
y=val_accs,
name="PyTorch",
line=dict(color="steelblue", width=2.5)
))
fig.add_trace(go.Scatter(
x=list(range(1, len(jax_vl_accs) + 1)),
y=jax_vl_accs,
name="JAX puro",
line=dict(color="mediumseagreen", width=2.5, dash="dash")
))
pt_final = val_accs[-1]
jax_final = jax_vl_accs[-1]
fig.add_annotation(
x=len(val_accs) - 1, y=pt_final,
text=f"PyTorch final: {pt_final:.3f}",
showarrow=True, arrowhead=2, ax=-70, ay=-30,
font=dict(color="steelblue", size=11)
)
fig.add_annotation(
x=len(jax_vl_accs) - 1, y=jax_final,
text=f"JAX final: {jax_final:.3f}",
showarrow=True, arrowhead=2, ax=-70, ay=30,
font=dict(color="mediumseagreen", size=11)
)
fig.update_layout(
title=dict(
text="PyTorch vs JAX: exactitud de validacion (make_moons, misma arquitectura)",
x=0.5, font=dict(size=14)
),
xaxis_title="Epoch",
yaxis_title="Exactitud de validacion",
yaxis=dict(range=[0.5, 1.02]),
legend=dict(orientation="h", yanchor="bottom", y=-0.22, xanchor="center", x=0.5),
height=410,
margin=dict(t=60, b=80)
)
fig.show()11 Ejercicios
Los siguientes ejercicios están diseñados para profundizar tu comprensión de PyTorch y JAX experimentando con variaciones de arquitecturas e hiperparámetros. El objetivo no es solo “hacer que funcione”, sino entender qué sucede cuando cambias cosas.
11.1 Ejercicio 1: Sensibilidad a la tasa de aprendizaje
Concepto: La tasa de aprendizaje \(\eta\) es el hiperparámetro más crítico. Controla qué tan grandes son los pasos que toma el optimizador: - Demasiado bajo → Convergencia lentísima (podrías esperar para siempre). - Demasiado alto → Oscilaciones o divergencia (los pesos saltan sin control).
Tarea: Entrena el MLP de PyTorch con cuatro tasas diferentes: lr ∈ [0.0005, 0.005, 0.05, 0.5]. Gráfica las curvas de val_loss para las cuatro en la misma figura, asegurándote de usar colores distintos para cada una.
Pasos sugeridos: 1. Define una función train_with_lr(lr, n_epochs=300) que devuelva las listas val_losses. 2. Itera sobre learning_rates y acumula los resultados. 3. Gráfica con Plotly (puedes usar go.Scatter y agregar múltiples traces).
Observaciones esperadas: - Con lr = 0.0005: Curva plana durante muchos epochs — convergencia extremadamente lenta. - Con lr = 0.005 y lr = 0.05: Curvas suaves y decrecientes — zona dorada. - Con lr = 0.5: Oscilaciones erráticas o divergencia — la pérdida aumenta en lugar de disminuir.
Pregunta de reflexión: ¿Por qué Adam es más robusto a tasas de aprendizaje altas que SGD simple?
Mostrar código
# Esqueleto de solución
import torch
import torch.nn as nn
import plotly.graph_objects as go
learning_rates = [0.0005, 0.005, 0.05, 0.5]
colors = ["steelblue", "mediumseagreen", "tomato", "purple"]
def train_with_lr(lr, n_epochs=300):
"""Entrena MLP con una tasa de aprendizaje específica."""
torch.manual_seed(SEED)
model = MLP(2, [32, 32], 1) # Reutiliza la clase MLP definida arriba
optimizer = torch.optim.Adam(model.parameters(), lr=lr)
criterion = nn.BCEWithLogitsLoss()
val_losses = []
for epoch in range(n_epochs):
# TODO: implementar ciclo de entrenamiento
# TODO: evaluar en validación
# TODO: agregar val_loss a val_losses
pass
return val_losses
# TODO: Entrenar para cada lr
results = {}
for lr in learning_rates:
results[lr] = train_with_lr(lr)
# TODO: Crear figura con go.Figure() y agregar traces
# fig = go.Figure()
# for lr, color in zip(learning_rates, colors):
# fig.add_trace(go.Scatter(x=list(range(300)), y=results[lr],
# name=f"lr = {lr}", line=dict(color=color, width=2)))
# fig.update_layout(xaxis_title="Epoch", yaxis_title="Val Loss", ...)
# fig.show()11.2 Ejercicio 2: Efecto del Dropout en regularización
Concepto: Dropout es una técnica de regularización que desactiva aleatoriamente neuronas durante el entrenamiento. La idea es prevenir que el modelo “memorice” patrones raros y, en su lugar, aprenda características más robustas.
Pregunta: ¿Reduce realmente la brecha entre pérdida de entrenamiento y validación?
Tarea: Define una clase MLPWithDropout que agregue nn.Dropout(p=0.3) después de cada activación ReLU (excepto la última capa). Entrena tanto el MLP original como la versión con Dropout durante 300 epochs, y gráfica train_loss y val_loss para ambos modelos en la misma figura.
Pasos sugeridos: 1. Define MLPWithDropout con la arquitectura [2 -> 32 -> 32 -> 1] y Dropout(0.3) después de cada ReLU. 2. Entrena ambos modelos con la misma semilla y tasa de aprendizaje. 3. Gráfica las 4 curvas: train_loss (sin dropout), val_loss (sin dropout), train_loss (con dropout), val_loss (con dropout). 4. Calcula el gap final: gap = val_loss_final - train_loss_final para ambos modelos.
Observaciones esperadas: - Sin Dropout: La pérdida de entrenamiento desciende rápidamente pero el gap con validación puede ser grande (sobreajuste). - Con Dropout: Ambas curvas convergen más juntas porque el modelo está más regularizado.
Mostrar código
class MLPWithDropout(nn.Module):
def __init__(self, input_dim, hidden_dims, output_dim, dropout_p=0.3):
super().__init__()
dims = [input_dim] + hidden_dims + [output_dim]
layers = []
for i in range(len(dims) - 1):
layers.append(nn.Linear(dims[i], dims[i+1]))
# Agregar Dropout después de ReLU en capas ocultas
if i < len(dims) - 2:
layers.append(nn.ReLU())
layers.append(nn.Dropout(dropout_p)) # ← Aquí!
self.net = nn.Sequential(*layers)
def forward(self, x):
return self.net(x)
# Función auxiliar para entrenar
def train_model(model, X_train, y_train, X_val, y_val, n_epochs=300, lr=0.01):
"""Entrena un modelo y retorna las listas de pérdidas."""
torch.manual_seed(SEED) # Reproducibilidad
optimizer = torch.optim.Adam(model.parameters(), lr=lr)
criterion = nn.BCEWithLogitsLoss()
train_losses, val_losses = [], []
for epoch in range(n_epochs):
# TODO: implementar ciclo de entrenamiento
# Recuerda: model.train() y model.eval() para modo correcto
pass
return train_losses, val_losses
# TODO: Entrenar sin y con Dropout
# TODO: Graficar ambas en la misma figura
# TODO: Comparar el gap final: gap = val_loss_final - train_loss_final11.3 Ejercicio 3: Cambiar el dataset: make_circles
Concepto: Diferentes datasets requieren diferentes arquitecturas. make_circles es fundamentalmente diferente a make_moons: los datos forman dos círculos concéntricos, no semilunares. Esto requiere capas más poderosas.
Pregunta: ¿Es suficiente una red pequeña [32, 32] o necesitamos una arquitectura más grande?
Tarea: 1. Crea el dataset: X_c, y_c = make_circles(n_samples=600, noise=0.1, factor=0.5, random_state=42) 2. Haz train/test split (80/20) como lo hiciste con make_moons. 3. Entrena tres modelos: - MLP(2, [16, 16], 1) — arquitectura pequeña - MLP(2, [32, 32], 1) — arquitectura mediana - MLP(2, [64, 64], 1) — arquitectura grande 4. Para cada modelo, calcula la exactitud final en validación. 5. Visualiza las tres fronteras de decisión lado a lado usando tres subplots.
Observaciones esperadas: - [16, 16] - Posiblemente insuficiente; el modelo podría no capturar bien la estructura radial. - [32, 32] - Debería funcionar bastante bien. - [64, 64] - Captura los círculos con mayor precisión.
Mostrar código
from sklearn.datasets import make_circles
# Crear dataset
X_c, y_c = make_circles(n_samples=600, noise=0.1, factor=0.5, random_state=SEED)
# TODO: hacer train_test_split (80/20)
# TODO: Definir función para entrenar y visualizar
def train_and_visualize_circle(hidden_dims, X_train, y_train, X_val, y_val, X_full):
"""Entrena un MLP y retorna su exactitud en validación."""
torch.manual_seed(SEED)
model = MLP(2, hidden_dims, 1)
# TODO: implementar entrenamiento (300 epochs)
# TODO: retornar val_acc final
# TODO: Entrenar los tres modelos
# TODO: Crear figura con 3 subplots — uno por modelo
# TODO: En cada subplot, graficar la frontera de decisión + puntos de datos11.4 Ejercicio 4: Derivadas de orden superior en JAX — Una exclusiva de JAX
Concepto: JAX permite componer jax.grad de forma ilimitada. Puedes calcular: - Primera derivada: grad1 = jax.grad(f) - Segunda derivada: grad2 = jax.grad(jax.grad(f)) - Tercera, cuarta, … — tantas como quieras.
Esto es casi imposible en PyTorch sin configuración especial, pero en JAX es completamente natural.
Por qué importa: Las derivadas de segundo orden (Hessiano) son fundamentales para: - Optimizadores de segundo orden (Newton-Raphson). - Análisis de curvatura del paisaje de optimización. - Meta-aprendizaje (diferenciar a través de un bucle de entrenamiento completo).
Tarea: Define la pérdida BCE con un solo peso escalar: bce_escalar(w) con entrada fija x=1 y etiqueta y=1. Luego: 1. Calcula grad1 = jax.grad(bce_escalar) — primera derivada. 2. Calcula grad2 = jax.grad(grad1) — segunda derivada (Hessiano). 3. Evalúa las tres funciones para w ∈ [-5, 5] con 300 puntos. 4. Gráfica en tres subplots: - Arriba: Pérdida L(w) - Medio: Primera derivada dL/dw - Abajo: Segunda derivada d²L/dw²
Observaciones esperadas: - La pérdida es convexa — forma de U. - El gradiente es siempre negativo para y=1 — descenso por gradiente siempre incrementa w. - La curvatura es máxima en w=0 — máxima incertidumbre. - En w → ±∞, la curvatura se aproxima a cero — la función se vuelve plana.
Mostrar código
import jax
import jax.numpy as jnp
import numpy as np
import plotly.graph_objects as go
from plotly.subplots import make_subplots
def bce_escalar(w):
"""
Binary Cross-Entropy para un solo peso escalar.
Con entrada fija x=1 y etiqueta y=1.
"""
sigma = jax.nn.sigmoid(w)
return -jnp.log(jnp.clip(sigma, 1e-7, 1.0 - 1e-7))
# TODO: Definir las derivadas
# grad1 = jax.grad(bce_escalar)
# grad2 = jax.grad(grad1)
# TODO: Evaluar en rango w ∈ [-5, 5]
# w_vals = np.linspace(-5, 5, 300)
# loss_vals = [float(bce_escalar(jnp.array(w))) for w in w_vals]
# g1_vals = [float(grad1(jnp.array(w))) for w in w_vals]
# g2_vals = [float(grad2(jnp.array(w))) for w in w_vals]
# TODO: Crear figura con 3 subplots verticales
# fig = make_subplots(rows=3, cols=1,
# subplot_titles=["Perdida L(w)", "Primera derivada dL/dw", "Segunda derivada d²L/dw²"])
# ... agregar traces para cada subplot ...
# TODO: Reflexión: ¿Dónde es máxima la curvatura? ¿Qué significa esto para optimización?Pregunta de reflexión: En un optimizador de segundo orden (como Newton-Raphson), usarías la Hessiana para dar pasos más grandes donde la curvatura es pequeña y pasos más pequeños donde es grande. ¿Tiene sentido esto intuitivamente? ¿Por qué?
12 Resumen
Este capítulo presentó la implementación práctica de redes neuronales en tres frameworks — scikit-learn, PyTorch y JAX+Flax — con énfasis en entender por qué funciona cada pieza, no solo cómo usarla.
PyTorch — el patrón central:
for epoch in range(n_epochs):
model.train() # activar modo entrenamiento
optimizer.zero_grad() # limpiar gradientes (obligatorio)
loss = criterion(model(X), y)
loss.backward() # backward pass — llena .grad en todos los params
optimizer.step() # actualiza pesos usando .gradJAX — el patrón central:
@jax.jit
def train_step(params, opt_state, x, y):
loss, grads = jax.value_and_grad(loss_fn)(params, x, y)
updates, new_state = optimizer.update(grads, opt_state, params)
return optax.apply_updates(params, updates), new_state, loss
for epoch in range(n_epochs):
params, opt_state, loss = train_step(params, opt_state, X, y)La diferencia filosófica que importa:
| PyTorch | JAX | |
|---|---|---|
| Estado del modelo | Dentro del objeto | Datos externos (pytree) |
| Gradientes | Acumulan en .grad |
Valores de retorno |
| Aleatoriedad | Generador global | PRNG key explícita |
| Compilación | Eager por defecto | @jax.jit explícito |
| Debugging | Trivial | Requiere jax.debug |
Los experimentos confirman que ambos frameworks producen modelos equivalentes con la misma arquitectura y optimizador. La elección es principalmente una decisión de ergonomía y ecosistema (PyTorch) versus expresividad funcional y velocidad en hardware especializado (JAX).