---
title: "Clustering jerárquico"
description: "Desarrolla el clustering jerárquico aglomerativo y divisivo, la construcción del dendrograma y los criterios de enlace entre grupos."
pagetitle: "Clustering jerárquico"
open-graph:
description: "Desarrolla el clustering jerárquico aglomerativo y divisivo, la construcción del dendrograma y los criterios de enlace entre grupos."
twitter-card:
description: "Desarrolla el clustering jerárquico aglomerativo y divisivo, la construcción del dendrograma y los criterios de enlace entre grupos."
author: "Diego Villalba"
date: today
lang: es
format:
html:
toc: true
toc-depth: 3
toc-title: "Contenido"
number-sections: true
code-fold: true
code-tools: true
code-summary: "Mostrar código"
fig-align: center
theme: cosmo
highlight-style: github
smooth-scroll: true
pdf:
toc: true
toc-depth: 3
number-sections: true
documentclass: scrbook
papersize: letter
fontsize: 11pt
geometry: margin=2.5cm
keep-tex: false
execute:
echo: true
warning: false
message: false
cache: false
bibliography: [referencias_clustering.bib, ../../references.bib]
crossref:
fig-title: "Figura"
tbl-title: "Tabla"
eq-prefix: "Ec."
jupyter: python3
---
El clustering jerárquico construye una jerarquía anidada de agrupaciones en vez de producir una única partición. Esta jerarquía se representa como un árbol binario llamado dendrograma, en el que las hojas son las observaciones individuales y la raíz es un único grupo que contiene a todas. El analista puede cortar el dendrograma a cualquier altura para obtener una partición con el número de grupos deseado.
Esta propiedad hace que el clustering jerárquico sea especialmente útil cuando no se conoce de antemano el número de grupos, o cuando se desea explorar estructuras a distintos niveles de granularidad. Además, el dendrograma proporciona una representación visual rica de la estructura de los datos que facilita la interpretación.
Existen dos enfoques principales: el método aglomerativo, que comienza con cada observación como su propio grupo y va fusionando los más similares; y el método divisivo, que parte de un único grupo y lo va partiendo recursivamente. El método aglomerativo es más común en la práctica y está mejor estudiado teóricamente [@hastie2009; @aggarwal2013].
## Método aglomerativo
El algoritmo aglomerativo genérico opera sobre la matriz de distancias entre grupos.
::: {.callout-note appearance="minimal"}
**Algoritmo aglomerativo.**
**Entrada:** observaciones $\mathbf{x}_1,\dots,\mathbf{x}_n$, función de enlace $d$.
1. Inicializar $n$ grupos $C_i=\{\mathbf{x}_i\}$ para $i=1,\dots,n$.
2. Calcular la matriz de distancias $D$ de tamaño $n\times n$ con $D_{ij}=d(\mathbf{x}_i,\mathbf{x}_j)$.
3. Repetir hasta que quede un solo grupo:
a. Encontrar el par $(i,j)$ con $D_{ij}$ mínima.
b. Fusionar $C_i$ y $C_j$ en un nuevo grupo $C_{ij}$.
c. Actualizar $D$ con las distancias del nuevo grupo a todos los demás.
4. Registrar la secuencia de fusiones y sus alturas.
**Salida:** dendrograma con todas las fusiones.
:::
La diferencia entre las variantes del método aglomerativo está en cómo se define la distancia $d$ entre grupos —el criterio de enlace.
## Criterios de enlace
El criterio de enlace determina la distancia entre dos grupos como función de las distancias entre sus elementos. Los criterios más usados son los siguientes.
::: {.callout-note appearance="minimal"}
**Enlace simple (single linkage).** La distancia entre dos grupos es la distancia mínima entre cualquier par de observaciones, una de cada grupo:
$$
d_{\text{simple}}(C_i,C_j) = \min_{\mathbf{x}\in C_i,\mathbf{y}\in C_j} d(\mathbf{x},\mathbf{y}).
$$ {#eq-single-linkage}
:::
::: {.callout-note appearance="minimal"}
**Enlace completo (complete linkage).** La distancia entre dos grupos es la distancia máxima entre cualquier par de observaciones, una de cada grupo:
$$
d_{\text{completo}}(C_i,C_j) = \max_{\mathbf{x}\in C_i,\mathbf{y}\in C_j} d(\mathbf{x},\mathbf{y}).
$$ {#eq-complete-linkage}
:::
::: {.callout-note appearance="minimal"}
**Enlace promedio (average linkage / UPGMA).** La distancia entre dos grupos es el promedio de todas las distancias por pares:
$$
d_{\text{prom}}(C_i,C_j) = \frac{1}{|C_i||C_j|}\sum_{\mathbf{x}\in C_i}\sum_{\mathbf{y}\in C_j}d(\mathbf{x},\mathbf{y}).
$$ {#eq-average-linkage}
:::
::: {.callout-note appearance="minimal"}
**Enlace de Ward.** Fusiona los dos grupos cuya unión produce el menor incremento en la suma de cuadrados intra-grupo [@ward1963]:
$$
d_{\text{Ward}}(C_i,C_j) = \frac{|C_i||C_j|}{|C_i|+|C_j|}\|\boldsymbol{\mu}_i-\boldsymbol{\mu}_j\|^2,
$$ {#eq-ward-linkage}
donde $\boldsymbol{\mu}_i$ y $\boldsymbol{\mu}_j$ son los centroides de $C_i$ y $C_j$.
:::
El enlace simple tiende a producir dendrogramas con efecto de encadenamiento: grupos alargados en los que se van añadiendo puntos uno por uno. El enlace completo produce grupos más compactos pero puede ser sensible a outliers. El enlace de Ward minimiza la varianza intra-grupo en cada fusión, por lo que tiende a producir grupos de tamaño parecido y es el más usado en la práctica.
```{=html}
<div id="hc-wrap" style="font-family:Georgia,serif;max-width:700px;margin:2em auto;background:#f9fafc;border:1px solid #d0d7e3;border-radius:10px;padding:20px 24px;box-shadow:0 2px 12px rgba(30,60,120,.07);">
<div style="text-align:center;margin-bottom:12px;">
<span style="font-size:1.05em;font-weight:bold;color:#1a2e45;">Clustering jerárquico — dendrograma interactivo</span><br>
<span style="font-size:0.81em;color:#666;">Selecciona el criterio de enlace y mueve el umbral de corte para ver los grupos resultantes</span>
</div>
<div style="display:flex;align-items:center;gap:12px;margin-bottom:10px;flex-wrap:wrap;">
<label style="font-size:0.83em;color:#444;">Enlace:</label>
<select id="hc-link" style="font-size:0.83em;padding:3px 8px;border:1px solid #d0d7e3;border-radius:5px;background:#fff;">
<option value="ward">Ward</option>
<option value="complete">Completo</option>
<option value="single">Simple</option>
<option value="average">Promedio</option>
</select>
<label style="font-size:0.83em;color:#444;margin-left:12px;">Umbral = <strong id="hc-tv">1.8</strong></label>
<input id="hc-tsl" type="range" min="0" max="100" step="1" value="45" style="flex:1;min-width:120px;accent-color:#1a3a5c;">
</div>
<div id="hc-info" style="text-align:center;font-size:0.82em;padding:5px 10px;background:#fff;border:1px solid #e0e5ed;border-radius:5px;margin-bottom:10px;min-height:22px;"></div>
<canvas id="hc-cv" style="display:block;width:100%;border-radius:6px;border:1px solid #e0e5ed;background:#fff;"></canvas>
</div>
<script>
(function(){
const PTS=[
[1.0,1.2],[1.4,0.8],[0.8,1.5],[1.2,0.7],[1.6,1.4],[0.9,0.9],
[4.5,4.8],[4.9,4.2],[4.2,5.0],[4.7,4.4],[5.2,4.7],[4.3,4.0],
[7.8,1.8],[7.2,2.2],[8.1,1.3],[7.5,2.0],[7.0,1.7],[7.9,2.4]
];
const N=PTS.length;
const COLS=['#2563eb','#dc2626','#16a34a','#f59e0b','#7c3aed','#0891b2','#be185d','#0f766e'];
const cv=document.getElementById('hc-cv');
const W=680,H=380,DPR=window.devicePixelRatio||1;
cv.width=W*DPR;cv.height=H*DPR;cv.style.width=W+'px';cv.style.height=H+'px';
const ctx=cv.getContext('2d');ctx.scale(DPR,DPR);
function eucl(a,b){return Math.sqrt((a[0]-b[0])**2+(a[1]-b[1])**2);}
function buildDendrogram(link){
const clusters=PTS.map((_,i)=>({pts:[i],height:0,left:null,right:null,id:i}));
const merges=[];
while(clusters.length>1){
let minD=Infinity,bi=-1,bj=-1;
for(let i=0;i<clusters.length;i++)for(let j=i+1;j<clusters.length;j++){
const d=linkDist(clusters[i],clusters[j],link);
if(d<minD){minD=d;bi=i;bj=j;}
}
const newC={pts:[...clusters[bi].pts,...clusters[bj].pts],height:minD,left:clusters[bi],right:clusters[bj],id:N+merges.length};
merges.push({c1:clusters[bi],c2:clusters[bj],h:minD,merged:newC});
clusters.splice(bj,1);clusters.splice(bi,1);clusters.push(newC);
}
return{root:clusters[0],merges};
}
function linkDist(ca,cb,link){
const pairs=[];
ca.pts.forEach(i=>cb.pts.forEach(j=>pairs.push(eucl(PTS[i],PTS[j]))));
if(link==='single')return Math.min(...pairs);
if(link==='complete')return Math.max(...pairs);
if(link==='average')return pairs.reduce((s,v)=>s+v,0)/pairs.length;
if(link==='ward'){
const na=ca.pts.length,nb=cb.pts.length;
const muA=ca.pts.reduce((s,i)=>[s[0]+PTS[i][0],s[1]+PTS[i][1]],[0,0]).map(v=>v/na);
const muB=cb.pts.reduce((s,i)=>[s[0]+PTS[i][0],s[1]+PTS[i][1]],[0,0]).map(v=>v/nb);
return(na*nb)/(na+nb)*eucl(muA,muB)**2;
}
return 0;
}
function assignColors(root,threshold){
const labels=new Array(N).fill(0);
let ci=0;
function visit(node){
if(node.height<=threshold||(!node.left&&!node.right)){
node.pts.forEach(i=>labels[i]=ci);ci++;
} else {if(node.left)visit(node.left);if(node.right)visit(node.right);}
}
visit(root);
return{labels,nGroups:ci};
}
function leafOrder(node){
if(!node.left&&!node.right)return[node.id];
return[...leafOrder(node.left),...leafOrder(node.right)];
}
let dend=buildDendrogram('ward');
function draw(threshold){
const{labels,nGroups}=assignColors(dend.root,threshold);
ctx.clearRect(0,0,W,H);
// Left: scatter
const LP={l:44,r:W/2-8,t:16,b:H-28};
const LW=LP.r-LP.l,LH=LP.b-LP.t;
const xMn=0,xMx=9,yMn=0,yMx=7;
const sx=x=>LP.l+(x-xMn)/xMx*LW,sy=y=>LP.t+LH*(1-(y-yMn)/yMx);
ctx.fillStyle='#f8f9fb';ctx.fillRect(LP.l,LP.t,LW,LH);
ctx.strokeStyle='#9aa3b5';ctx.lineWidth=1;ctx.strokeRect(LP.l,LP.t,LW,LH);
PTS.forEach((p,i)=>{
ctx.beginPath();ctx.arc(sx(p[0]),sy(p[1]),6,0,2*Math.PI);
ctx.fillStyle=COLS[labels[i]%COLS.length]+'cc';ctx.fill();
ctx.strokeStyle='#fff';ctx.lineWidth=1.5;ctx.stroke();
});
ctx.fillStyle='#1a2e45';ctx.font='bold 11px Georgia,serif';ctx.textAlign='center';
ctx.fillText('Scatter ('+nGroups+' grupos)',LP.l+LW/2,LP.t-4);
// Right: dendrogram
const RP={l:W/2+8,r:W-10,t:16,b:H-28};
const RW=RP.r-RP.l,RH=RP.b-RP.t;
ctx.fillStyle='#f8f9fb';ctx.fillRect(RP.l,RP.t,RW,RH);
ctx.strokeStyle='#9aa3b5';ctx.lineWidth=1;ctx.strokeRect(RP.l,RP.t,RW,RH);
const order=leafOrder(dend.root).filter(id=>id<N);
const maxH=dend.root.height*1.1||1;
const dx=RW/(N+1);
const dendY=h=>RP.b-4-h/maxH*(RH-20);
const leafX=new Map();
order.forEach((id,i)=>leafX.set(id,RP.l+dx*(i+1)));
function drawNode(node,col){
if(!node.left&&!node.right){
const x=leafX.get(node.id);
ctx.beginPath();ctx.arc(x,dendY(0),3,0,2*Math.PI);
ctx.fillStyle=COLS[labels[node.id]%COLS.length];ctx.fill();
ctx.fillStyle='#555';ctx.font='8px Georgia,serif';ctx.textAlign='center';
ctx.fillText(node.id+1,x,RP.b+10);
return x;
}
const lx=drawNode(node.left,col);
const rx=drawNode(node.right,col);
const my=dendY(node.height);
const isAbove=node.height>threshold;
const c=isAbove?'#94a3b8':COLS[labels[node.pts[0]]%COLS.length];
ctx.strokeStyle=c;ctx.lineWidth=isAbove?1.2:2;
ctx.beginPath();ctx.moveTo(lx,dendY(node.left.height));ctx.lineTo(lx,my);ctx.lineTo(rx,my);ctx.lineTo(rx,dendY(node.right.height));ctx.stroke();
return(lx+rx)/2;
}
drawNode(dend.root,'#1a3a5c');
// Threshold line
const ty=dendY(threshold);
ctx.strokeStyle='#f59e0b';ctx.lineWidth=2;ctx.setLineDash([6,3]);
ctx.beginPath();ctx.moveTo(RP.l+2,ty);ctx.lineTo(RP.r-2,ty);ctx.stroke();
ctx.setLineDash([]);
ctx.fillStyle='#f59e0b';ctx.font='bold 9px Georgia,serif';ctx.textAlign='right';
ctx.fillText('umbral='+threshold.toFixed(2),RP.r-4,ty-4);
ctx.fillStyle='#1a2e45';ctx.font='bold 11px Georgia,serif';ctx.textAlign='center';
ctx.fillText('Dendrograma',RP.l+RW/2,RP.t-4);
document.getElementById('hc-info').innerHTML=
`Enlace: <strong>${document.getElementById('hc-link').value}</strong> · `+
`Umbral = <strong>${threshold.toFixed(2)}</strong> · `+
`Grupos = <strong>${nGroups}</strong>`;
}
function update(){
const link=document.getElementById('hc-link').value;
dend=buildDendrogram(link);
const t01=parseFloat(document.getElementById('hc-tsl').value)/100;
const threshold=t01*dend.root.height*1.1;
document.getElementById('hc-tv').textContent=threshold.toFixed(2);
draw(threshold);
}
document.getElementById('hc-link').addEventListener('change',update);
document.getElementById('hc-tsl').addEventListener('input',function(){
const t01=parseFloat(this.value)/100;
const threshold=t01*dend.root.height*1.1;
document.getElementById('hc-tv').textContent=threshold.toFixed(2);
draw(threshold);
});
update();
})();
</script>
```
## El dendrograma
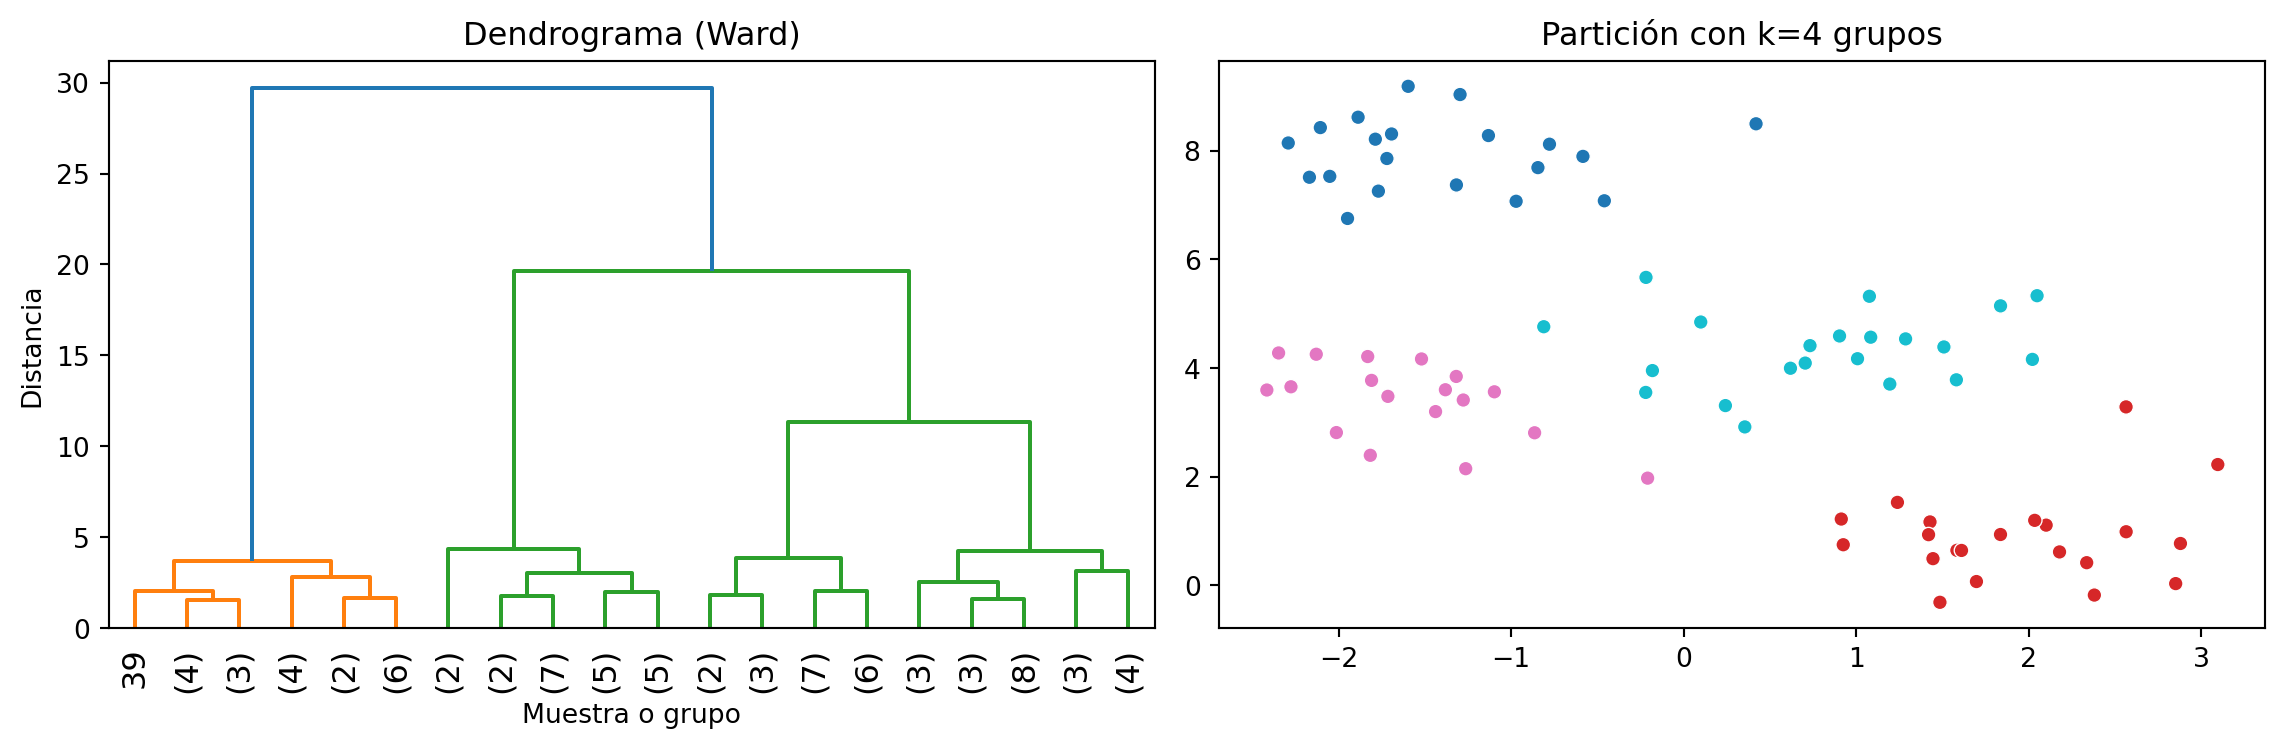
El dendrograma es una representación en árbol de la historia de fusiones. En el eje vertical se grafica la distancia (o altura) a la que se realiza cada fusión; en el eje horizontal se ubican las observaciones individuales. Una línea horizontal a altura $h$ divide el dendrograma en los grupos que existían en ese momento.
Para extraer un número de grupos específico se corta el dendrograma con una línea horizontal. El número de ramas que esa línea intersecta es el número de grupos resultantes. La altura del corte puede elegirse visualmente buscando el mayor salto vertical en el dendrograma, lo que corresponde a fusiones que unen grupos bien separados.
## Correlación cofenética
La correlación cofenética mide qué tan fielmente el dendrograma representa las distancias originales. La distancia cofenética entre dos puntos $\mathbf{x}_i$ y $\mathbf{x}_j$ es la altura a la que se fusionan por primera vez en el dendrograma.
::: {.callout-note appearance="minimal"}
Definición. La correlación cofenética $r_c$ es la correlación de Pearson entre la matriz de distancias originales y la matriz de distancias cofenéticas:
$$
r_c = \text{corr}(d_{ij}, c_{ij}),
$$ {#eq-cophenetic}
donde $d_{ij}$ es la distancia original y $c_{ij}$ es la distancia cofenética entre $\mathbf{x}_i$ y $\mathbf{x}_j$.
:::
Un valor de $r_c$ cercano a 1 indica que el dendrograma preserva bien la estructura de distancias. El enlace promedio suele producir los mayores valores de correlación cofenética.
```{python}
import numpy as np
from sklearn.datasets import make_blobs
from scipy.cluster.hierarchy import linkage, dendrogram, cophenet
from scipy.spatial.distance import pdist

X, y_true = make_blobs(n_samples=80, centers=3, cluster_std=0.8, random_state=42)

for method in ["single", "complete", "average", "ward"]:
    Z = linkage(X, method=method)
    c, _ = cophenet(Z, pdist(X))
    print(f"{method:10s}  r_cofenética = {c:.4f}")
```
```{python}
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster
import numpy as np
from sklearn.datasets import make_blobs

X, _ = make_blobs(n_samples=80, centers=4, cluster_std=0.7, random_state=0)

Z = linkage(X, method="ward")

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4))

dendrogram(Z, ax=ax1, truncate_mode="lastp", p=20, leaf_rotation=90,
           color_threshold=0.7 * max(Z[:, 2]))
ax1.set_title("Dendrograma (Ward)")
ax1.set_xlabel("Muestra o grupo")
ax1.set_ylabel("Distancia")

labels = fcluster(Z, t=4, criterion="maxclust")
ax2.scatter(X[:, 0], X[:, 1], c=labels, cmap="tab10", s=30, edgecolors="white", linewidths=0.5)
ax2.set_title("Partición con k=4 grupos")
plt.tight_layout()
plt.show()
```
## Complejidad y escalabilidad
El algoritmo aglomerativo ingenuo requiere $O(n^2)$ espacio para la matriz de distancias y $O(n^3)$ tiempo para las $n-1$ fusiones, ya que en cada paso debe recalcular las distancias entre el nuevo grupo y los demás. Para enlace simple y completo existen algoritmos como SLINK y CLINK con complejidad $O(n^2)$ en tiempo y $O(n)$ en espacio.
Para conjuntos de datos grandes ($n > 10\,000$), el clustering jerárquico estándar se vuelve poco práctico. Algunas alternativas son:
- **BIRCH**: construye un resumen compacto de los datos (CF-tree) y luego aplica clustering jerárquico sobre los resúmenes.
- **Clustering jerárquico aproximado**: usando índices de vecinos más cercanos aproximados para reducir el número de comparaciones.
- **Mini-batch clustering**: submuestrear el conjunto de datos y extrapolar la estructura jerárquica.
```{python}
from sklearn.datasets import make_blobs
from sklearn.cluster import AgglomerativeClustering
from sklearn.metrics import silhouette_score
import numpy as np

X, y_true = make_blobs(n_samples=300, centers=4, cluster_std=0.8, random_state=0)

for linkage in ["ward", "complete", "average", "single"]:
    model = AgglomerativeClustering(n_clusters=4, linkage=linkage)
    labels = model.fit_predict(X)
    sil = silhouette_score(X, labels)
    print(f"{linkage:10s}  silueta = {sil:.4f}")
```
## Aplicaciones del clustering jerárquico
El clustering jerárquico se usa extensamente en bioinformática para agrupar genes o muestras en experimentos de expresión génica, donde el dendrograma permite visualizar tanto la agrupación de genes similares como su grado de similitud a distintas escalas. En análisis de texto, se usa para construir taxonomías temáticas. En finanzas, para clasificar activos con comportamientos similares.
Una ventaja clave sobre K-Means es que no requiere especificar el número de grupos de antemano. El dendrograma muestra de forma explícita las estructuras a distintos niveles, lo que facilita la toma de decisiones sobre la granularidad apropiada para el problema.