---
title: "Árboles de decisión: ID3 y C4.5"
pagetitle: "Árboles de decisión: entropía, ganancia de información, ID3 y C4.5"
open-graph:
description: "Árboles de decisión para clasificación: algoritmo de Hunt, entropía, ganancia de información, ID3, razón de ganancia de C4.5, atributos continuos, valores faltantes, poda y extracción de reglas, con desarrollo manual, laboratorio interactivo y Python."
twitter-card:
description: "Árboles de decisión para clasificación: algoritmo de Hunt, entropía, ganancia de información, ID3, razón de ganancia de C4.5, atributos continuos, valores faltantes, poda y extracción de reglas, con desarrollo manual, laboratorio interactivo y Python."
description: "Árboles de decisión para clasificación: algoritmo de Hunt, entropía, ganancia de información, ID3, razón de ganancia de C4.5, atributos continuos, valores faltantes, poda y extracción de reglas, con desarrollo manual, laboratorio interactivo y Python."
author: "Diego Villalba"
lang: es
format:
html:
toc: true
toc-depth: 3
toc-title: "Contenido"
code-fold: true
code-tools: true
code-summary: "Mostrar código"
theme: cosmo
highlight-style: github
execute:
echo: true
warning: false
message: false
bibliography: [referencias_fundamentos_clasificacion.bib, referencias_clasificacion_arboles.bib, ../../references.bib]
jupyter: python3
---
{{< include ../preprocesamiento/_labkit.qmd >}}
Un **árbol de decisión** clasifica haciendo preguntas, una tras otra: «¿cómo está el cielo?», «si está soleado, ¿la humedad es alta?». Cada respuesta lleva a otra pregunta o a una conclusión. Es la forma en que un médico sigue un protocolo de diagnóstico o un analista de crédito revisa una solicitud, y por eso los árboles son el clasificador más fácil de explicar a quien no es especialista.
La pregunta técnica es **qué preguntar y en qué orden**. Este capítulo la responde con la idea de **impureza** de la teoría de la información [@shannon1948mathematical] y con los algoritmos clásicos que la usan: la estrategia recursiva de @hunt1966experiments, ID3 [@quinlan1986induction] y su sucesor C4.5 [@quinlan1993c45]. El capítulo siguiente estudia CART [@breiman1984], la variante binaria que implementa `scikit-learn`.
## Intuición: ¿se juega el partido?
Durante quince días se registró el estado del tiempo y si se jugó un partido de béisbol.
| Día | Pronóstico | Temperatura | Humedad | Viento | ¿Juega? |
|---|---|---|---|---|---|
| D1 | Soleado | Caluroso | Alta | Débil | No |
| D2 | Soleado | Caluroso | Alta | Fuerte | No |
| D3 | Nublado | Caluroso | Alta | Débil | Sí |
| D4 | Lluvia | Templado | Alta | Débil | Sí |
| D5 | Lluvia | Fresco | Normal | Débil | Sí |
| D6 | Lluvia | Fresco | Normal | Fuerte | No |
| D7 | Nublado | Fresco | Normal | Fuerte | Sí |
| D8 | Soleado | Templado | Alta | Débil | No |
| D9 | Soleado | Fresco | Normal | Débil | Sí |
| D10 | Lluvia | Templado | Normal | Débil | Sí |
| D11 | Soleado | Templado | Normal | Débil | Sí |
| D12 | Nublado | Templado | Alta | Fuerte | Sí |
| D13 | Nublado | Caluroso | Normal | Débil | Sí |
| D14 | Lluvia | Templado | Alta | Fuerte | No |
| D15 | Soleado | Fresco | Alta | Débil | No |
: Quince días, 9 con partido y 6 sin partido. {#tbl-beisbol}
Si solo pudiéramos hacer **una** pregunta, ¿cuál haríamos? Preguntar por el pronóstico tiene una ventaja visible: los cuatro días nublados se jugó, así que esa respuesta resuelve el caso de inmediato. Preguntar por la temperatura, en cambio, deja grupos tan mezclados como al principio. Una buena pregunta es la que deja grupos **puros**, con una sola clase. Necesitamos una medida de qué tan mezclado está un grupo.
## Construcción paso a paso
### Paso 1. Medir la mezcla: la entropía
La **entropía** de un conjunto $S$ con proporciones de clase $p_1, \ldots, p_K$ es
$$
H(S) = -\sum_{k=1}^{K} p_k \log_2 p_k,
$$ {#eq-entropia}
con la convención $0 \log_2 0 = 0$. Vale 0 si el grupo es puro y es máxima cuando las clases están igualmente repartidas (1 bit en el caso binario)[^bit]. Para los quince días, con 9 «Sí» y 6 «No»:
$$
H(S) = -\tfrac{9}{15}\log_2\tfrac{9}{15} - \tfrac{6}{15}\log_2\tfrac{6}{15} = 0.6 \cdot 0.737 + 0.4 \cdot 1.322 \approx 0.971.
$$
### Paso 2. La ganancia de cada pregunta
Preguntar por el pronóstico divide los días en tres grupos:
| Pronóstico | Días | Sí | No | Entropía del grupo |
|---|---:|---:|---:|---:|
| Soleado | 6 | 2 | 4 | $-\frac{2}{6}\log_2\frac{2}{6} - \frac{4}{6}\log_2\frac{4}{6} = 0.918$ |
| Nublado | 4 | 4 | 0 | 0 |
| Lluvia | 5 | 3 | 2 | 0.971 |
: Partición por pronóstico. {#tbl-particion-pronostico}
La entropía **después** de preguntar es el promedio de las entropías de los grupos, ponderado por su tamaño:
$$
\tfrac{6}{15}(0.918) + \tfrac{4}{15}(0) + \tfrac{5}{15}(0.971) = 0.367 + 0 + 0.324 = 0.691.
$$
La **ganancia de información** es cuánto bajó la entropía: $0.971 - 0.691 = 0.280$ bits. Repitiendo el cálculo para los cuatro atributos:
| Atributo | Entropía después | Ganancia |
|---|---:|---:|
| **Pronóstico** | 0.691 | **0.280** |
| Humedad | 0.785 | 0.186 |
| Viento | 0.911 | 0.060 |
| Temperatura | 0.958 | 0.013 |
: Ganancia de información de cada atributo en la raíz. {#tbl-ganancias-raiz}
El pronóstico es la mejor primera pregunta, como sugería la intuición; la temperatura casi no informa.
### Paso 3. Repetir en cada rama
La rama *Nublado* es pura: se convierte en una **hoja** «Sí». Las otras dos siguen mezcladas y repetimos el procedimiento **solo con sus días**, sin volver a usar el pronóstico:
| Rama | $H$ de la rama | Ganancia Humedad | Ganancia Viento | Ganancia Temperatura |
|---|---:|---:|---:|---:|
| Soleado (6 días: 2 Sí, 4 No) | 0.918 | **0.918** | 0.109 | 0.252 |
| Lluvia (5 días: 3 Sí, 2 No) | 0.971 | 0.020 | **0.971** | 0.020 |
: Ganancias dentro de cada rama impura. {#tbl-ganancias-ramas}
En la rama *Soleado*, la humedad separa perfectamente: con humedad alta los cuatro días fueron «No» y con humedad normal los dos fueron «Sí». En la rama *Lluvia*, el viento separa perfectamente: con viento débil, tres «Sí»; con viento fuerte, dos «No». Cuando la ganancia es igual a la entropía de la rama, los hijos son puros.
### Paso 4. El árbol y sus reglas
```{mermaid}
%%| label: fig-arbol-id3
%%| fig-cap: "Árbol construido por ID3 con los quince días. Entre paréntesis, días Sí/No que llegan a cada hoja."
%%| echo: false
flowchart TD
    A[Pronóstico] -->|Nublado| B["Sí (4/0)"]
    A -->|Soleado| C[Humedad]
    A -->|Lluvia| D[Viento]
    C -->|Alta| E["No (0/4)"]
    C -->|Normal| F["Sí (2/0)"]
    D -->|Débil| G["Sí (3/0)"]
    D -->|Fuerte| H["No (0/2)"]
```
Cada camino de la raíz a una hoja es una **regla**:
1. SI Pronóstico = Nublado ENTONCES Juega = Sí.
2. SI Pronóstico = Soleado Y Humedad = Alta ENTONCES Juega = No.
3. SI Pronóstico = Soleado Y Humedad = Normal ENTONCES Juega = Sí.
4. SI Pronóstico = Lluvia Y Viento = Débil ENTONCES Juega = Sí.
5. SI Pronóstico = Lluvia Y Viento = Fuerte ENTONCES Juega = No.
El árbol usa tres de los cuatro atributos (la temperatura nunca fue útil) y clasifica bien los quince días. Son, casi literalmente, las reglas que encontró el clasificador CBA del capítulo de clasificación asociativa sobre datos parecidos: dos caminos distintos hacia las mismas regularidades.
## Formalización
### El algoritmo de Hunt
Sea $D_t$ el conjunto de ejemplos que llegan al nodo $t$ y $A$ el conjunto de atributos disponibles. El esquema recursivo de @hunt1966experiments, del que ID3, C4.5 y CART son casos particulares, es:
1. Si todos los ejemplos de $D_t$ tienen la misma clase $c$, $t$ es una hoja con clase $c$.
2. Si $A$ está vacío o se cumple un **criterio de parada**, $t$ es una hoja con la clase mayoritaria de $D_t$.
3. Si no, se elige la **prueba** que mejor separa las clases, se divide $D_t$ según su resultado y se aplica el procedimiento a cada hijo.
Si un hijo queda vacío (o, al predecir, aparece un valor no visto en el entrenamiento), se usa la clase mayoritaria del padre. Es una estrategia **voraz** (*greedy*): elige la mejor pregunta *local* sin volver atrás, lo que la hace rápida pero no garantiza el árbol óptimo global, cuyo cálculo es NP-difícil.
### Ganancia de información (ID3)
Para un atributo $A$ con valores $v \in \operatorname{Valores}(A)$ y $S_v = \{x \in S : A(x) = v\}$,
$$
\operatorname{Gan}(S, A) = H(S) - \sum_{v \in \operatorname{Valores}(A)} \frac{|S_v|}{|S|} H(S_v).
$$ {#eq-ganancia}
El segundo término es la **entropía condicional** $H(Y \mid A)$, la incertidumbre que queda sobre la clase cuando se conoce $A$; la ganancia es la **información mutua** entre $A$ y la clase[^info-mutua]. ID3 elige en cada nodo $\arg\max_A \operatorname{Gan}(S, A)$ y crea una rama por cada valor del atributo (partición **multivía**).
### Otras medidas de impureza
La entropía no es la única medida razonable. Para una proporción $p$ de la clase positiva en un problema binario:
| Medida | Fórmula | Máximo ($p = 0.5$) |
|---|---|---:|
| Entropía | $-p\log_2 p - (1-p)\log_2(1-p)$ | 1 |
| Índice de Gini | $1 - p^2 - (1-p)^2 = 2p(1-p)$ | 0.5 |
| Error de clasificación | $1 - \max(p, 1-p)$ | 0.5 |
: Medidas de impureza para dos clases. {#tbl-impurezas}
Las tres valen 0 en nodos puros y son máximas con clases balanceadas. La entropía y Gini son **estrictamente cóncavas**, lo que hace que cualquier división que separe las proporciones produzca una ganancia positiva; el error de clasificación no lo es, y por eso puede no ver mejoras reales[^concavidad]. Gini es el criterio de CART y se estudia en el capítulo siguiente; en la práctica, entropía y Gini producen árboles muy parecidos.
## El sesgo hacia atributos con muchos valores: C4.5
Agreguemos a la @tbl-beisbol la columna **Día** (D1, …, D15) como si fuera un atributo más. Al dividir por Día, cada grupo tiene un solo ejemplo, es puro, y la entropía después de dividir es 0. Su ganancia es la máxima posible, $0.971$, muy por encima del pronóstico. ID3 elegiría como raíz un identificador que no sirve para predecir nada: un día nuevo tendrá un valor de Día nunca visto.
El problema es general: un atributo con muchos valores parte los datos en grupos pequeños que, por azar, tienden a ser puros. C4.5 corrige la ganancia dividiéndola entre la **información de la partición**, la entropía de los propios tamaños de los grupos:
$$
\operatorname{SplitInfo}(S, A) = -\sum_{v} \frac{|S_v|}{|S|}\log_2\frac{|S_v|}{|S|}, \qquad
\operatorname{RazónGan}(S, A) = \frac{\operatorname{Gan}(S, A)}{\operatorname{SplitInfo}(S, A)}.
$$ {#eq-razon-ganancia}
Un atributo que parte en muchos grupos pequeños tiene un $\operatorname{SplitInfo}$ grande y queda penalizado. Para el pronóstico (grupos de 6, 4 y 5 días), $\operatorname{SplitInfo} = 1.566$; para Día (15 grupos de 1), $\log_2 15 = 3.907$:
| Atributo | Ganancia | SplitInfo | Razón de ganancia |
|---|---:|---:|---:|
| Día | 0.971 | 3.907 | **0.249** |
| Humedad | 0.186 | 0.997 | 0.186 |
| Pronóstico | 0.280 | 1.566 | 0.179 |
| Viento | 0.060 | 0.918 | 0.065 |
| Temperatura | 0.013 | 1.566 | 0.008 |
: Ganancia y razón de ganancia en la raíz, con el atributo Día incluido. {#tbl-razon-ganancia}
Dos lecciones honestas salen de esta tabla:
1. **La razón de ganancia atenúa el sesgo, pero no lo elimina.** Con 15 ejemplos la penalización $\log_2 15$ no alcanza y Día sigue ganando. Los identificadores, códigos postales finos o claves de producto deben **excluirse** antes de entrenar; ningún criterio de impureza los detecta por sí solo.
2. **Criterios distintos eligen raíces distintas.** Sin Día, la razón de ganancia prefiere la humedad (0.186) al pronóstico (0.179), porque la humedad parte en dos grupos y no en tres.
¿Cuál árbol es mejor? Lo decide la validación, no el criterio. Con validación cruzada dejando uno fuera sobre los quince días (calculada en la sección de Python), el árbol de ganancia de información acierta 14 de 15, el de razón de ganancia 12 y el de Gini 13; con Día incluido, cualquiera de ellos acierta solo 9, exactamente lo mismo que responder siempre la clase mayoritaria.
### Atributos continuos
ID3 solo maneja atributos categóricos; C4.5 trata los numéricos con preguntas binarias «$A \le t$». Supongamos que la humedad se midió en porcentaje. Se ordenan los valores y se evalúan cortes en los puntos medios entre valores consecutivos:
| Humedad (%) | 65 | 70 | 70 | 70 | 75 | 80 | 80 | **85** | 86 | 88 | 90 | 90 | 91 | 95 | 96 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Juega | Sí | No | Sí | Sí | Sí | Sí | Sí | **No** | Sí | No | No | Sí | No | No | Sí |
: Humedad numérica ordenada. {#tbl-humedad-numerica}
| Corte $t$ | $\le t$ (Sí/No) | $> t$ (Sí/No) | Ganancia |
|---:|---|---|---:|
| 77.5 | 4 / 1 | 5 / 5 | 0.064 |
| **82.5** | **6 / 1** | **3 / 5** | **0.186** |
| 85.5 | 6 / 2 | 3 / 4 | 0.078 |
| 87.0 | 7 / 2 | 2 / 4 | 0.145 |
: Ganancia de algunos cortes candidatos. {#tbl-cortes-humedad}
El mejor corte es 82.5 %. Con $m$ valores distintos hay $m - 1$ cortes posibles, pero @fayyad1992handling demostraron que el óptimo de la entropía siempre está en un **punto frontera**, entre dos valores consecutivos de clases distintas, así que basta evaluar esos. Tras ordenar una vez ($O(n \log n)$), todas las ganancias se calculan en una pasada actualizando conteos. A diferencia de un atributo categórico, un atributo numérico puede volver a usarse más abajo con otro corte.
### Valores faltantes
C4.5 no descarta los ejemplos con un valor faltante en el atributo evaluado. Calcula la ganancia con los ejemplos que sí lo tienen y la multiplica por la fracción de ejemplos conocidos; al dividir, envía cada ejemplo con valor faltante a **todas** las ramas con un peso proporcional al tamaño de cada rama. Al predecir hace lo mismo y combina las distribuciones de las hojas alcanzadas. CART usa en cambio **divisiones sustitutas** (*surrogate splits*), y `scikit-learn` (desde la versión 1.3) aprende en cada corte hacia qué hijo enviar los faltantes.
### Criterios de parada y poda
Un árbol que crece hasta que todas sus hojas son puras **memoriza**: con datos ruidosos termina creando una hoja para cada excepción, como el 1-NN del capítulo introductorio. Hay dos formas de controlarlo:
- **Pre-poda**: detener el crecimiento antes, con una profundidad máxima, un mínimo de ejemplos por hoja o por nodo a dividir, o una ganancia mínima. Es barata, pero miope: una división poco útil puede habilitar otra muy útil debajo (el caso del XOR).
- **Post-poda**: hacer crecer el árbol completo y después **reemplazar subárboles por hojas** cuando eso no empeora el error. La *poda por error reducido* lo decide con un conjunto de validación [@quinlan1987simplifying]; C4.5 usa una **estimación pesimista** del error de cada hoja (el extremo superior de un intervalo de confianza) para podar sin datos adicionales; CART usa la **poda de costo-complejidad**, que se desarrolla en el capítulo siguiente.
## Laboratorio: construye el árbol
El laboratorio construye el árbol con los quince días de la @tbl-beisbol y el criterio elegido. Haz clic en cualquier nodo para ver los puntajes de cada atributo en ese nodo; la profundidad máxima permite recorrer la construcción nivel por nivel. El estado inicial reproduce la @tbl-ganancias-raiz y el árbol de la @fig-arbol-id3.
::: {.content-visible when-format="html"}
```{=html}
<div class="plab" id="id3-lab">
<p class="plab-eyebrow">Laboratorio · Árboles de decisión</p>
<h3 class="plab-title">¿Qué pregunta hacer primero?</h3>
<p class="plab-sub">Cambia el criterio, incluye el atributo Día y limita la profundidad. Haz clic en un nodo para inspeccionar sus puntajes.</p>
<div class="plab-controls">
<div class="plab-field">Criterio
<div class="plab-seg" id="id3-crit">
<button data-value="gain" aria-pressed="true">Ganancia (ID3)</button>
<button data-value="ratio">Razón de ganancia (C4.5)</button>
<button data-value="gini">Gini</button>
</div>
</div>
<div class="plab-field">Atributo Día
<div class="plab-seg" id="id3-dia">
<button data-value="no" aria-pressed="true">Excluido</button>
<button data-value="si">Incluido</button>
</div>
</div>
<label>Profundidad máxima: <b id="id3-d-v"></b><input type="range" id="id3-d" min="0" max="4" step="1" value="4"></label>
</div>
<div class="plab-stats">
<div class="plab-stat"><span>Hojas</span><strong id="id3-leaves"></strong></div>
<div class="plab-stat"><span>Exactitud en entrenamiento</span><strong id="id3-train"></strong></div>
<div class="plab-stat"><span>Exactitud LOOCV</span><strong id="id3-loo"></strong></div>
<div class="plab-stat"><span>Referencia (siempre «Sí»)</span><strong>9/15</strong></div>
</div>
<div class="plab-panel">
<h4>Árbol (Sí/No en cada nodo)</h4>
<svg id="id3-svg" class="wide" role="img" aria-label="Árbol de decisión construido con el criterio elegido; los nodos se pueden seleccionar"></svg>
<div class="plab-legend"><span><i style="background:var(--lab-s3)"></i>hoja «Sí»</span><span><i style="background:var(--lab-s5)"></i>hoja «No»</span><span><i style="background:var(--lab-s1)"></i>nodo de decisión</span><span><i style="background:var(--lab-s2)"></i>nodo seleccionado</span></div>
</div>
<div class="plab-grid" style="margin-top:1rem">
<div class="plab-panel"><h4 id="id3-node-t">Puntajes en el nodo</h4><div id="id3-node" class="plab-scroll"></div></div>
<div class="plab-panel"><h4>Reglas</h4><div id="id3-rules" class="plab-scroll"></div></div>
</div>
<p class="plab-note" id="id3-note" aria-live="polite"></p>
</div>
<script>
(() => {
const K = window.LabKit, root = document.getElementById('id3-lab');
const $ = s => root.querySelector(s);
const ATTRS = ['Día', 'Pronóstico', 'Temperatura', 'Humedad', 'Viento'];
const VALS = { 'Día': Array.from({ length: 15 }, (_, i) => 'D' + (i + 1)), 'Pronóstico': ['Soleado', 'Nublado', 'Lluvia'],
'Temperatura': ['Caluroso', 'Templado', 'Fresco'], 'Humedad': ['Alta', 'Normal'], 'Viento': ['Débil', 'Fuerte'] };
const RAW = [['Soleado','Caluroso','Alta','Débil','No'],['Soleado','Caluroso','Alta','Fuerte','No'],['Nublado','Caluroso','Alta','Débil','Sí'],
['Lluvia','Templado','Alta','Débil','Sí'],['Lluvia','Fresco','Normal','Débil','Sí'],['Lluvia','Fresco','Normal','Fuerte','No'],
['Nublado','Fresco','Normal','Fuerte','Sí'],['Soleado','Templado','Alta','Débil','No'],['Soleado','Fresco','Normal','Débil','Sí'],
['Lluvia','Templado','Normal','Débil','Sí'],['Soleado','Templado','Normal','Débil','Sí'],['Nublado','Templado','Alta','Fuerte','Sí'],
['Nublado','Caluroso','Normal','Débil','Sí'],['Lluvia','Templado','Alta','Fuerte','No'],['Soleado','Fresco','Alta','Débil','No']];
const ROWS = RAW.map((r, i) => ({ 'Día': 'D' + (i + 1), 'Pronóstico': r[0], 'Temperatura': r[1], 'Humedad': r[2], 'Viento': r[3], y: r[4] }));
const counts = rows => { const s = rows.filter(r => r.y === 'Sí').length; return [s, rows.length - s]; };
const ent = rows => { const n = rows.length; if (!n) return 0; return counts(rows).reduce((h, c) => c ? h - c / n * Math.log2(c / n) : h, 0); };
const gin = rows => { const n = rows.length; if (!n) return 0; return 1 - counts(rows).reduce((s, c) => s + (c / n) ** 2, 0); };
const maj = rows => { const [s, no] = counts(rows); return s > no ? 'Sí' : 'No'; };
function scores(rows, a) {
const n = rows.length, groups = VALS[a].map(v => rows.filter(r => r[a] === v)).filter(g => g.length);
const after = K.sum(groups.map(g => g.length / n * ent(g))), gain = ent(rows) - after;
const si = -K.sum(groups.map(g => g.length / n * Math.log2(g.length / n)));
const gdec = gin(rows) - K.sum(groups.map(g => g.length / n * gin(g)));
return { gain, si, ratio: si > 0 ? gain / si : 0, gini: gdec };
}
function build(rows, attrs, crit, depth, maxd, key) {
const node = { key, rows, depth, maj: maj(rows), attrs };
const [s, no] = counts(rows);
if (!s || !no || !attrs.length || depth >= maxd) { node.leaf = true; return node; }
let best = null, bv = -Infinity;
attrs.forEach(a => { const v = scores(rows, a)[crit]; if (v > bv + 1e-12) { bv = v; best = a; } });
node.attr = best;
node.ch = VALS[best].map(v => ({ v, rows: rows.filter(r => r[best] === v) })).filter(c => c.rows.length)
.map(c => ({ v: c.v, node: build(c.rows, attrs.filter(a => a !== best), crit, depth + 1, maxd, key + '|' + best + '=' + c.v) }));
return node;
}
function predict(node, r) {
while (!node.leaf) { const c = node.ch.find(c => c.v === r[node.attr]); if (!c) return node.maj; node = c.node; }
return node.maj;
}
const critSeg = K.segmented($('#id3-crit'), render), diaSeg = K.segmented($('#id3-dia'), render);
let selected = '';
const NAMES = { gain: 'ganancia', ratio: 'razón de ganancia', gini: 'reducción de Gini' };
function render() {
const crit = critSeg.get(), maxd = +$('#id3-d').value, attrs = ATTRS.filter(a => a !== 'Día' || diaSeg.get() === 'si');
$('#id3-d-v').textContent = maxd;
const tree = build(ROWS, attrs, crit, 0, maxd, '');
// Recorre el árbol: hojas, nodos y posiciones (x por orden de hojas, y por profundidad).
const nodes = [], leaves = []; let depthMax = 0;
(function walk(n) { nodes.push(n); depthMax = Math.max(depthMax, n.depth); if (n.leaf) { n.x = leaves.length; leaves.push(n); } else { n.ch.forEach(c => walk(c.node)); n.x = K.mean(n.ch.map(c => c.node.x)); } })(tree);
if (!nodes.some(n => n.key === selected)) selected = '';
const W = 640, H = 70 + 92 * Math.max(1, depthMax), L = leaves.length;
const c = K.chart($('#id3-svg'), { width: W, height: H, x: [-0.5, Math.max(L, 1) - 0.5], y: [depthMax + 0.35, -0.35], margin: { left: 8, right: 8, top: 8, bottom: 8 } });
const bw = Math.min(96, (W - 20) / Math.max(L, 1) - 4), bh = 34;
nodes.forEach(n => { if (!n.leaf) n.ch.forEach(ch => {
c.line(n.x, n.depth, ch.node.x, ch.node.depth, 'muted line thin');
const mx = (n.x + ch.node.x) / 2, my = (n.depth + ch.node.depth) / 2;
c.text(mx, my, ch.v, { 'text-anchor': 'middle', dy: 4, class: 'strong', style: 'font-size:10px;paint-order:stroke;stroke:var(--lab-bg);stroke-width:3px' });
}); });
nodes.forEach(n => {
const X = c.X(n.x), Y = c.Y(n.depth), cls = n.leaf ? (n.maj === 'Sí' ? 's3' : 's5') : 's1';
const g = K.el('g', { 'data-key': n.key, style: 'cursor:pointer' }, c.g);
K.el('rect', { x: X - bw / 2, y: Y - bh / 2, width: bw, height: bh, rx: 6, style: 'fill:var(--lab-bg);stroke:none' }, g);
const rct = K.el('rect', { x: X - bw / 2, y: Y - bh / 2, width: bw, height: bh, rx: 6, class: cls }, g);
rct.style.fillOpacity = n.leaf ? 0.22 : 0.16; rct.style.strokeWidth = n.key === selected ? 3 : 1.2;
if (n.key === selected) rct.style.stroke = 'var(--lab-s2)';
const [s, no] = counts(n.rows);
const t1 = K.el('text', { x: X, y: Y - 2, 'text-anchor': 'middle', class: 'strong', style: 'font-size:' + (bw < 60 ? 9 : 11) + 'px' }, g);
t1.textContent = n.leaf ? n.maj : n.attr;
const t2 = K.el('text', { x: X, y: Y + 11, 'text-anchor': 'middle', style: 'font-size:9.5px' }, g);
t2.textContent = `${s}/${no}`;
});
// Métricas: entrenamiento y LOOCV.
const train = ROWS.filter(r => predict(tree, r) === r.y).length;
const loo = ROWS.filter((r, i) => predict(build(ROWS.filter((_, j) => j !== i), attrs, crit, 0, maxd, ''), r) === r.y).length;
$('#id3-leaves').textContent = leaves.length;
$('#id3-train').textContent = `${train}/15`;
$('#id3-loo').textContent = `${loo}/15`;
// Tabla del nodo seleccionado.
const sel = nodes.find(n => n.key === selected) || tree;
const path = sel.key ? sel.key.slice(1).split('|').join(' ∧ ') : 'raíz (todos los días)';
const [ss, sn] = counts(sel.rows);
$('#id3-node-t').textContent = `Nodo: ${path}`;
const avail = attrs.filter(a => !sel.key.includes('|' + a + '='));
const rowsT = avail.map(a => ({ a, ...scores(sel.rows, a) }));
const chosen = sel.leaf ? null : sel.attr;
$('#id3-node').innerHTML = `<p class="plab-sub" style="margin:0 0 .4rem">${sel.rows.length} días (${ss} Sí, ${sn} No) · H = ${K.fmt(ent(sel.rows), 3)} · Gini = ${K.fmt(gin(sel.rows), 3)}${sel.leaf ? ' · hoja «' + sel.maj + '»' : ''}</p>` +
(rowsT.length && (ss && sn) ? '<table class="plab-table"><thead><tr><th>Atributo</th><th>Ganancia</th><th>SplitInfo</th><th>Razón</th><th>Δ Gini</th></tr></thead><tbody>' +
rowsT.map(r => `<tr${r.a === chosen ? ' class="hl"' : ''}><td>${r.a}</td><td>${K.fmt(r.gain, 3)}</td><td>${K.fmt(r.si, 3)}</td><td>${K.fmt(r.ratio, 3)}</td><td>${K.fmt(r.gini, 3)}</td></tr>`).join('') +
`</tbody></table><p class="plab-sub" style="margin:.4rem 0 0">${chosen ? 'Resaltado: el atributo elegido con ' + NAMES[crit] + '.' : 'El nodo es hoja por la profundidad máxima.'}</p>` : '<p class="plab-sub">Nodo puro o sin atributos: no hay nada que dividir.</p>');
// Reglas.
$('#id3-rules').innerHTML = '<ol class="plab-task" style="margin:0">' + leaves.map(l => {
const [s, no] = counts(l.rows);
return `<li>SI ${l.key ? l.key.slice(1).split('|').join(' ∧ ') : '(siempre)'} ⇒ <b>${l.maj}</b> <span style="color:var(--lab-muted)">(${s}/${no})</span></li>`;
}).join('') + '</ol>';
const note = $('#id3-note');
if (attrs.includes('Día') && tree.attr === 'Día') {
note.className = 'plab-note bad';
note.textContent = `La raíz es Día: cada grupo tiene un solo día y es puro, así que el árbol acierta ${train}/15 en entrenamiento, pero en LOOCV cada día dejado fuera tiene un valor nunca visto y se predice la clase mayoritaria: ${loo}/15, igual que la referencia.`;
} else if (maxd === 0) {
note.className = 'plab-note warn';
note.textContent = 'Con profundidad 0 el árbol es una sola hoja: responde siempre la clase mayoritaria («Sí», 9/15).';
} else {
note.className = 'plab-note good';
note.textContent = `Raíz: ${tree.attr} (${NAMES[crit]} = ${K.fmt(scores(ROWS, tree.attr)[crit], 3)}). ${leaves.length} hojas; entrenamiento ${train}/15 y validación dejando uno fuera ${loo}/15. La diferencia es el optimismo de evaluar con los datos con que se construyó el árbol.`;
}
}
$('#id3-svg').addEventListener('click', e => { const g = e.target.closest('[data-key]'); if (g) { selected = g.dataset.key; render(); } });
$('#id3-d').addEventListener('input', render);
render();
})();
</script>
```
:::
::: {.content-visible when-format="pdf"}
En la versión web, este laboratorio construye el árbol con el criterio elegido y permite inspeccionar cada nodo. Valores de referencia: con ganancia de información y sin el atributo Día, la raíz es Pronóstico (0.280), el árbol tiene 5 hojas, acierta 15/15 en entrenamiento y 14/15 en validación dejando uno fuera. Con razón de ganancia la raíz es Humedad (0.186) y la LOOCV es 12/15; con Gini, la raíz es Pronóstico y la LOOCV es 13/15. Con Día incluido, cualquier criterio lo elige como raíz y la LOOCV cae a 9/15.
:::
**Guía del laboratorio.**
1. Con profundidad 1, comprueba la @tbl-ganancias-raiz en la tabla del nodo raíz. Después sube a 2 y haz clic en el nodo *Humedad* de la rama *Soleado*: ¿coinciden los puntajes con la @tbl-ganancias-ramas?
2. Predice antes de mover: si cambias a *Razón de ganancia*, ¿qué atributo quedará en la raíz? Compruébalo y explica el papel de SplitInfo.
3. Incluye el atributo *Día* con cada uno de los tres criterios. ¿Alguno lo evita? ¿Qué le pasa a la exactitud de entrenamiento y a la de LOOCV?
4. Con *Gini* y sin Día, compara el árbol con el de ganancia de información. ¿Son iguales? ¿Por qué la LOOCV no es la misma si el árbol completo es igual?
5. Explica con la profundidad máxima qué es la pre-poda y qué se pierde con profundidad 1.
## Implementación en Python
### Entropía, ganancia y razón de ganancia
Las funciones siguientes reproducen las tablas de la sección anterior.
```{python}
#| label: id3-datos
import numpy as np
import pandas as pd

dias = pd.DataFrame({
    "Pronóstico": ["Soleado", "Soleado", "Nublado", "Lluvia", "Lluvia", "Lluvia", "Nublado", "Soleado",
                   "Soleado", "Lluvia", "Soleado", "Nublado", "Nublado", "Lluvia", "Soleado"],
    "Temperatura": ["Caluroso", "Caluroso", "Caluroso", "Templado", "Fresco", "Fresco", "Fresco", "Templado",
                    "Fresco", "Templado", "Templado", "Templado", "Caluroso", "Templado", "Fresco"],
    "Humedad": ["Alta", "Alta", "Alta", "Alta", "Normal", "Normal", "Normal", "Alta",
                "Normal", "Normal", "Normal", "Alta", "Normal", "Alta", "Alta"],
    "Viento": ["Débil", "Fuerte", "Débil", "Débil", "Débil", "Fuerte", "Fuerte", "Débil",
               "Débil", "Débil", "Débil", "Fuerte", "Débil", "Fuerte", "Débil"],
    "Juega": ["No", "No", "Sí", "Sí", "Sí", "No", "Sí", "No", "Sí", "Sí", "Sí", "Sí", "Sí", "No", "No"],
}, index=[f"D{i}" for i in range(1, 16)])

def entropia(etiquetas):
    p = pd.Series(etiquetas).value_counts(normalize=True)
    return float(-(p * np.log2(p)).sum())

def gini(etiquetas):
    p = pd.Series(etiquetas).value_counts(normalize=True)
    return float(1 - (p ** 2).sum())

def puntajes(datos, atributo, objetivo="Juega"):
    n = len(datos)
    grupos = [g[objetivo] for _, g in datos.groupby(atributo)]
    ganancia = entropia(datos[objetivo]) - sum(len(g) / n * entropia(g) for g in grupos)
    split_info = entropia(datos[atributo])
    return {"ganancia": ganancia, "split_info": split_info,
            "razón": ganancia / split_info if split_info > 0 else 0.0,
            "Δ gini": gini(datos[objetivo]) - sum(len(g) / n * gini(g) for g in grupos)}

print(f"H(S) = {entropia(dias['Juega']):.3f}")
con_dia = dias.assign(Día=dias.index)
pd.DataFrame({a: puntajes(con_dia, a) for a in ["Día", "Pronóstico", "Temperatura", "Humedad", "Viento"]}).T.round(3)
```
Las ganancias dentro de las ramas *Soleado* y *Lluvia* (@tbl-ganancias-ramas):
```{python}
#| label: id3-ramas
pd.DataFrame({rama: {a: puntajes(dias[dias["Pronóstico"] == rama], a)["ganancia"]
                     for a in ["Humedad", "Viento", "Temperatura"]}
              for rama in ["Soleado", "Lluvia"]}).T.round(3)
```
### ID3 desde cero
La implementación recursiva sigue el algoritmo de Hunt. El árbol se representa con diccionarios; cada nodo interno guarda su clase mayoritaria para responder ante valores no vistos.
```{python}
#| label: id3-desde-cero
from collections import Counter

def mayoritaria(etiquetas):
    conteo = Counter(etiquetas)
    maximo = max(conteo.values())
    return sorted(c for c, v in conteo.items() if v == maximo)[0]

def id3(datos, atributos, criterio="ganancia", objetivo="Juega", prof=0, prof_max=10):
    y = list(datos[objetivo])
    if len(set(y)) == 1 or not atributos or prof == prof_max:
        return mayoritaria(y)                                         # hoja
    mejor = max(atributos, key=lambda a: (round(puntajes(datos, a, objetivo)[criterio], 12), -atributos.index(a)))
    resto = [a for a in atributos if a != mejor]
    return {"atributo": mejor, "mayoritaria": mayoritaria(y),
            "hijos": {v: id3(g, resto, criterio, objetivo, prof + 1, prof_max) for v, g in datos.groupby(mejor)}}

def predecir(arbol, fila):
    while isinstance(arbol, dict):
        arbol = arbol["hijos"].get(fila[arbol["atributo"]], arbol["mayoritaria"])
    return arbol

def reglas(arbol, condiciones=()):
    if not isinstance(arbol, dict):
        yield " ∧ ".join(condiciones) or "(siempre)", arbol
        return
    for valor, hijo in arbol["hijos"].items():
        yield from reglas(hijo, condiciones + (f"{arbol['atributo']} = {valor}",))

base = ["Pronóstico", "Temperatura", "Humedad", "Viento"]
arbol = id3(dias, base)
for condicion, clase in reglas(arbol):
    print(f"SI {condicion}  ⇒  {clase}")
```
La validación dejando uno fuera compara criterios y muestra el efecto del atributo Día:
```{python}
#| label: id3-loocv
def loocv(datos, atributos, criterio):
    return sum(predecir(id3(datos.drop(i), atributos, criterio), datos.loc[i]) == datos.loc[i, "Juega"]
               for i in datos.index)

filas = []
for criterio in ["ganancia", "razón", "Δ gini"]:
    for nombre, attrs, d in [("sin Día", base, dias), ("con Día", ["Día"] + base, con_dia)]:
        a = id3(d, attrs, criterio)
        filas.append({"criterio": criterio, "atributos": nombre, "raíz": a["atributo"],
                      "entrenamiento": sum(predecir(a, f) == f["Juega"] for _, f in d.iterrows()),
                      "LOOCV": loocv(d, attrs, criterio)})
pd.DataFrame(filas)
```
### Atributos continuos
```{python}
#| label: id3-continuo
humedad_pct = pd.Series([85, 90, 86, 96, 80, 70, 65, 95, 70, 80, 70, 90, 75, 91, 88], index=dias.index)

def mejor_corte(x, y):
    orden = np.argsort(x.values, kind="stable")
    xs, ys = x.values[orden], y.values[orden]
    candidatos = []
    for i in range(len(xs) - 1):
        if xs[i] != xs[i + 1]:
            t = (xs[i] + xs[i + 1]) / 2
            izq, der = ys[xs <= t], ys[xs > t]
            g = entropia(ys) - len(izq) / len(ys) * entropia(izq) - len(der) / len(ys) * entropia(der)
            candidatos.append({"corte": t, "ganancia": round(g, 3), "frontera": ys[i] != ys[i + 1]})
    return pd.DataFrame(candidatos)

cortes = mejor_corte(humedad_pct, dias["Juega"])
print(cortes.loc[cortes["ganancia"].idxmax()].to_dict())
cortes.sort_values("ganancia", ascending=False).head(5)
```
### Árboles con `scikit-learn`
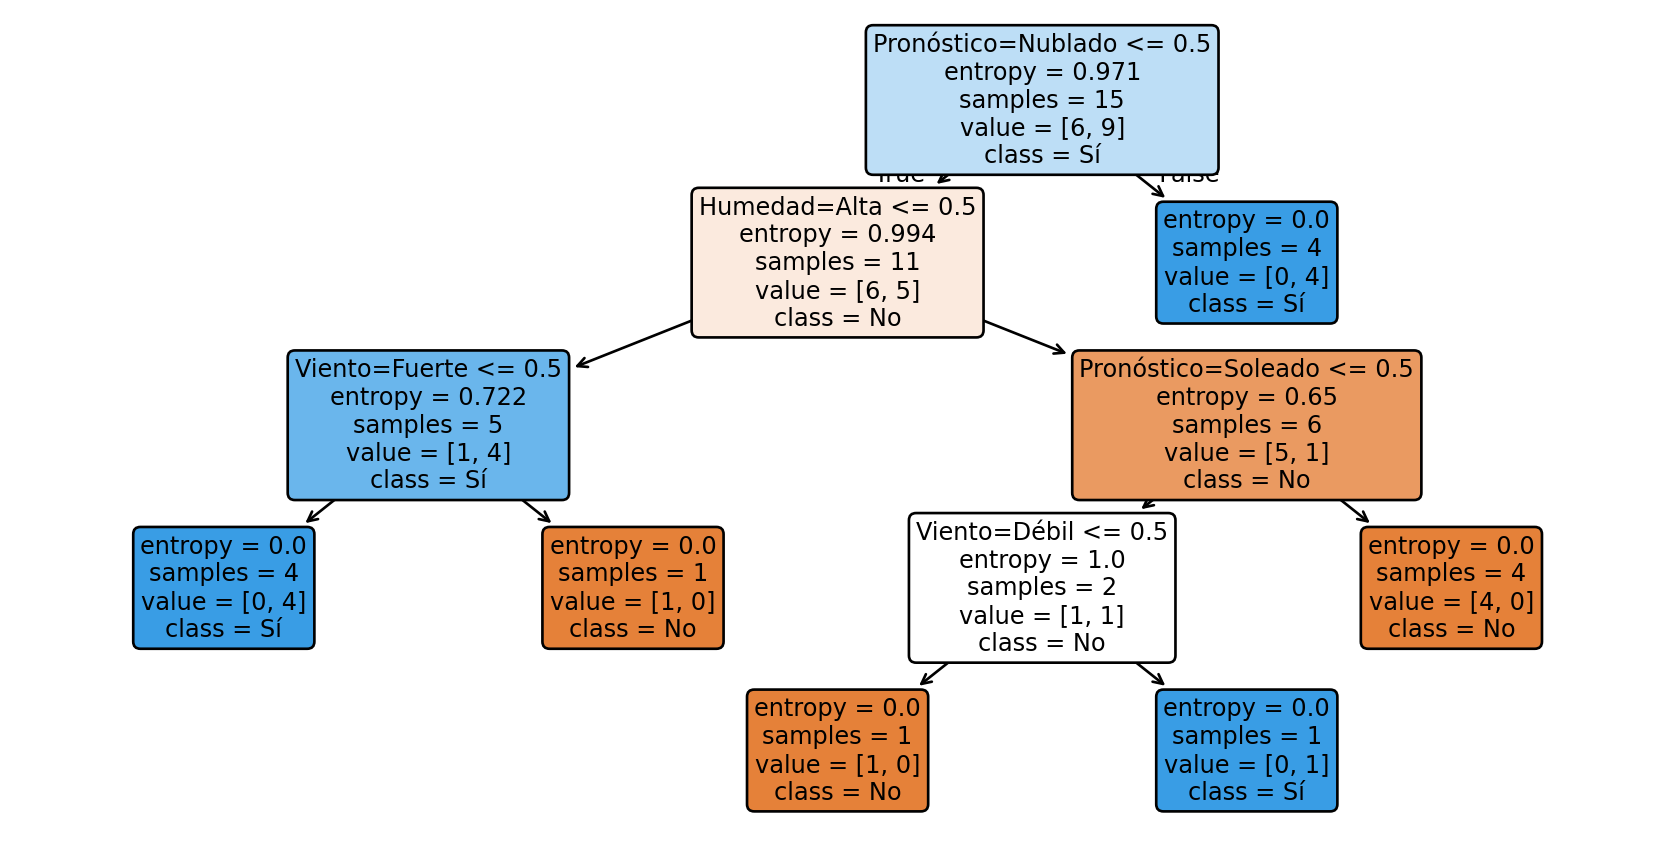
`DecisionTreeClassifier` implementa CART: con `criterion="entropy"` usa la entropía, pero siempre hace **divisiones binarias**. Con variables categóricas codificadas *one-hot*, cada pregunta es del tipo «¿Pronóstico = Nublado?», de modo que el árbol puede tener una forma distinta aunque represente reglas equivalentes.
```{python}
#| label: fig-id3-sklearn
#| fig-cap: "Árbol de scikit-learn con criterio de entropía sobre las variables codificadas one-hot. Las divisiones son binarias y el árbol tiene otra forma que el de ID3, aunque también clasifica bien los quince días."
import matplotlib.pyplot as plt
from sklearn.tree import DecisionTreeClassifier, plot_tree, export_text

X_oh = pd.get_dummies(dias.drop(columns="Juega"), prefix_sep="=").astype(int)
clf = DecisionTreeClassifier(criterion="entropy", random_state=0).fit(X_oh, dias["Juega"])
print(export_text(clf, feature_names=list(X_oh.columns)))

fig, ax = plt.subplots(figsize=(11, 5.5))
plot_tree(clf, feature_names=list(X_oh.columns), class_names=list(clf.classes_), filled=True, rounded=True,
          impurity=True, ax=ax, fontsize=9)
plt.show()
```
## Complejidad, ventajas y limitaciones
En cada nodo, evaluar un atributo categórico cuesta $O(n_t)$ con $n_t$ ejemplos en el nodo; un atributo numérico, $O(n_t \log n_t)$ por el ordenamiento (o $O(n_t)$ si se ordena una sola vez al inicio). Como cada nivel del árbol reparte los $n$ ejemplos entre sus nodos, construir un árbol de profundidad $d$ con $p$ atributos cuesta del orden de $O(p\, n\, d)$, y predecir cuesta $O(d)$: recorrer un camino.
**Ventajas.**
- Se leen como reglas y se explican sin matemáticas.
- Aceptan variables categóricas y numéricas, no necesitan escalamiento y son invariantes ante transformaciones monótonas de las variables.
- Seleccionan variables automáticamente y capturan interacciones (la humedad importa solo si está soleado).
- Predicen muy rápido.
**Limitaciones.**
- **Inestabilidad**: un cambio pequeño en los datos puede cambiar la raíz y, con ella, todo el árbol. Es alta varianza, la misma que los métodos de ensamble aprovecharán para promediar.
- Sin poda, sobreajustan.
- Las fronteras son escalones paralelos a los ejes: una frontera diagonal requiere muchos escalones.
- La búsqueda voraz no ve interacciones que no se anuncian con una ganancia individual (el XOR).
- El sesgo hacia atributos con muchos valores obliga a revisar las variables de entrada.
## Resumen
- Un árbol de decisión parte los datos con preguntas sucesivas hasta llegar a grupos casi puros; se construye de forma voraz y recursiva (algoritmo de Hunt).
- ID3 mide la mezcla con la **entropía** y elige la pregunta de mayor **ganancia de información**, la información mutua entre el atributo y la clase.
- La ganancia favorece atributos con muchos valores; C4.5 la divide entre la información de la partición (**razón de ganancia**), lo que atenúa pero no elimina el problema. Los identificadores deben excluirse.
- C4.5 maneja atributos continuos con cortes binarios (basta evaluar los puntos frontera), valores faltantes con pesos fraccionarios y poda pesimista.
- Un árbol completo memoriza; la pre-poda y la post-poda controlan su complejidad, y la validación decide entre criterios y tamaños.
[^bit]: Un **bit** es la información necesaria para resolver una pregunta de sí o no con dos respuestas igualmente probables. Si el grupo tiene 50 % de cada clase, adivinar la clase de un ejemplo requiere un bit completo; si es puro, no requiere ninguno.
[^info-mutua]: La **información mutua** $I(A; Y) = H(Y) - H(Y \mid A)$ mide cuánto se reduce la incertidumbre sobre $Y$ al conocer $A$. Es simétrica y vale 0 solo si $A$ y $Y$ son independientes, la misma idea que mide la prueba $\chi^2$ del capítulo de selección de variables.
[^concavidad]: Si un nodo con 40 % de positivos se divide en un hijo pequeño con 10 % de positivos (la séptima parte de los ejemplos) y otro con 45 %, ambos hijos siguen teniendo mayoría negativa y el error de clasificación sigue siendo 0.40, aunque el primer hijo es mucho más puro. La entropía y Gini, por ser estrictamente cóncavas, sí registran esa mejora.
## Referencias {.unnumbered}
::: {#refs}
:::