---
title: "DBSCAN y HDBSCAN"
description: "Explica el clustering basado en densidad DBSCAN y HDBSCAN, con los conceptos de puntos núcleo, borde y ruido, y la alcanzabilidad por densidad."
pagetitle: "DBSCAN y HDBSCAN"
open-graph:
description: "Explica el clustering basado en densidad DBSCAN y HDBSCAN, con los conceptos de puntos núcleo, borde y ruido, y la alcanzabilidad por densidad."
twitter-card:
description: "Explica el clustering basado en densidad DBSCAN y HDBSCAN, con los conceptos de puntos núcleo, borde y ruido, y la alcanzabilidad por densidad."
author: "Diego Villalba"
date: today
lang: es
format:
html:
toc: true
toc-depth: 3
toc-title: "Contenido"
number-sections: true
code-fold: true
code-tools: true
code-summary: "Mostrar código"
fig-align: center
theme: cosmo
highlight-style: github
smooth-scroll: true
pdf:
toc: true
toc-depth: 3
number-sections: true
documentclass: scrbook
papersize: letter
fontsize: 11pt
geometry: margin=2.5cm
keep-tex: false
execute:
echo: true
warning: false
message: false
cache: false
bibliography: [referencias_clustering.bib, ../../references.bib]
crossref:
fig-title: "Figura"
tbl-title: "Tabla"
eq-prefix: "Ec."
jupyter: python3
---
K-Means y el clustering jerárquico asumen implícitamente que los grupos son convexos o al menos compactos en torno a un centroide o medoide. En muchos problemas reales, los grupos tienen formas arbitrarias: anillos concéntricos, espirales, formas irregulares determinadas por procesos físicos o geográficos. Para estos casos, los métodos basados en densidad son más adecuados.
DBSCAN (Density-Based Spatial Clustering of Applications with Noise) fue propuesto por Ester et al. en 1996 [@ester1996] y se convirtió en uno de los algoritmos de clustering más influyentes, ganando el premio Test of Time en la conferencia KDD 2014. Su idea central es simple: un grupo es una región de alta densidad de puntos, separada de otras regiones de alta densidad por regiones de baja densidad. Los puntos en zonas de baja densidad se clasifican como ruido.
## Conceptos fundamentales
DBSCAN opera sobre dos parámetros: el radio de vecindad $\varepsilon$ y el número mínimo de puntos $\text{minPts}$.
::: {.callout-note appearance="minimal"}
Definición. La **$\varepsilon$-vecindad** de un punto $\mathbf{x}$ es el conjunto de puntos a distancia menor o igual que $\varepsilon$:
$$
N_\varepsilon(\mathbf{x}) = \{\mathbf{y}\in\mathcal{D} \mid d(\mathbf{x},\mathbf{y})\leq\varepsilon\}.
$$ {#eq-eps-neighborhood}
:::
Con estos dos parámetros se clasifican los puntos en tres categorías.
::: {.callout-note appearance="minimal"}
Definición. Un punto $\mathbf{x}$ es:
- **Punto núcleo (core point):** si $|N_\varepsilon(\mathbf{x})|\geq\text{minPts}$.
- **Punto borde (border point):** si no es punto núcleo pero está en la $\varepsilon$-vecindad de algún punto núcleo.
- **Punto de ruido (noise point):** si no es punto núcleo ni punto borde.
:::
Los puntos núcleo tienen suficientes vecinos cercanos como para considerarse parte del interior de un grupo. Los puntos borde están cerca de un grupo pero no tienen suficientes vecinos propios. Los puntos de ruido son aislados y no pertenecen a ningún grupo.
## Alcanzabilidad y conectividad por densidad
La noción de grupo en DBSCAN se define mediante la alcanzabilidad por densidad entre puntos.
::: {.callout-note appearance="minimal"}
Definición. Un punto $\mathbf{y}$ es **directamente alcanzable por densidad** desde $\mathbf{x}$ (con parámetros $\varepsilon$ y $\text{minPts}$) si:
1. $\mathbf{y}\in N_\varepsilon(\mathbf{x})$, y
2. $|N_\varepsilon(\mathbf{x})|\geq\text{minPts}$ (es decir, $\mathbf{x}$ es punto núcleo).
:::
::: {.callout-note appearance="minimal"}
Definición. Un punto $\mathbf{y}$ es **alcanzable por densidad** desde $\mathbf{x}$ si existe una cadena $\mathbf{x}=\mathbf{p}_1,\mathbf{p}_2,\dots,\mathbf{p}_k=\mathbf{y}$ tal que $\mathbf{p}_{i+1}$ es directamente alcanzable desde $\mathbf{p}_i$.
:::
::: {.callout-note appearance="minimal"}
Definición. Dos puntos $\mathbf{x}$ e $\mathbf{y}$ están **conectados por densidad** si existe un punto $\mathbf{z}$ tal que ambos son alcanzables por densidad desde $\mathbf{z}$.
Un **grupo DBSCAN** es un conjunto maximal de puntos mutuamente conectados por densidad.
:::
## Algoritmo DBSCAN
::: {.callout-note appearance="minimal"}
**Algoritmo DBSCAN.**
**Entrada:** $\mathcal{D}=\{\mathbf{x}_1,\dots,\mathbf{x}_n\}$, parámetros $\varepsilon$ y $\text{minPts}$.
1. Etiquetar todos los puntos como no visitados.
2. Para cada punto no visitado $\mathbf{x}$:
a. Marcar $\mathbf{x}$ como visitado.
b. Calcular $N_\varepsilon(\mathbf{x})$.
c. Si $|N_\varepsilon(\mathbf{x})|<\text{minPts}$: etiquetar $\mathbf{x}$ como ruido (provisionalmente).
d. Si $|N_\varepsilon(\mathbf{x})|\geq\text{minPts}$: crear nuevo grupo $C$ y expandir:
- Agregar $\mathbf{x}$ a $C$.
- Para cada $\mathbf{y}\in N_\varepsilon(\mathbf{x})$ no visitado: visitar $\mathbf{y}$ y, si es punto núcleo, agregar $N_\varepsilon(\mathbf{y})$ a la cola de expansión.
- Agregar todos los alcanzables al grupo $C$.
**Salida:** etiquetas de grupo para cada punto (o ruido).
:::
La complejidad de DBSCAN es $O(n^2)$ con búsqueda lineal de vecinos. Con un índice espacial como k-d tree o R-tree, se reduce a $O(n\log n)$ en promedio para datos de baja dimensión. En alta dimensión, la maldición de la dimensionalidad hace que los índices espaciales pierdan eficiencia.
```{=html}
<div id="dbscan-wrap" style="font-family:Georgia,serif;max-width:700px;margin:2em auto;background:#f9fafc;border:1px solid #d0d7e3;border-radius:10px;padding:20px 24px;box-shadow:0 2px 12px rgba(30,60,120,.07);">
<div style="text-align:center;margin-bottom:12px;">
<span style="font-size:1.05em;font-weight:bold;color:#1a2e45;">DBSCAN — explorador de ε-vecindad</span><br>
<span style="font-size:0.81em;color:#666;">Ajusta ε y minPts para ver cómo cambian los puntos núcleo, borde y ruido</span>
</div>
<div style="display:grid;grid-template-columns:1fr 1fr;gap:10px;margin-bottom:10px;">
<div><label style="font-size:0.83em;color:#444;">ε = <strong id="db-ev">0.9</strong></label><br>
<input id="db-esl" type="range" min="0.2" max="2.5" step="0.05" value="0.9" style="width:100%;accent-color:#1a3a5c;"></div>
<div><label style="font-size:0.83em;color:#444;">minPts = <strong id="db-mv">3</strong></label><br>
<input id="db-msl" type="range" min="1" max="8" step="1" value="3" style="width:100%;accent-color:#7c3aed;"></div>
</div>
<div id="dbscan-info" style="text-align:center;font-size:0.82em;padding:5px 10px;background:#fff;border:1px solid #e0e5ed;border-radius:5px;margin-bottom:10px;min-height:22px;"></div>
<canvas id="dbscan-cv" style="display:block;width:100%;border-radius:6px;border:1px solid #e0e5ed;background:#fff;"></canvas>
</div>
<script>
(function(){
// Two crescent shapes + noise
function makeData(){
const pts=[];
for(let i=0;i<24;i++){const a=Math.PI*i/23;pts.push([2+1.8*Math.cos(a)+0.12*(Math.random()-0.5),1+1.2*Math.sin(a)+0.12*(Math.random()-0.5)]);}
for(let i=0;i<20;i++){const a=Math.PI+Math.PI*i/19;pts.push([2.5+1.8*Math.cos(a)+0.12*(Math.random()-0.5),2.2+1.2*Math.sin(a)+0.12*(Math.random()-0.5)]);}
pts.push([0.5,0.3],[5.0,3.8],[0.2,3.5],[5.5,0.5],[2.8,4.5]);
return pts;
}
const PTS=makeData();
const N=PTS.length;
const cv=document.getElementById('dbscan-cv');
const W=680,H=360,DPR=window.devicePixelRatio||1;
cv.width=W*DPR;cv.height=H*DPR;cv.style.width=W+'px';cv.style.height=H+'px';
const ctx=cv.getContext('2d');ctx.scale(DPR,DPR);
const PAD={l:40,r:16,t:20,b:30};
const CW=W-PAD.l-PAD.r,CH=H-PAD.t-PAD.b;
const xMn=-0.5,xMx=6.5,yMn=-0.5,yMx=5.0;
const sx=x=>PAD.l+(x-xMn)/(xMx-xMn)*CW;
const sy=y=>PAD.t+CH-(y-yMn)/(yMx-yMn)*CH;
const GCOLS=['#2563eb','#dc2626','#16a34a','#f59e0b','#7c3aed','#0891b2'];
function dist(a,b){return Math.sqrt((a[0]-b[0])**2+(a[1]-b[1])**2);}
function runDBSCAN(eps,minPts){
const nbrs=PTS.map(p=>PTS.map((q,j)=>({j,d:dist(p,q)})).filter(x=>x.d<=eps).map(x=>x.j));
const isCore=nbrs.map(nb=>nb.length>=minPts);
const labels=new Array(N).fill(-1);
let cid=0;
for(let i=0;i<N;i++){
if(labels[i]!==-1||!isCore[i])continue;
const queue=[i];labels[i]=cid;
while(queue.length){
const cur=queue.shift();
nbrs[cur].forEach(j=>{
if(labels[j]===-1){labels[j]=cid;if(isCore[j])queue.push(j);}
});
}
cid++;
}
const type=PTS.map((_,i)=>isCore[i]?'core':labels[i]===-1?'noise':'border');
return{labels,type,nClusters:cid};
}
function draw(eps,minPts){
const{labels,type,nClusters}=runDBSCAN(eps,minPts);
ctx.clearRect(0,0,W,H);
ctx.fillStyle='#f8f9fb';ctx.fillRect(PAD.l,PAD.t,CW,CH);
ctx.strokeStyle='#e8ecf3';ctx.lineWidth=0.8;
[0,1,2,3,4,5,6].forEach(v=>{ctx.beginPath();ctx.moveTo(sx(v),PAD.t);ctx.lineTo(sx(v),PAD.t+CH);ctx.stroke();});
[0,1,2,3,4].forEach(v=>{ctx.beginPath();ctx.moveTo(PAD.l,sy(v));ctx.lineTo(PAD.l+CW,sy(v));ctx.stroke();});
ctx.strokeStyle='#9aa3b5';ctx.lineWidth=1.2;
ctx.beginPath();ctx.moveTo(PAD.l,PAD.t);ctx.lineTo(PAD.l,PAD.t+CH);ctx.lineTo(PAD.l+CW,PAD.t+CH);ctx.stroke();
// Draw epsilon circles for core points
PTS.forEach((p,i)=>{
if(type[i]==='core'){
ctx.beginPath();ctx.arc(sx(p[0]),sy(p[1]),eps/(xMx-xMn)*CW,0,2*Math.PI);
ctx.strokeStyle=GCOLS[labels[i]%GCOLS.length]+'33';ctx.lineWidth=1;ctx.stroke();
ctx.fillStyle=GCOLS[labels[i]%GCOLS.length]+'10';ctx.fill();
}
});
PTS.forEach((p,i)=>{
const col=type[i]==='noise'?'#94a3b8':GCOLS[labels[i]%GCOLS.length];
const r=type[i]==='core'?7:type[i]==='border'?5:4;
ctx.beginPath();ctx.arc(sx(p[0]),sy(p[1]),r,0,2*Math.PI);
ctx.fillStyle=col+'cc';ctx.fill();
ctx.strokeStyle=type[i]==='core'?'#fff':'#fff';
ctx.lineWidth=type[i]==='core'?2:1.5;ctx.stroke();
if(type[i]==='noise'){
ctx.strokeStyle='#94a3b8';ctx.lineWidth=1.5;
const s=4;
ctx.beginPath();ctx.moveTo(sx(p[0])-s,sy(p[1])-s);ctx.lineTo(sx(p[0])+s,sy(p[1])+s);ctx.stroke();
ctx.beginPath();ctx.moveTo(sx(p[0])+s,sy(p[1])-s);ctx.lineTo(sx(p[0])-s,sy(p[1])+s);ctx.stroke();
}
});
// Legend
const lx=PAD.l+8,ly=PAD.t+10;
[[GCOLS[0],'Núcleo (●)',7],[GCOLS[0]+'88','Borde (●)',5],['#94a3b8','Ruido (×)',4]].forEach(([col,lbl,r],i)=>{
ctx.beginPath();ctx.arc(lx+r,ly+i*18+r,r,0,2*Math.PI);
ctx.fillStyle=col;ctx.fill();ctx.strokeStyle='#fff';ctx.lineWidth=1.5;ctx.stroke();
ctx.fillStyle='#1a2e45';ctx.font='10px Georgia,serif';ctx.textAlign='left';
ctx.fillText(lbl,lx+r*2+6,ly+i*18+r+4);
});
ctx.fillStyle='#1a2e45';ctx.font='bold 11px Georgia,serif';ctx.textAlign='center';
ctx.fillText('DBSCAN (ε='+eps.toFixed(2)+', minPts='+minPts+')',PAD.l+CW/2,PAD.t-6);
const nCore=type.filter(t=>t==='core').length;
const nBorder=type.filter(t=>t==='border').length;
const nNoise=type.filter(t=>t==='noise').length;
document.getElementById('dbscan-info').innerHTML=
`Grupos = <strong>${nClusters}</strong> · `+
`Núcleo = <strong style="color:#2563eb">${nCore}</strong> · `+
`Borde = <strong style="color:#16a34a">${nBorder}</strong> · `+
`Ruido = <strong style="color:#94a3b8">${nNoise}</strong>`;
}
['db-esl','db-msl'].forEach(id=>{
document.getElementById(id).addEventListener('input',function(){
const eps=parseFloat(document.getElementById('db-esl').value);
const minPts=parseInt(document.getElementById('db-msl').value);
document.getElementById('db-ev').textContent=eps.toFixed(2);
document.getElementById('db-mv').textContent=minPts;
draw(eps,minPts);
});
});
draw(0.9,3);
})();
</script>
```
## Selección de parámetros
La elección de $\varepsilon$ y $\text{minPts}$ es el principal desafío de DBSCAN. Los valores inadecuados pueden producir un único grupo masivo (ε grande), muchos puntos de ruido (ε pequeño), o fragmentación de grupos naturales.
### Heurística del gráfico k-distancia
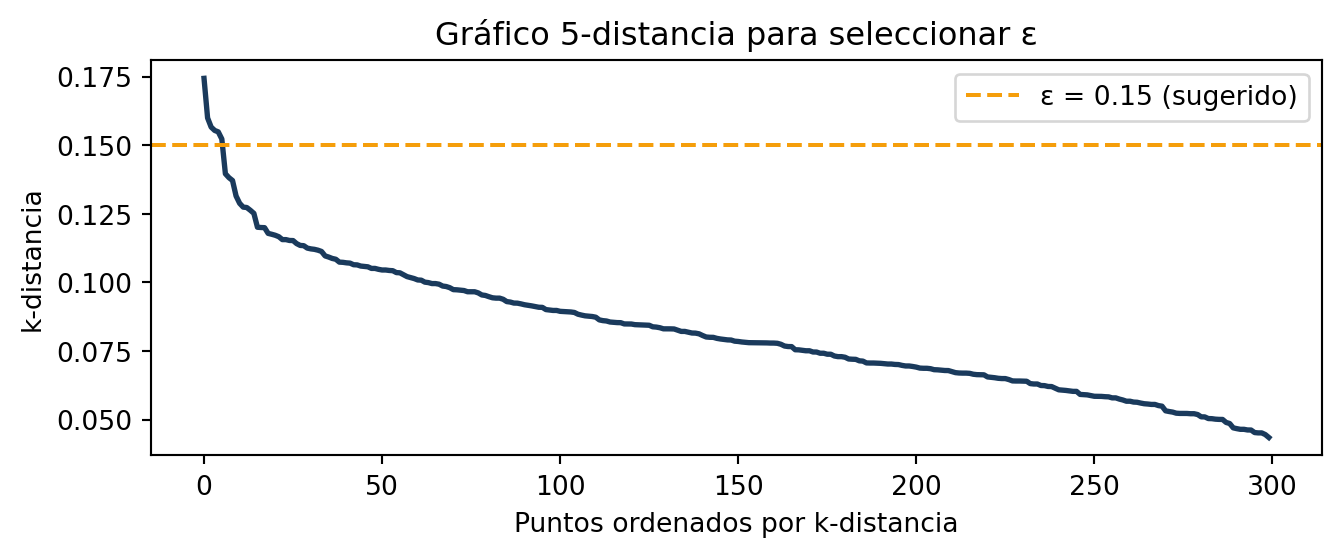
Una heurística clásica para elegir $\varepsilon$ es el gráfico de k-distancia. Para cada punto, se calcula la distancia al k-ésimo vecino más cercano. Estos valores se ordenan de mayor a menor y se grafican. El codo de la curva sugiere un buen valor de $\varepsilon$.
```{python}
import numpy as np
from sklearn.neighbors import NearestNeighbors
from sklearn.datasets import make_moons
import matplotlib.pyplot as plt

X, _ = make_moons(n_samples=300, noise=0.05, random_state=42)

k = 5
nbrs = NearestNeighbors(n_neighbors=k).fit(X)
distances, _ = nbrs.kneighbors(X)
k_dist = np.sort(distances[:, -1])[::-1]

plt.figure(figsize=(7, 3))
plt.plot(k_dist, color="#1a3a5c", linewidth=2)
plt.axhline(0.15, color="#f59e0b", linestyle="--", label="ε = 0.15 (sugerido)")
plt.xlabel("Puntos ordenados por k-distancia")
plt.ylabel("k-distancia")
plt.title(f"Gráfico {k}-distancia para seleccionar ε")
plt.legend()
plt.tight_layout()
plt.show()
```
### Regla general para minPts
Como guía práctica, se recomienda $\text{minPts}\geq d+1$ donde $d$ es la dimensión de los datos [@ester1996]. Para datos ruidosos, valores mayores son más robustos. En la práctica se usan frecuentemente $\text{minPts}\in\{3,4,5,10\}$ y se ajusta $\varepsilon$ con la heurística k-distancia.
```{python}
from sklearn.datasets import make_moons
from sklearn.cluster import DBSCAN
from sklearn.metrics import silhouette_score
import numpy as np

X, y_true = make_moons(n_samples=300, noise=0.05, random_state=42)

db = DBSCAN(eps=0.15, min_samples=5)
labels = db.fit_predict(X)

n_clusters = len(set(labels)) - (1 if -1 in labels else 0)
n_noise = np.sum(labels == -1)

print(f"Grupos encontrados: {n_clusters}")
print(f"Puntos de ruido: {n_noise} ({100*n_noise/len(X):.1f}%)")

mask = labels != -1
if mask.sum() > 1 and len(set(labels[mask])) > 1:
    print(f"Silueta (sin ruido): {silhouette_score(X[mask], labels[mask]):.4f}")
```
## Ventajas y limitaciones
**Ventajas de DBSCAN:**
- Detecta grupos de forma arbitraria, no solo convexos.
- Identifica automáticamente puntos de ruido sin necesidad de asignarlos a ningún grupo.
- No requiere especificar el número de grupos de antemano.
- Es relativamente robusto a outliers.
**Limitaciones:**
- No funciona bien cuando los grupos tienen densidades muy distintas: un $\varepsilon$ que conecta grupos de baja densidad puede fusionar grupos de alta densidad.
- La selección de $\varepsilon$ y $\text{minPts}$ puede ser difícil en datos de alta dimensión donde las distancias colapsan.
- Computacionalmente ineficiente para conjuntos de datos muy grandes sin indexación espacial.
## HDBSCAN
HDBSCAN (Hierarchical DBSCAN) extiende DBSCAN construyendo una jerarquía de grupos basada en densidad que es más robusta ante variaciones de densidad [@campello2013]. La idea central es transformar las distancias originales en distancias de alcanzabilidad mutua, construir un árbol de expansión mínimo sobre estas distancias, convertirlo en una jerarquía de grupos y extraer los grupos más persistentes.
::: {.callout-note appearance="minimal"}
Definición. La **distancia de alcanzabilidad mutua** entre dos puntos $\mathbf{x}$ y $\mathbf{y}$ es:
$$
d_{\text{mreach},k}(\mathbf{x},\mathbf{y}) = \max\{d_k(\mathbf{x}),\; d_k(\mathbf{y}),\; d(\mathbf{x},\mathbf{y})\},
$$ {#eq-mutual-reachability}
donde $d_k(\mathbf{x})$ es la distancia al k-ésimo vecino más cercano de $\mathbf{x}$.
:::
Esta transformación suaviza la estructura de densidad y hace que los grupos emerjan de forma más estable. HDBSCAN no requiere especificar $\varepsilon$ directamente, solo $\text{minPts}$, y produce grupos de densidad variable.
```{python}
try:
    import hdbscan
    from sklearn.datasets import make_moons

    X, _ = make_moons(n_samples=300, noise=0.05, random_state=42)

    hdb = hdbscan.HDBSCAN(min_cluster_size=15, min_samples=5)
    labels = hdb.fit_predict(X)

    n_clusters = len(set(labels)) - (1 if -1 in labels else 0)
    n_noise = (labels == -1).sum()
    print(f"HDBSCAN — Grupos: {n_clusters}, Ruido: {n_noise}")
except ImportError:
    print("Instalar hdbscan: pip install hdbscan")
    from sklearn.cluster import HDBSCAN
    from sklearn.datasets import make_moons

    X, _ = make_moons(n_samples=300, noise=0.05, random_state=42)
    hdb = HDBSCAN(min_cluster_size=15, min_samples=5)
    labels = hdb.fit_predict(X)
    n_clusters = len(set(labels)) - (1 if -1 in labels else 0)
    n_noise = (labels == -1).sum()
    print(f"HDBSCAN (sklearn) — Grupos: {n_clusters}, Ruido: {n_noise}")
```
## Aplicaciones
DBSCAN y HDBSCAN son especialmente útiles en:
- **Datos geoespaciales:** identificar zonas de alta concentración de eventos (crímenes, ventas, accidentes) sin asumir formas de grupos predeterminadas.
- **Detección de anomalías:** los puntos clasificados como ruido son candidatos naturales a anomalías.
- **Análisis de imágenes:** segmentar regiones de una imagen con criterios de similitud local.
- **Bioinformática:** identificar grupos de células con comportamiento similar en datos de citometría de flujo o RNA-seq.
- **Redes sociales:** detectar comunidades en grafos convertidos en vectores de características.