---
title: "Medidas de variabilidad"
pagetitle: "Medidas de variabilidad"
open-graph:
description: "Explica rango, varianza, desviación estándar y rango intercuartílico como medidas de variabilidad, con un ejemplo de dos equipos de reparto."
twitter-card:
description: "Explica rango, varianza, desviación estándar y rango intercuartílico como medidas de variabilidad, con un ejemplo de dos equipos de reparto."
description: "Explica rango, varianza, desviación estándar y rango intercuartílico como medidas de variabilidad, con un ejemplo de dos equipos de reparto."
author: "Diego Villalba"
date: today
lang: es
format:
html:
toc: true
toc-depth: 3
number-sections: true
code-fold: true
code-tools: true
code-summary: "Mostrar código"
fig-align: center
theme: cosmo
pdf:
toc: true
toc-depth: 3
number-sections: true
execute:
echo: true
warning: false
message: false
cache: false
jupyter: python3
bibliography: [referencias_eda.bib, ../../references.bib]
crossref:
fig-title: "Figura"
tbl-title: "Tabla"
eq-prefix: "Ec."
---
## El problema: cumplir el promedio no basta
Dos equipos entregan ocho pedidos cada uno. En ambos casos, el tiempo medio es
de 15.5 minutos:
| Pedido ordenado | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | Media |
|:---|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| Equipo Regular | 12 | 14 | 15 | 15 | 16 | 16 | 17 | 19 | 15.5 |
| Equipo Irregular | 5 | 8 | 12 | 15 | 16 | 19 | 23 | 26 | 15.5 |
Si solo se reporta el promedio, los equipos parecen equivalentes. Sin embargo,
para quien espera su pedido no lo son: con el primer equipo casi todos los
tiempos están cerca de 15.5; con el segundo pueden ser muy cortos o muy largos.
La **variabilidad** describe cuánto difieren los valores entre sí o respecto de
un centro. Es una propiedad de una variable cuantitativa:[^cuantitativa] no
basta saber dónde está el centro de la distribución, también importa cuánto se
extiende alrededor de él [@tukey1977eda; @nist2012handbook].
::: {.callout-note appearance="minimal"}
### Dos casos que servirán como brújula
- Si los ocho pedidos tardaran exactamente 15.5 minutos, la variabilidad
debería ser **cero**.
- Si unos tiempos se alejan del centro mientras otros se acercan de manera que
la media no cambia, la variabilidad debería **aumentar**.
Una buena medida de dispersión debe distinguir estos casos, pero no todas
responden igual ante valores extremos ni se expresan en las mismas unidades.
:::
## Primera mirada: la amplitud total
El **rango** resta el mínimo al máximo. Si
$x_{(1)}\le\cdots\le x_{(n)}$ son los datos ordenados,[^estadistico-orden]
$$
R=x_{(n)}-x_{(1)}. \tag{1}
$$
Para el Equipo Regular,
$$
R_R=19-12=7\ \text{minutos};
$$
para el Equipo Irregular,
$$
R_I=26-5=21\ \text{minutos}.
$$
El segundo equipo cubre una amplitud tres veces mayor. La conclusión es útil,
pero se apoya únicamente en dos observaciones. Si el tiempo 19 del primer
equipo fuera un error de captura y en realidad fuera 49, su rango saltaría de
7 a 37 minutos aunque los otros siete tiempos permanecieran intactos.
::: {.callout-important appearance="minimal"}
El rango contesta “¿qué tan separados están los dos extremos?”. No contesta
“¿qué tan lejos del centro está un pedido típico?”. Para esa segunda pregunta
necesitamos usar todos los datos.
:::
## De las desviaciones a la varianza
### El obstáculo de los signos
Tomemos los tiempos del Equipo Regular:
$$
x=(12,14,15,15,16,16,17,19).
$$
Su suma es 124 y su media es
$$
\bar{x}=\frac{124}{8}=15.5.
$$
Una **desviación** es la distancia con signo $x_i-\bar{x}$ entre una
observación y la media:
| $x_i$ | 12 | 14 | 15 | 15 | 16 | 16 | 17 | 19 |
|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| $x_i-15.5$ | $-3.5$ | $-1.5$ | $-0.5$ | $-0.5$ | $0.5$ | $0.5$ | $1.5$ | $3.5$ |
Las desviaciones suman cero. Esto no demuestra ausencia de variabilidad: las
distancias a la izquierda y a la derecha de la media se cancelan. Elevarlas al
cuadrado evita la cancelación y da más peso a las desviaciones grandes:
| $x_i-15.5$ | $-3.5$ | $-1.5$ | $-0.5$ | $-0.5$ | $0.5$ | $0.5$ | $1.5$ | $3.5$ |
|---:|---:|---:|---:|---:|---:|---:|---:|---:|
| $(x_i-15.5)^2$ | 12.25 | 2.25 | 0.25 | 0.25 | 0.25 | 0.25 | 2.25 | 12.25 |
La **suma de cuadrados** es
$$
SS=\sum_{i=1}^{8}(x_i-15.5)^2=30\ \text{minutos}^2. \tag{2}
$$
La suma crece si hay más observaciones, aunque la dispersión no cambie. Por
eso se divide entre una cantidad relacionada con el número de datos. El
divisor correcto depende de qué representan esos ocho pedidos.
## ¿Población completa o muestra?
### Cuando los datos son todo lo que queremos describir
Si esos ocho pedidos son **todos** los pedidos del turno y la pregunta se
limita a describir ese turno, constituyen la población de interés.[^poblacion]
La varianza poblacional es
$$
\sigma^2=\frac{1}{N}\sum_{i=1}^{N}(x_i-\mu)^2. \tag{3}
$$
donde $N$ es el tamaño de la población y $\mu$ su media. Para el turno:
$$
\sigma^2=\frac{30}{8}=3.75\ \text{minutos}^2.
$$
La varianza queda en unidades **cuadradas** porque también lo están sus
sumandos. Para regresar a la escala de los datos se extrae la raíz cuadrada:
$$
\sigma=\sqrt{3.75}=1.9365\ \text{minutos}. \tag{4}
$$
La desviación estándar poblacional es, por tanto, de aproximadamente 1.94
minutos.
### Cuando los datos pretenden representar más casos
Si los ocho pedidos son una muestra aleatoria de todos los pedidos que el
equipo podría atender, $\bar{x}$ y $s^2$ son **estadísticos** usados para
estimar parámetros desconocidos de una población mayor.[^parametro]
La varianza muestral usual es
$$
s^2=\frac{1}{n-1}\sum_{i=1}^{n}(x_i-\bar{x})^2. \tag{5}
$$
En el ejemplo,
$$
s^2=\frac{30}{8-1}=4.2857\ \text{minutos}^2,
\qquad
s=\sqrt{4.2857}=2.0702\ \text{minutos}.
$$
No cambiaron los datos ni la suma de cuadrados: cambió la finalidad. Dividir
entre $n$ describe exactamente la colección observada; dividir entre $n-1$
produce, bajo muestreo independiente de una población con varianza finita, un
estimador insesgado de $\sigma^2$ [@freedman2007statistics].[^insesgado]
### ¿De dónde sale el grado de libertad perdido?
Una vez calculada $\bar{x}$, las desviaciones cumplen
$$
\sum_{i=1}^{n}(x_i-\bar{x})=0.
$$
Si conocemos $n-1$ desviaciones, la última ya no puede variar libremente: debe
ser el número que haga cero la suma. Quedan $n-1$ **grados de libertad**.[^gl]
La llamada corrección de Bessel compensa además que la media muestral fue
ajustada con los mismos datos y hace a $s^2$ insesgada. Esto no significa que
$s$ sea insesgada ni que siempre deba dividirse entre $n-1$.
::: {.callout-warning appearance="minimal"}
### Una convención no se elige por el tamaño del archivo
No use $n-1$ solo porque hay pocos datos ni $n$ solo porque hay muchos. Primero
defina el universo de la afirmación: “estos ocho pedidos” pide descripción
poblacional; “el desempeño futuro del equipo” plantea una inferencia desde una
muestra y requiere, además, justificar cómo se obtuvieron los pedidos.
:::
## Misma media, diferente variabilidad
Para el Equipo Irregular, la media también es 15.5, pero
$$
\begin{aligned}
SS_I
&=(-10.5)^2+(-7.5)^2+(-3.5)^2+(-0.5)^2\\
&\quad +(0.5)^2+(3.5)^2+(7.5)^2+(10.5)^2\\
&=358.
\end{aligned}
$$
Si los ocho pedidos son la población de cada turno,
$$
\sigma_I^2=\frac{358}{8}=44.75,
\qquad
\sigma_I=\sqrt{44.75}=6.6895\ \text{minutos}.
$$
La tabla reúne lo aprendido:
| Medida poblacional | Equipo Regular | Equipo Irregular |
|:---|---:|---:|
| Media | 15.5 min | 15.5 min |
| Rango | 7 min | 21 min |
| Varianza | 3.75 min$^2$ | 44.75 min$^2$ |
| Desviación estándar | 1.94 min | 6.69 min |
La media no distingue los equipos; las tres medidas de variabilidad sí. La
desviación estándar suele ser más fácil de comunicar que la varianza porque
está en minutos, pero la varianza es central en muchos algoritmos por sus
propiedades algebraicas.
::: {.callout-note appearance="minimal"}
### Cómo leer una desviación estándar
$\sigma=1.94$ minutos no significa que todos los pedidos estén a 1.94 minutos
de la media ni que sea la distancia absoluta promedio. Es la raíz del promedio
de distancias **cuadradas**. Si la distribución fuera aproximadamente normal,
alrededor del 68% de los valores caería entre $\mu-\sigma$ y $\mu+\sigma$; esa
regla no se traslada automáticamente a distribuciones sesgadas o multimodales.[^normal]
:::
## Laboratorio: mover los pedidos y observar las medidas
::: {.content-visible when-format="html"}
```{=html}
<style>
#variability-lab{--ink:#172033;--muted:#5b6474;--blue:#2563eb;--orange:#d97706;--green:#16835f;max-width:1040px;margin:1.4rem auto;font-family:system-ui,sans-serif;color:var(--ink)}
#variability-lab .lab-shell{border:1px solid #d7dde8;border-radius:18px;padding:1.15rem;background:linear-gradient(135deg,#f8fbff,#fffaf2);box-shadow:0 10px 28px rgba(23,32,51,.08)}
#variability-lab .lab-title{font-size:1.18rem;font-weight:750;margin:0 0 .25rem}
#variability-lab .lab-intro{color:var(--muted);margin:.2rem 0 1rem}
#variability-lab .lab-layout{display:grid;grid-template-columns:minmax(250px,.8fr) minmax(360px,1.4fr);gap:1rem;align-items:start}
#variability-lab .preset-row{display:flex;flex-wrap:wrap;gap:.45rem;margin-bottom:.8rem}
#variability-lab button{border:1px solid #aeb9cb;background:#fff;border-radius:999px;padding:.4rem .7rem;cursor:pointer;color:var(--ink)}
#variability-lab button:hover,#variability-lab button:focus{border-color:var(--blue);outline:2px solid #bfdbfe}
#variability-lab .control-row{display:grid;grid-template-columns:4.5rem 1fr 2.3rem;gap:.45rem;align-items:center;font-size:.82rem;margin:.3rem 0}
#variability-lab input{width:100%;accent-color:var(--blue)}
#variability-lab output{font-variant-numeric:tabular-nums;text-align:right;font-weight:700}
#variability-lab .metrics{display:grid;grid-template-columns:repeat(3,1fr);gap:.55rem;margin-top:.85rem}
#variability-lab .metric{background:#fff;border:1px solid #dce2eb;border-radius:10px;padding:.55rem;text-align:center}
#variability-lab .metric span{display:block;color:var(--muted);font-size:.74rem}
#variability-lab .metric strong{font-size:1.02rem;font-variant-numeric:tabular-nums}
#variability-lab svg{width:100%;height:auto;background:#fff;border:1px solid #dce2eb;border-radius:12px}
#variability-lab .lab-reading{margin:.7rem 0 0;color:var(--muted);font-size:.88rem}
@media(max-width:760px){#variability-lab .lab-layout{grid-template-columns:1fr}#variability-lab .metrics{grid-template-columns:repeat(2,1fr)}}
</style>
<div id="variability-lab" aria-labelledby="variability-lab-title">
<div class="lab-shell">
<p id="variability-lab-title" class="lab-title">Laboratorio de tiempos de entrega</p>
<p class="lab-intro">Mueva cualquier pedido o cargue un escenario. La línea azul marca la media y la naranja la mediana.</p>
<div class="preset-row">
<button type="button" data-preset="regular">Equipo Regular</button>
<button type="button" data-preset="irregular">Equipo Irregular</button>
<button type="button" data-preset="extreme">Un retraso extremo</button>
<button type="button" data-preset="equal">Todos iguales</button>
</div>
<div class="lab-layout">
<div data-controls></div>
<div>
<svg data-plot viewBox="0 0 680 300" role="img" aria-label="Recta numérica de tiempos de entrega con media y mediana"></svg>
<p class="lab-reading" data-reading aria-live="polite"></p>
</div>
</div>
<div class="metrics" aria-live="polite">
<div class="metric"><span>Media</span><strong data-metric="mean"></strong></div>
<div class="metric"><span>Rango</span><strong data-metric="range"></strong></div>
<div class="metric"><span>Varianza poblacional</span><strong data-metric="variance"></strong></div>
<div class="metric"><span>Desv. estándar poblacional</span><strong data-metric="sd"></strong></div>
<div class="metric"><span>IQR (mitades)</span><strong data-metric="iqr"></strong></div>
<div class="metric"><span>MAD</span><strong data-metric="mad"></strong></div>
</div>
</div>
</div>
<script>
(() => {
const root=document.getElementById('variability-lab'); if(!root)return;
const scenarios={regular:[12,14,15,15,16,16,17,19],irregular:[5,8,12,15,16,19,23,26],extreme:[12,14,15,15,16,16,17,45],equal:[16,16,16,16,16,16,16,16]};
const controls=root.querySelector('[data-controls]'),svg=root.querySelector('[data-plot]'),NS='http://www.w3.org/2000/svg';
const median=a=>{const b=[...a].sort((x,y)=>x-y),m=b.length>>1;return b.length%2?b[m]:(b[m-1]+b[m])/2};
const quartiles=a=>{const b=[...a].sort((x,y)=>x-y),m=b.length>>1;return b.length%2?[median(b.slice(0,m)),median(b.slice(m+1))]:[median(b.slice(0,m)),median(b.slice(m))]};
const add=(tag,attrs,text='')=>{const e=document.createElementNS(NS,tag);Object.entries(attrs).forEach(([k,v])=>e.setAttribute(k,v));e.textContent=text;svg.appendChild(e);return e};
scenarios.regular.forEach((v,i)=>{const label=document.createElement('label');label.className='control-row';label.innerHTML=`<span>Pedido ${i+1}</span><input type="range" min="0" max="50" step="1" value="${v}" data-value="${i}"><output>${v}</output>`;controls.appendChild(label)});
const inputs=[...root.querySelectorAll('[data-value]')];
function update(){
const x=inputs.map(el=>+el.value);inputs.forEach(el=>el.nextElementSibling.value=el.value);
const sorted=[...x].sort((a,b)=>a-b),mean=x.reduce((a,b)=>a+b,0)/x.length,med=median(x),[q1,q3]=quartiles(x),variance=x.reduce((s,v)=>s+(v-mean)**2,0)/x.length,sd=Math.sqrt(variance),mad=median(x.map(v=>Math.abs(v-med))),range=sorted.at(-1)-sorted[0];
const values={mean,range,variance,sd,iqr:q3-q1,mad};Object.entries(values).forEach(([k,v])=>root.querySelector(`[data-metric="${k}"]`).textContent=v.toFixed(2));
root.querySelector('[data-reading]').textContent=`El 50% central va de ${q1.toFixed(1)} a ${q3.toFixed(1)} min. Compare cuánto se mueve cada medida al cargar “Un retraso extremo”.`;
svg.replaceChildren();const left=55,right=650,base=220,min=Math.min(0,sorted[0]-3),max=Math.max(30,sorted.at(-1)+3),sx=v=>left+(v-min)/(max-min)*(right-left);
add('line',{x1:left,y1:base,x2:right,y2:base,stroke:'#64748b','stroke-width':'2'});
for(let t=Math.ceil(min/5)*5;t<=max;t+=5){add('line',{x1:sx(t),y1:base-6,x2:sx(t),y2:base+6,stroke:'#64748b'});add('text',{x:sx(t),y:base+25,'text-anchor':'middle',fill:'#5b6474','font-size':'12'},t)}
const seen={};x.forEach((v,i)=>{seen[v]=(seen[v]||0)+1;const y=base-18-(seen[v]-1)*22;add('circle',{cx:sx(v),cy:y,r:8,fill:'#16835f',opacity:'.84'});add('text',{x:sx(v),y:y-12,'text-anchor':'middle',fill:'#172033','font-size':'10'},i+1)});
add('line',{x1:sx(mean),y1:35,x2:sx(mean),y2:base,stroke:'#2563eb','stroke-width':'3'});add('text',{x:sx(mean),y:25,'text-anchor':'middle',fill:'#2563eb','font-size':'13','font-weight':'700'},`media ${mean.toFixed(2)}`);
add('line',{x1:sx(med),y1:62,x2:sx(med),y2:base,stroke:'#d97706','stroke-width':'3','stroke-dasharray':'6 5'});add('text',{x:sx(med),y:55,'text-anchor':'middle',fill:'#d97706','font-size':'13','font-weight':'700'},`mediana ${med.toFixed(2)}`);
add('text',{x:(left+right)/2,y:282,'text-anchor':'middle',fill:'#5b6474','font-size':'13'},'Tiempo (minutos)');
}
inputs.forEach(el=>el.addEventListener('input',update));root.querySelectorAll('[data-preset]').forEach(btn=>btn.addEventListener('click',()=>{scenarios[btn.dataset.preset].forEach((v,i)=>inputs[i].value=v);update()}));update();
})();
</script>
```
:::
::: {.content-visible unless-format="html"}
El laboratorio de la versión HTML permite mover los ocho tiempos y actualiza
media, rango, varianza poblacional, desviación estándar, IQR y MAD. Sus cuatro
escenarios de referencia son:
| Escenario | Datos | Media | $\sigma$ | IQR | MAD |
|:---|:---|---:|---:|---:|---:|
| Regular | 12, 14, 15, 15, 16, 16, 17, 19 | 15.5 | 1.94 | 2.0 | 1.0 |
| Irregular | 5, 8, 12, 15, 16, 19, 23, 26 | 15.5 | 6.69 | 11.0 | 3.5 |
| Retraso extremo | 12, 14, 15, 15, 16, 16, 17, 45 | 18.75 | 10.02 | 2.0 | 1.0 |
| Todos iguales | 16, 16, 16, 16, 16, 16, 16, 16 | 16.0 | 0.00 | 0.0 | 0.0 |
El retraso extremo mueve con fuerza la media y la desviación estándar, pero no
cambia el IQR ni el MAD bajo la convención de cuartiles usada en el capítulo.
:::
## Variabilidad del centro: IQR y MAD
La varianza y la desviación estándar usan todos los valores y reaccionan con
fuerza a un extremo porque elevan las desviaciones al cuadrado. Cuando hay
colas largas, errores o eventos extraordinarios, conviene acompañarlas con
medidas **robustas**.[^robusta]
### Intervalo intercuartílico
Los cuartiles $Q_1$ y $Q_3$ dejan aproximadamente 25% y 75% de los datos a su
izquierda. El **intervalo intercuartílico** es
$$
IQR=Q_3-Q_1. \tag{6}
$$
Para evitar ambigüedad, usaremos el método de medianas de las mitades: con un
número par de datos, $Q_1$ es la mediana de la mitad inferior y $Q_3$ la de la
mitad superior.[^cuartiles]
En el Equipo Regular,
$$
L=(12,14,15,15),\qquad U=(16,16,17,19),
$$
$$
Q_1=\frac{14+15}{2}=14.5,
\qquad
Q_3=\frac{16+17}{2}=16.5,
$$
$$
IQR=16.5-14.5=2\ \text{minutos}.
$$
Así, la mitad central de los tiempos ocupa un intervalo de 2 minutos. Para el
Equipo Irregular, $Q_1=10$, $Q_3=21$ e $IQR=11$ minutos.
La regla de Tukey identifica como **candidatos** a valores atípicos los que
caen fuera de
$$
[Q_1-1.5IQR,\;Q_3+1.5IQR]. \tag{7}
$$
Para el Equipo Regular los límites son
$$
[14.5-1.5(2),\;16.5+1.5(2)]=[11.5,19.5].
$$
Ningún tiempo queda fuera. La regla es una señal de investigación, no una orden
para borrar observaciones [@tukey1977eda]. Un retraso puede ser real y contener
información operacional importante.
### Desviación absoluta mediana
La **MAD** (*median absolute deviation*) reemplaza la media por la mediana y
los cuadrados por distancias absolutas:
$$
MAD=\operatorname{mediana}_i\{|x_i-\tilde{x}|\}, \tag{8}
$$
donde $\tilde{x}$ es la mediana. Para el Equipo Regular,
$$
\tilde{x}=\frac{15+16}{2}=15.5
$$
y las distancias absolutas ordenadas son
$$
(0.5,0.5,0.5,0.5,1.5,1.5,3.5,3.5).
$$
Por tanto,
$$
MAD=\frac{0.5+1.5}{2}=1\ \text{minuto}.
$$
Si se desea una escala comparable con la desviación estándar bajo una
distribución normal, se usa con frecuencia
$$
MAD_N=1.4826\,MAD=1.4826\ \text{minutos}. \tag{9}
$$
La constante no vuelve normales a los datos: solo calibra la medida bajo ese
modelo [@rousseeuw1993alternatives]. En datos discretos o con muchos empates,
la MAD puede ser cero aunque no todos los valores sean iguales.
### Un retraso extremo
Compare el turno regular con $x^*=(12,14,15,15,16,16,17,45)$, donde solo el
último tiempo cambió:
| Medida poblacional | Turno regular | Con retraso extremo | Cambio |
|:---|---:|---:|---:|
| Media | 15.50 | 18.75 | +3.25 |
| Desviación estándar | 1.94 | 10.02 | +8.09 |
| Rango | 7.00 | 33.00 | +26.00 |
| IQR | 2.00 | 2.00 | 0.00 |
| MAD | 1.00 | 1.00 | 0.00 |
IQR y MAD no “ignoran” por definición los valores extremos: su resistencia
proviene de posiciones centrales y puede desaparecer si la contaminación
alcanza una fracción suficiente de los datos. Por eso se reportan junto con la
distribución y no como sustitutos automáticos de toda medida clásica.
## Comparar variabilidad entre escalas
Suponga que otro proceso registra tiempos en segundos. Su desviación estándar
será 60 veces mayor aunque la regularidad física sea la misma. Las medidas en
unidades originales no permiten comparar directamente variables con escalas
muy distintas.
El **coeficiente de variación** mide dispersión relativa:
$$
CV=\frac{\sigma}{|\mu|}
\quad\text{o, en una muestra,}\quad
CV_m=\frac{s}{|\bar{x}|}. \tag{10}
$$
Para el turno regular considerado como población,
$$
CV=\frac{1.9365}{15.5}=0.1249=12.49\%.
$$
Para el turno irregular,
$$
CV=\frac{6.6895}{15.5}=0.4316=43.16\%.
$$
El segundo turno tiene una dispersión equivalente a 43.16% de su media. El CV
es adimensional y no cambia al convertir minutos a segundos, pero solo es
interpretable en escalas de razón con cero absoluto.[^razon] No debe emplearse
si la media es cero o cercana a cero; tampoco para comparar temperaturas en
grados Celsius, cuyo cero es convencional.
## Formalización y propiedades
Sea $X$ una variable aleatoria numérica con media $\mu=\mathbb{E}[X]$ y segundo
momento finito. Su varianza se define como
$$
\operatorname{Var}(X)=\mathbb{E}\!\left[(X-\mu)^2\right]
=\mathbb{E}[X^2]-\mu^2. \tag{11}
$$
La segunda igualdad se obtiene al expandir el cuadrado y usar la linealidad de
la esperanza. La desviación estándar es
$$
\operatorname{SD}(X)=\sqrt{\operatorname{Var}(X)}. \tag{12}
$$
Estas definiciones implican propiedades que una implementación debe respetar:
1. $\operatorname{Var}(X)\ge0$ y vale cero exactamente cuando $X$ es constante
con probabilidad uno.
2. Sumar una constante cambia la ubicación, no la dispersión:
$\operatorname{Var}(X+b)=\operatorname{Var}(X)$.
3. Cambiar la escala multiplica la varianza por el cuadrado:
$\operatorname{Var}(aX)=a^2\operatorname{Var}(X)$.
4. En consecuencia,
$\operatorname{SD}(aX+b)=|a|\operatorname{SD}(X)$; la desviación estándar
conserva las unidades originales.
Para $a=60$, convertir minutos a segundos multiplica la varianza por 3600 y la
desviación estándar por 60. En cambio, $CV$ permanece igual si $a>0$ porque
numerador y denominador reciben el mismo factor.
::: {.callout-warning appearance="minimal"}
### Variabilidad observada no equivale a incertidumbre de la media
La desviación estándar describe diferencias **entre observaciones**. El error
estándar de la media describe cuánto variaría $\bar{x}$ entre muestras del
mismo tamaño; bajo observaciones independientes es $s/\sqrt{n}$. Son preguntas
distintas y no deben intercambiarse.[^error-estandar]
:::
## Implementación reproducible
La función siguiente hace explícitas dos decisiones que a menudo quedan
ocultas: si se usa divisor poblacional o muestral, y cómo se calculan los
cuartiles.
```{python}
import numpy as np
import pandas as pd

def mediana(valores):
    valores = np.sort(np.asarray(valores, dtype=float))
    n = valores.size
    mitad = n // 2
    return valores[mitad] if n % 2 else (valores[mitad - 1] + valores[mitad]) / 2

def cuartiles_mitades(valores):
    valores = np.sort(np.asarray(valores, dtype=float))
    n = valores.size
    mitad = n // 2
    inferior = valores[:mitad]
    superior = valores[mitad + 1:] if n % 2 else valores[mitad:]
    return mediana(inferior), mediana(superior)

def resumen_variabilidad(valores, tipo="poblacion"):
    x = np.asarray(valores, dtype=float)
    if x.ndim != 1 or x.size < 2 or not np.isfinite(x).all():
        raise ValueError("Se requieren al menos dos valores finitos.")
    if tipo not in {"poblacion", "muestra"}:
        raise ValueError("tipo debe ser 'poblacion' o 'muestra'.")

    ddof = 0 if tipo == "poblacion" else 1
    centro = x.mean()
    centro_robusto = mediana(x)
    q1, q3 = cuartiles_mitades(x)
    desviacion = x.std(ddof=ddof)
    cv = desviacion / abs(centro) if centro != 0 else np.nan

    return pd.Series({
        "n": x.size,
        "media": centro,
        "rango": x.max() - x.min(),
        "varianza": x.var(ddof=ddof),
        "desviación estándar": desviacion,
        "Q1": q1,
        "Q3": q3,
        "IQR": q3 - q1,
        "MAD": mediana(np.abs(x - centro_robusto)),
        "CV": cv,
    })

regular = np.array([12, 14, 15, 15, 16, 16, 17, 19])
irregular = np.array([5, 8, 12, 15, 16, 19, 23, 26])

pd.DataFrame({
    "Regular (población)": resumen_variabilidad(regular, "poblacion"),
    "Regular (muestra)": resumen_variabilidad(regular, "muestra"),
    "Irregular (población)": resumen_variabilidad(irregular, "poblacion"),
}).round(4)
```
### Ver la dispersión antes de resumirla
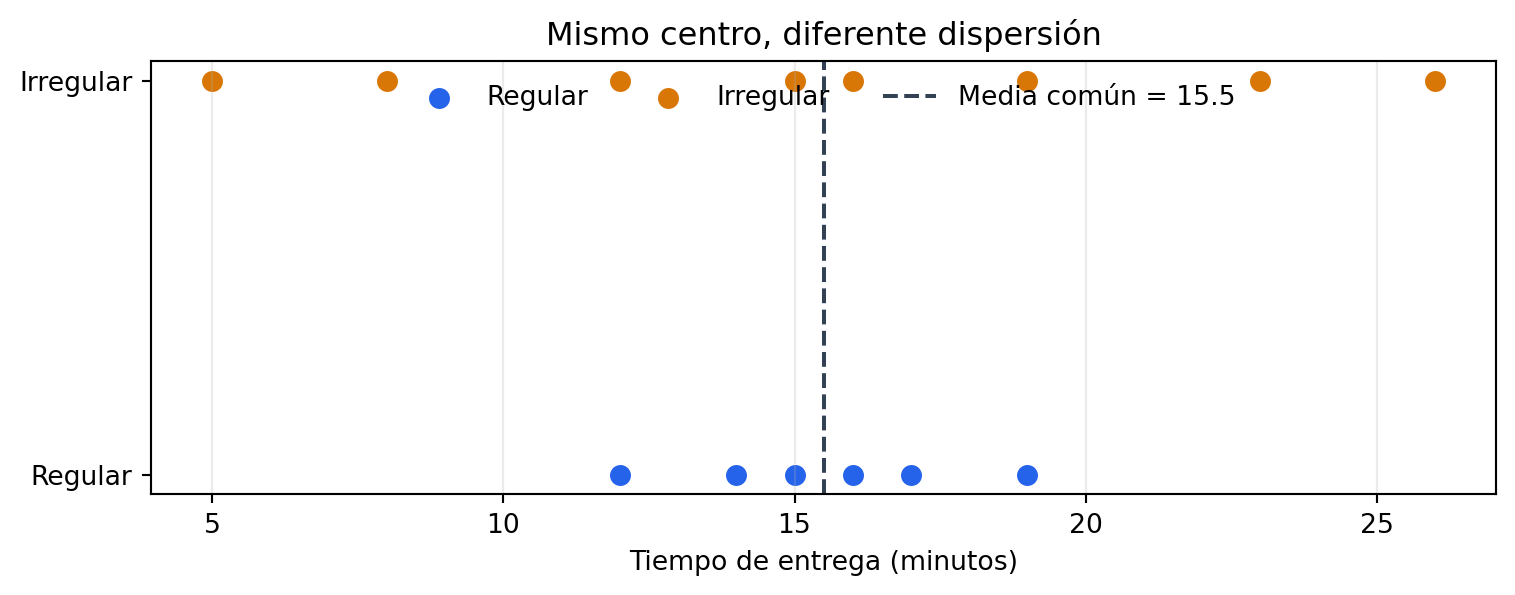
Un gráfico de puntos conserva los ocho valores y deja visible que ambos equipos
comparten centro. El resumen numérico explica luego cuánto difieren.
```{python}
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(8, 3.2))
for y, (nombre, valores, color) in enumerate([
    ("Regular", regular, "#2563eb"),
    ("Irregular", irregular, "#d97706"),
]):
    ax.scatter(valores, np.full(valores.size, y), s=75, color=color,
               edgecolor="white", linewidth=0.8, label=nombre)

ax.axvline(15.5, color="#334155", linestyle="--", linewidth=1.5,
           label="Media común = 15.5")
ax.set(yticks=[0, 1], yticklabels=["Regular", "Irregular"],
       xlabel="Tiempo de entrega (minutos)",
       title="Mismo centro, diferente dispersión")
ax.grid(axis="x", alpha=0.25)
ax.legend(frameon=False, loc="upper center", ncol=3)
plt.tight_layout()
plt.show()
```
### Sensibilidad frente a un extremo
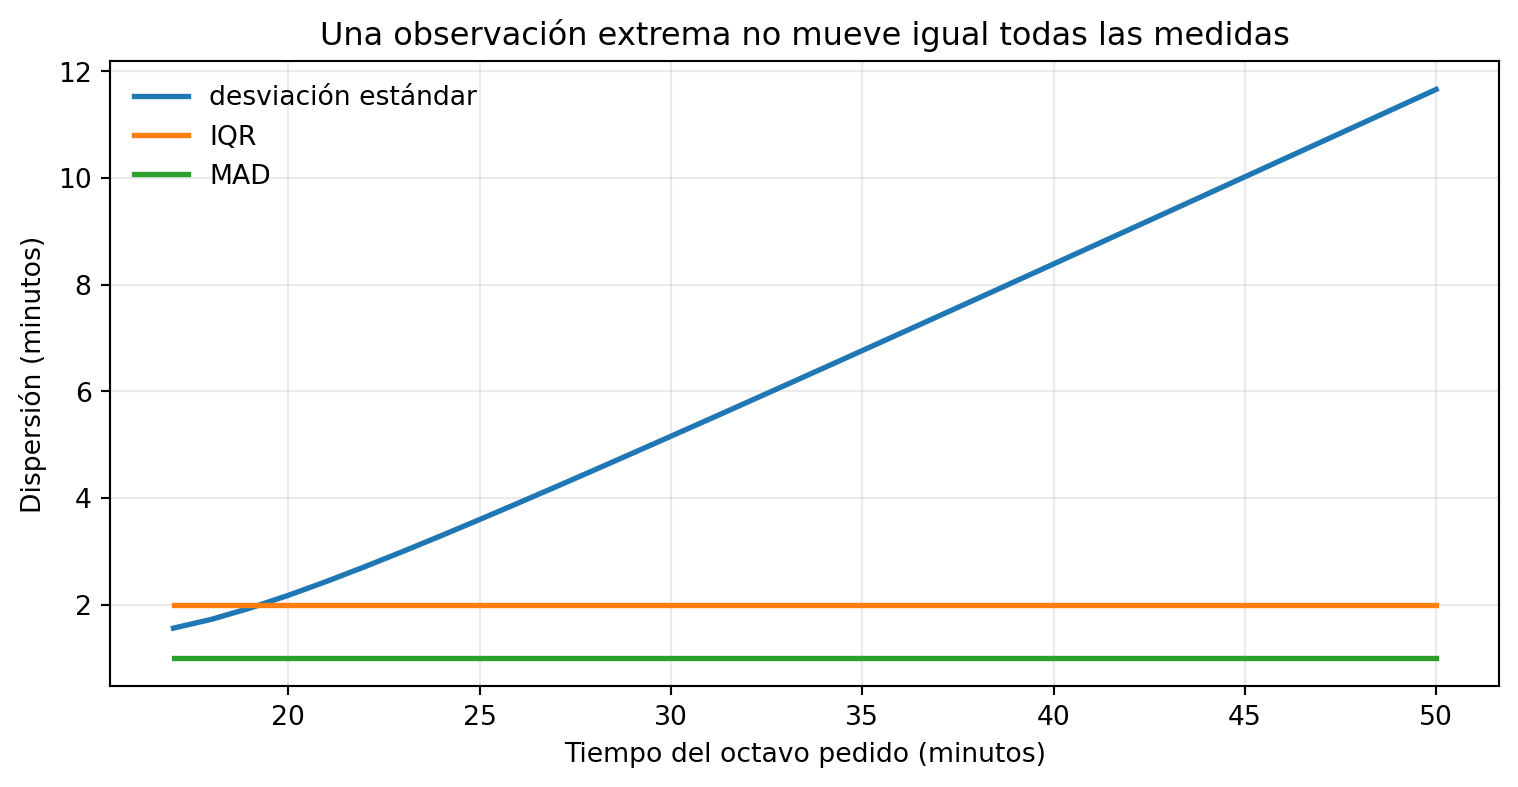
Ahora conservamos siete tiempos y desplazamos solo el octavo. Esta simulación
traduce a código el experimento del laboratorio.
```{python}
base = np.array([12, 14, 15, 15, 16, 16, 17])
filas = []
for ultimo in range(17, 51):
    x = np.append(base, ultimo)
    resumen = resumen_variabilidad(x, "poblacion")
    for medida in ["desviación estándar", "IQR", "MAD"]:
        filas.append({
            "Último tiempo": ultimo,
            "Medida": medida,
            "Valor": resumen[medida],
        })

sensibilidad = pd.DataFrame(filas)
fig, ax = plt.subplots(figsize=(8, 4.2))
for medida, grupo in sensibilidad.groupby("Medida", sort=False):
    ax.plot(grupo["Último tiempo"], grupo["Valor"], linewidth=2,
            label=medida)
ax.set(xlabel="Tiempo del octavo pedido (minutos)",
       ylabel="Dispersión (minutos)",
       title="Una observación extrema no mueve igual todas las medidas")
ax.grid(alpha=0.25)
ax.legend(frameon=False)
plt.tight_layout()
plt.show()
```
El gráfico no declara que una medida sea siempre superior. Si interesa modelar
variación cuadrática alrededor de la media, la desviación estándar responde a
la pregunta correcta. Si interesa el comportamiento central bajo
contaminación, IQR o MAD suelen describirlo mejor [@huber2009robust].
### Qué observaciones aportan la variación
El siguiente diagrama conserva los dieciséis tiempos y muestra la contribución
cuadrática de cada pedido respecto de la media común de 15.5 minutos.
```{python}
import plotly.express as px
from IPython.display import HTML, display

def mostrar_plotly(figura):
    """Incrusta Plotly sin cargar una segunda versión de MathJax."""
    display(HTML(figura.to_html(
        full_html=False,
        include_plotlyjs="cdn",
        include_mathjax=False,
    )))

aportes_variabilidad = pd.concat([
    pd.DataFrame({
        "Pedido": np.arange(1, regular.size + 1),
        "Equipo": "Regular",
        "Tiempo": regular,
        "Aporte cuadrático": (regular - regular.mean()) ** 2,
    }),
    pd.DataFrame({
        "Pedido": np.arange(1, irregular.size + 1),
        "Equipo": "Irregular",
        "Tiempo": irregular,
        "Aporte cuadrático": (irregular - irregular.mean()) ** 2,
    }),
])

fig = px.bar(
    aportes_variabilidad,
    x="Pedido",
    y="Aporte cuadrático",
    color="Equipo",
    barmode="group",
    hover_data={"Tiempo": True, "Aporte cuadrático": ":.2f"},
    title="Los pedidos alejados del centro dominan la suma de cuadrados",
)
fig.update_layout(
    xaxis_title="Posición del pedido ordenado",
    yaxis_title="(tiempo − 15.5)²",
)
mostrar_plotly(fig)
```
## Guía de decisión
| Pregunta | Medida principal | Unidades | Precaución |
|:---|:---|:---|:---|
| ¿Qué distancia hay entre extremos? | Rango | Originales | Usa solo dos valores y suele crecer con $n$. |
| ¿Cuál es la variación cuadrática alrededor de la media? | Varianza | Cuadradas | Sensible a extremos; distinguir $N$ de $n-1$. |
| ¿Cuál es la escala típica de variación alrededor de la media? | Desviación estándar | Originales | No es una distancia absoluta promedio. |
| ¿Qué amplitud ocupa el 50% central? | IQR | Originales | Depende de la convención de cuartiles. |
| ¿Cuál es la desviación central resistente? | MAD | Originales | Puede valer cero con muchos empates. |
| ¿Qué tan grande es la dispersión respecto de la media? | CV | Ninguna | Exige escala de razón y media alejada de cero. |
En un análisis responsable, la elección nace de la pregunta y del mecanismo de
datos. No se selecciona la cifra más pequeña ni se elimina un extremo solo
para reducir la variabilidad.
## Puentes con minería de datos
- **Estandarización.** Transformar $z_i=(x_i-\bar{x})/s$ pone variables en una
escala comparable, pero transmite la sensibilidad de la media y de $s$ a
valores extremos. Una alternativa robusta usa mediana y MAD.
- **$k$-means.** La inercia suma distancias cuadradas a centroides; por eso los
atributos de gran escala y los extremos pueden dominar la partición.
- **Detección de anomalías.** Una regla basada en $z$ presupone que media y
desviación estándar resumen bien la distribución. Cercas de Tukey o puntajes
basados en MAD son alternativas exploratorias, no pruebas automáticas de
error.
- **Validación de modelos.** La media de un error no basta: su variabilidad
entre particiones o periodos revela estabilidad. Debe distinguirse esa
dispersión del error estándar de la media.
## Puente al caso BigMart
El capítulo [Medidas de variabilidad en Big Mart Sales](2-4-variabilidad_bigmart.qmd)
traslada la misma secuencia a ventas, precios, peso y visibilidad:
1. visualizar primero la distribución y detectar unidades, asimetrías y
extremos;
2. decidir si los registros se describen como colección observada o se usan
para inferir sobre una población;
3. reportar una medida clásica y, cuando corresponda, una robusta;
4. usar el CV solo en variables con escala de razón y media suficientemente
alejada de cero.
Los nombres de las columnas cambian, pero no las preguntas que justifican cada
medida.
## Ejercicios formativos
1. **Cálculo manual.** Para $x=(6,8,8,10,13)$, calcule rango, media, suma de
cuadrados, varianza poblacional, varianza muestral y ambas desviaciones
estándar. Explique por qué las varianzas tienen unidades cuadradas.
2. **Misma media.** Construya dos conjuntos de cinco tiempos con media 20: uno
con desviación estándar poblacional menor que 2 y otro mayor que 8. Dibuje
ambos en una recta antes de calcular.
3. **Grados de libertad.** Proponga cuatro desviaciones respecto de una media.
Después de fijar tres, determine la cuarta y explique por qué solo tres son
libres.
4. **Cuartiles.** Para $(2,3,5,7,8,11,14,30)$ calcule $Q_1$, $Q_3$, IQR y las
cercas de Tukey con el método de medianas de las mitades. ¿El 30 es un
candidato atípico? ¿Eso basta para borrarlo?
5. **Resistencia.** Reemplace el 30 del ejercicio anterior por 300. Compare
rango, desviación estándar poblacional, IQR y MAD antes y después. Explique
por qué no todas cambian en la misma proporción.
6. **Escala relativa.** Dos máquinas llenan botellas. La máquina A tiene media
250 ml y $s=5$ ml; la B, media 1,000 ml y $s=12$ ml. Compare su variación
absoluta y relativa. ¿Cuál es más estable según cada criterio?
7. **Unidades y origen.** Demuestre con código que convertir los tiempos del
Equipo Regular a segundos multiplica $s^2$ por $60^2$, multiplica $s$ por
60 y deja igual el CV. Explique por qué sumar 273.15 a temperaturas Celsius
cambia el CV aunque no cambie su desviación estándar.
8. **Decisión analítica.** Una distribución de tiempos tiene fuerte asimetría
derecha y varios retrasos reales. Diseñe un reporte con al menos un gráfico,
una medida clásica y una robusta. Justifique qué información conserva cada
elemento.
## Referencias {.unnumbered}
::: {#refs}
:::
[^cuantitativa]: Una **variable cuantitativa** representa cantidades para las que las diferencias numéricas tienen significado. No toda etiqueta codificada con números es cuantitativa: asignar 1, 2 y 3 a tres colores no convierte sus diferencias en distancias.
[^estadistico-orden]: $x_{(i)}$ denota el dato que ocupa la posición $i$ después de ordenar. Los paréntesis distinguen una posición ordenada de la observación original $x_i$.
[^poblacion]: La **población** es el conjunto completo sobre el que se formula una afirmación. No tiene que ser enorme: los ocho pedidos de un turno son una población si la pregunta se limita exactamente a ese turno.
[^parametro]: Un **parámetro** es una característica fija pero posiblemente desconocida de una población, como $\mu$ o $\sigma^2$. Un **estadístico** se calcula con una muestra, como $\bar{x}$ o $s^2$, y cambia de una muestra a otra.
[^insesgado]: Un estimador es **insesgado** si, al imaginar todas las muestras posibles obtenidas bajo el mismo diseño, el promedio de sus estimaciones coincide con el parámetro. No garantiza que una muestra particular produzca el valor exacto.
[^gl]: Los **grados de libertad** cuentan cuántas cantidades pueden variar independientemente después de imponer restricciones. Aquí hay $n$ desviaciones y una restricción lineal —que sumen cero—, por lo que quedan $n-1$.
[^normal]: La **distribución normal** es un modelo continuo, simétrico y con forma de campana determinado por su media y varianza. La regla 68% es una propiedad de ese modelo, no una definición de desviación estándar.
[^robusta]: Una medida es **robusta** si una fracción pequeña de observaciones atípicas no puede alterarla arbitrariamente. Robustez no significa insensibilidad total ni garantiza que el dato extremo sea erróneo.
[^cuartiles]: Existen varias definiciones válidas de cuartiles porque una muestra finita no determina de manera única los percentiles entre posiciones. El software puede interpolar y producir valores distintos. Debe declararse el método al reproducir resultados [@hyndman1996quantiles].
[^razon]: Una **escala de razón** posee un cero que significa ausencia de la cantidad, por lo que afirmaciones como “el doble” tienen sentido. Kelvin, masa y duración la poseen; Celsius no, porque su cero es un punto convencional.
[^error-estandar]: El **error estándar** es la desviación estándar de la distribución muestral de un estimador. Cuantifica incertidumbre inferencial, no la dispersión individual de los datos.