Redes Neuronales en la Practica

PyTorch y JAX — clasificacion desde cero

Diego Villalba

2026-08-16

Objetivos

[00:00] ¿Que haremos hoy?

  • Pasar del MLPClassifier de sklearn a PyTorch y JAX
  • Entender el ciclo de entrenamiento explicito (forward → loss → backward → step)
  • Implementar un MLP binario desde cero en PyTorch
  • Replicarlo en JAX usando jax.grad y optax
  • Comparar los dos paradigmas: imperativo vs funcional

Nota

Abran el notebook ../notebooks/taller-pytorch-jax.ipynb en su máquina o en Google Colab.

Repaso rapido

Lo que ya saben [00:03]

from sklearn.neural_network import MLPClassifier
from sklearn.datasets import make_moons

X_demo, y_demo = make_moons(n_samples=400, noise=0.2, random_state=42)
clf = MLPClassifier(hidden_layer_sizes=(32, 32), max_iter=500, random_state=42)
clf.fit(X_demo, y_demo)
print(f"Accuracy: {clf.score(X_demo, y_demo):.3f}")
Accuracy: 0.965
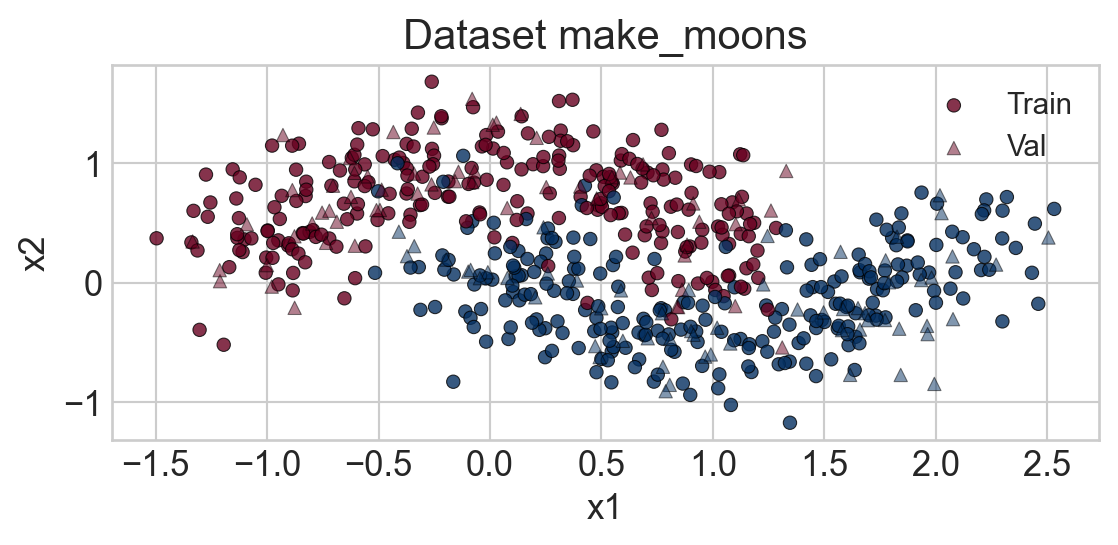
sklearn hace todo por debajo. Hoy abriremos esa caja negra.

Por que necesitamos mas control

sklearn es suficiente cuando…

  • Datos tabulares clasicos
  • Prototipado rapido
  • Arquitecturas estandar (MLP simple)
  • No se necesita GPU ni paralelismo
  • Produccion con pipelines de sklearn

Necesitas PyTorch/JAX cuando…

  • CNNs, RNNs, Transformers
  • Funciones de perdida personalizadas
  • Arquitecturas no estandar
  • Investigacion y experimentacion
  • Fine-tuning de modelos pre-entrenados

Para pensar

¿En que proyectos del curso podrian necesitar mas control que sklearn?

El dataset

[00:08] make_moons — nuestro campo de pruebas

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split

plt.style.use("seaborn-v0_8-whitegrid")

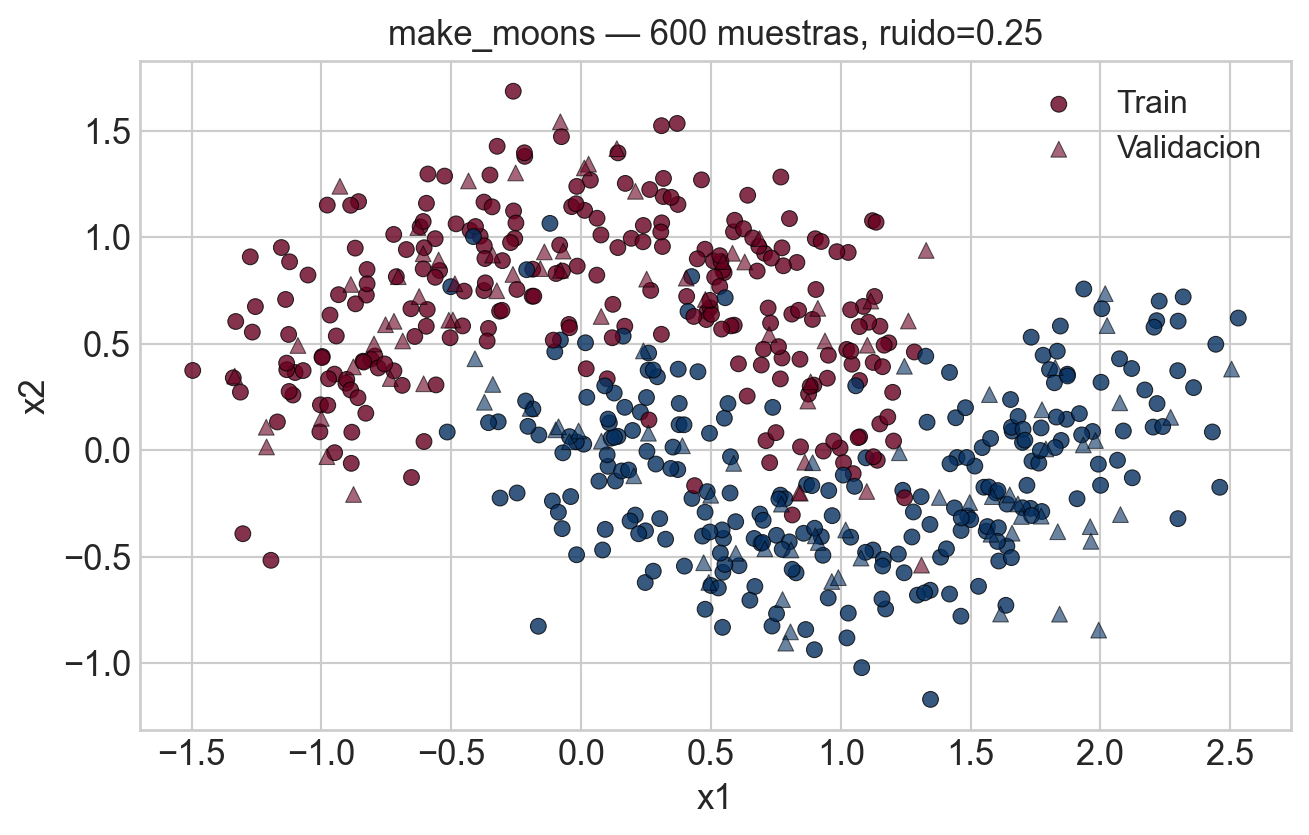
X, y = make_moons(n_samples=600, noise=0.25, random_state=42)
X_train, X_val, y_train, y_val = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Train: {X_train.shape}  |  Val: {X_val.shape}")
Train: (480, 2)  |  Val: (120, 2)

Visualizacion del dataset

Dos semilunares entrelazadas — frontera de decision no lineal garantizada.

PyTorch

[00:12] El modelo como objeto

En PyTorch, el modelo hereda de nn.Module y encapsula pesos y logica de calculo.

import torch
import torch.nn as nn

class MLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.red = nn.Sequential(
            nn.Linear(2, 32),
            nn.ReLU(),
            nn.Linear(32, 32),
            nn.ReLU(),
            nn.Linear(32, 1)
        )

    def forward(self, x):
        return self.red(x)

modelo = MLP()
print(modelo)
print(f"Parametros: {sum(p.numel() for p in modelo.parameters()):,}")
MLP(
  (red): Sequential(
    (0): Linear(in_features=2, out_features=32, bias=True)
    (1): ReLU()
    (2): Linear(in_features=32, out_features=32, bias=True)
    (3): ReLU()
    (4): Linear(in_features=32, out_features=1, bias=True)
  )
)
Parametros: 1,185

Nota

Arquitectura: Linear(2, 32) — 2 entradas (x1, x2), 32 neuronas. La ultima capa devuelve 1 logit (sin activacion): la perdida BCEWithLogitsLoss aplica sigmoid internamente por estabilidad numerica.

[00:17] El ciclo de entrenamiento

X_tr = torch.tensor(X_train, dtype=torch.float32)
y_tr = torch.tensor(y_train, dtype=torch.float32).unsqueeze(1)
X_vl = torch.tensor(X_val,   dtype=torch.float32)
y_vl = torch.tensor(y_val,   dtype=torch.float32).unsqueeze(1)

torch.manual_seed(42)
modelo  = MLP()
opt     = torch.optim.Adam(modelo.parameters(), lr=0.01)
perdida = nn.BCEWithLogitsLoss()

historico = {"tr": [], "vl": []}

for epoch in range(300):
    modelo.train()
    opt.zero_grad()                           # 1. Limpiar gradientes
    logits = modelo(X_tr)                     # 2. Forward pass
    loss   = perdida(logits, y_tr)            # 3. Calcular perdida
    loss.backward()                           # 4. Backward pass
    opt.step()                                # 5. Actualizar pesos
    with torch.no_grad():
        modelo.eval()
        vl = perdida(modelo(X_vl), y_vl).item()
    historico["tr"].append(loss.item())
    historico["vl"].append(vl)

Importante

zero_grad() debe llamarse antes de cada paso. Si no, los gradientes se acumulan de la iteracion anterior y el entrenamiento diverge.

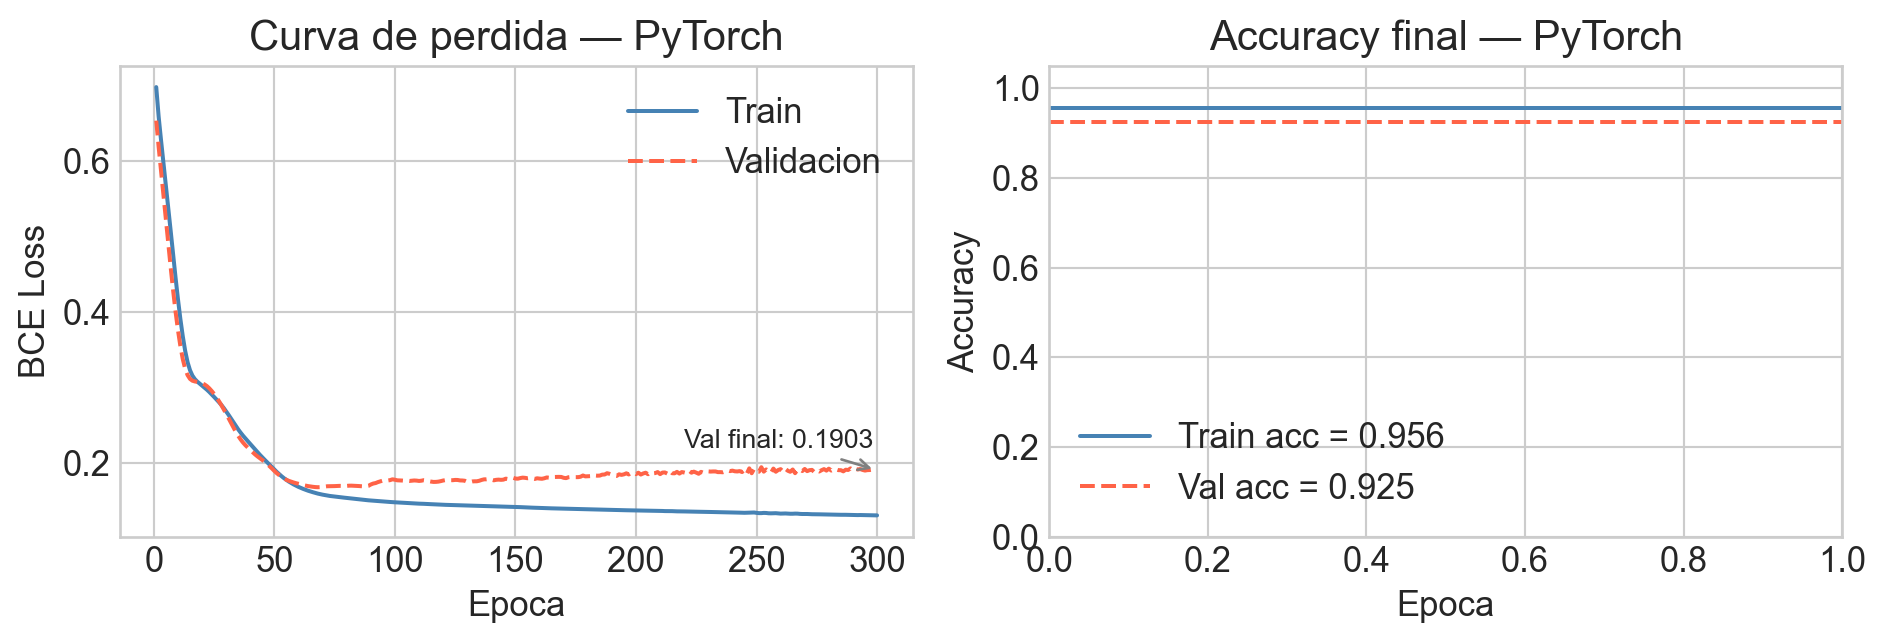
[00:23] Resultados del entrenamiento

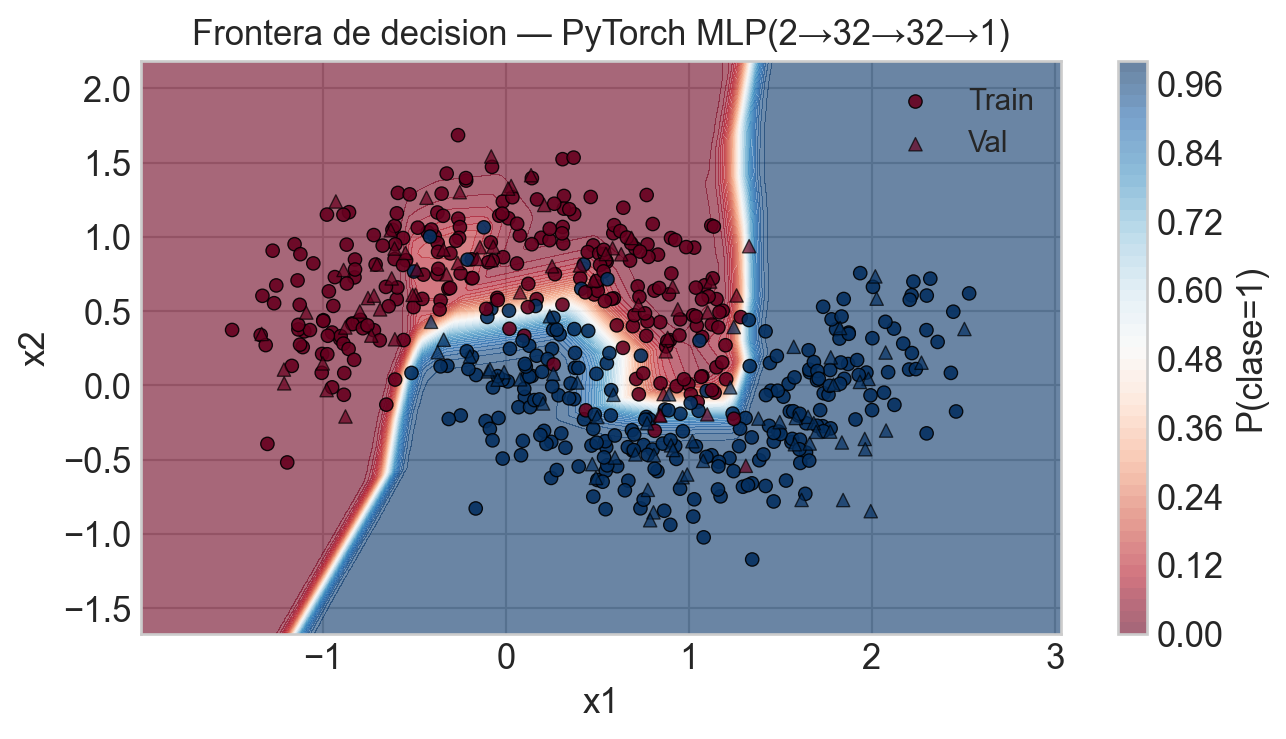
[00:25] Frontera de decision

Experimento

¿Como se veria esta frontera con una sola capa oculta? Prueben cambiando la arquitectura en el notebook: nn.Sequential(nn.Linear(2,32), nn.ReLU(), nn.Linear(32,1)).

[Checkpoint] PyTorch [00:27]

¿Tienen funcionando las siguientes partes?

Errores frecuentes en PyTorch

  • RuntimeError en BCEWithLogitsLoss: verificar .unsqueeze(1) en y_tr y y_vl — deben tener forma (N, 1).
  • Gradientes que explotan: revisar que opt.zero_grad() este antes del forward pass.
  • Evaluacion incorrecta: usar torch.no_grad() y modelo.eval() al calcular la perdida de validacion.

JAX

[00:30] El cambio de paradigma

PyTorch — paradigma imperativo

El modelo TIENE los pesos:

modelo = MLP()
# los pesos viven dentro del objeto
modelo.parameters()
modelo.train()

Estado mutable, orientado a objetos.

JAX — paradigma funcional

Los pesos son datos externos:

params = init_params([2, 32, 32, 1], key)
# params es un diccionario / pytree
forward(params, x)

Funciones puras, sin estado mutable.

En JAX, una red neuronal es simplemente una funcion f(params, x). Nada mas.

Nota

Instalen JAX y optax si no los tienen: pip install jax optax

[00:33] jax.grad — diferenciacion automatica funcional

import jax
import jax.numpy as jnp

def cuadrado(x):
    return x ** 2

grad_cuadrado = jax.grad(cuadrado)
print(grad_cuadrado(3.0))              # 6.0
print(jax.grad(jax.grad(cuadrado))(3.0))  # 2.0  (segunda derivada)
6.0
2.0

Aplicamos esto a la perdida: jax.grad(bce)(params) nos da el gradiente respecto a TODOS los pesos simultaneamente — JAX recorre el pytree completo.

[00:36] Inicializacion de parametros

def init_params(dims, key):
    params = {"W": [], "b": []}
    for i in range(len(dims) - 1):
        key, sk = jax.random.split(key)
        W = jax.random.normal(sk, (dims[i], dims[i+1])) * jnp.sqrt(2.0/dims[i])
        b = jnp.zeros(dims[i+1])
        params["W"].append(W)
        params["b"].append(b)
    return params

params = init_params([2, 32, 32, 1], jax.random.PRNGKey(42))
print("Capas:", len(params["W"]))
print("W[0] shape:", params["W"][0].shape)
Capas: 3
W[0] shape: (2, 32)

Nota

El PRNGKey es la semilla de aleatoriedad. En JAX la aleatoriedad es explicita — no hay estado global aleatorio como np.random.seed(). Cada operacion aleatoria recibe su propia clave.

[00:39] Forward pass y perdida

def forward(params, x):
    for i in range(len(params["W"]) - 1):
        x = jax.nn.relu(x @ params["W"][i] + params["b"][i])
    return jax.nn.sigmoid(x @ params["W"][-1] + params["b"][-1]).squeeze(-1)

def bce(params, x, y):
    yhat = forward(params, x)
    yhat = jnp.clip(yhat, 1e-7, 1 - 1e-7)
    return -jnp.mean(y * jnp.log(yhat) + (1 - y) * jnp.log(1 - yhat))

Importante

Las funciones deben ser puras — no modifican nada externo, no tienen efectos secundarios. Esto es lo que permite a jax.jit compilarlas con XLA. Cualquier efecto secundario (print dentro de jit, modificacion de listas globales) puede dar resultados inesperados.

[00:42] El paso de entrenamiento compilado

import optax

optimizer = optax.adam(learning_rate=0.01)
opt_state = optimizer.init(params)

@jax.jit
def train_step(params, opt_state, x, y):
    loss, grads = jax.value_and_grad(bce)(params, x, y)
    updates, opt_state = optimizer.update(grads, opt_state, params)
    params = optax.apply_updates(params, updates)
    return params, opt_state, loss

Nota

@jax.jit compila la funcion con XLA. La primera llamada tarda (compilacion); las siguientes son significativamente mas rapidas porque el codigo se ejecuta optimizado en hardware.

Noten que params y opt_state se devuelven — no se modifican in situ. Cada llamada a train_step produce nuevas versiones inmutables de los pesos.

[00:45] Bucle de entrenamiento JAX

X_tr_j = jnp.array(X_train, dtype=jnp.float32)
y_tr_j = jnp.array(y_train, dtype=jnp.float32)
X_vl_j = jnp.array(X_val,   dtype=jnp.float32)
y_vl_j = jnp.array(y_val,   dtype=jnp.float32)

hist_jax = {"tr": [], "vl": []}

for epoch in range(300):
    params, opt_state, tr_loss = train_step(
        params, opt_state, X_tr_j, y_tr_j
    )
    vl_loss = float(bce(params, X_vl_j, y_vl_j))
    hist_jax["tr"].append(float(tr_loss))
    hist_jax["vl"].append(vl_loss)

print(f"Val loss final: {hist_jax['vl'][-1]:.4f}")
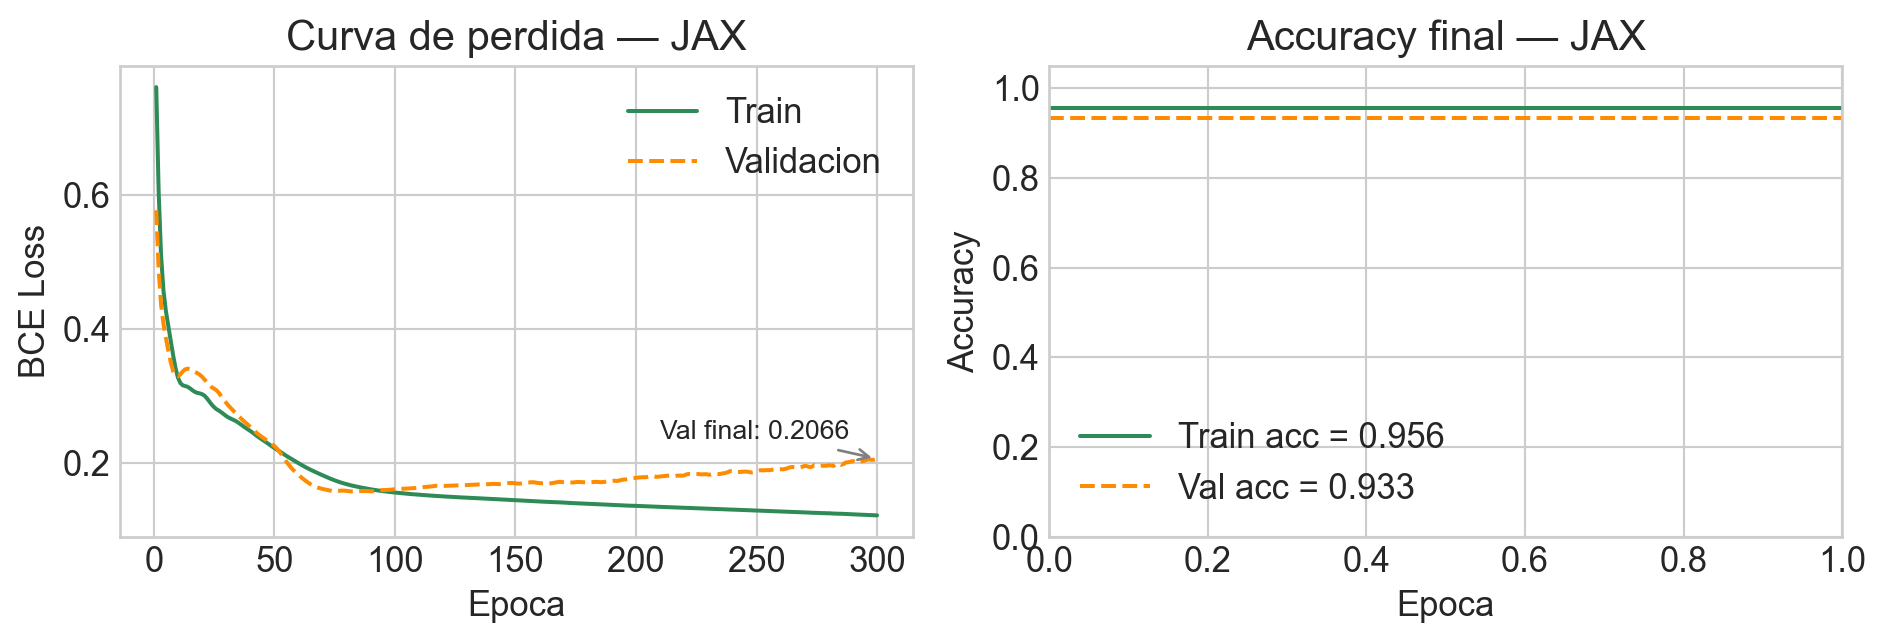
Val loss final: 0.2066

Observacion de compilacion JIT

La primera epoca es notablemente mas lenta (compilacion JIT). Observen la diferencia en tiempo con las epocas siguientes — ese costo se amortiza rapidamente en entrenamientos largos.

[00:48] Resultados JAX

[Checkpoint] JAX [00:50]

¿Tienen funcionando las siguientes partes?

Importante

Error comun: TypeError: argument is not a valid JAX type. Generalmente significa que hay un array de numpy donde se espera un jnp array. Usen jnp.array(...) para convertir. Recuerden que X_train y y_train son arrays de numpy — deben convertirse antes del bucle.

Comparativa y cierre

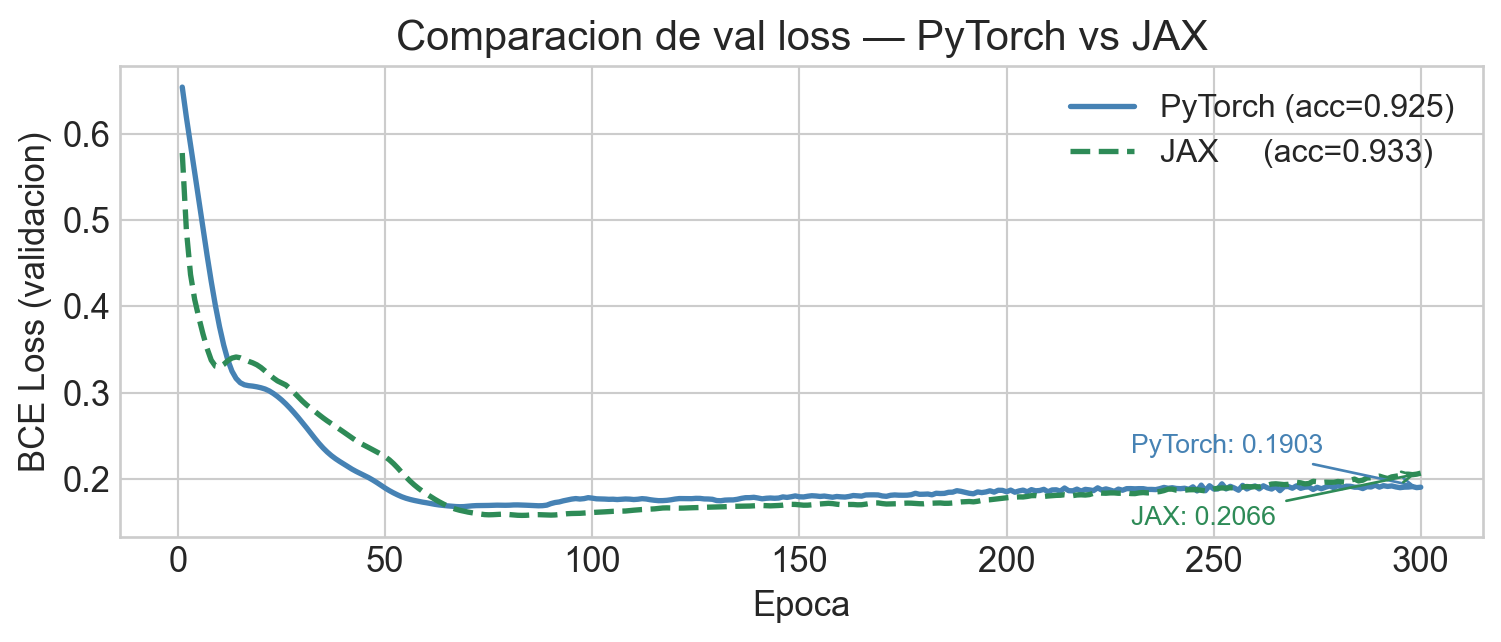
[00:52] PyTorch vs JAX cara a cara

Cuando usar cada uno

PyTorch JAX
Curva de aprendizaje Suave Empinada
Debugging Facil (eager por defecto) Complejo (dentro de jit)
Ecosistema Vasto (HuggingFace, torchvision) Creciente (Flax, Equinox)
Velocidad Buena Excelente (XLA, TPUs)
Recomendado para Practica, fine-tuning, proyectos Investigacion, TPUs, optimizacion de 2do orden

Para el 90% de los proyectos de este curso: PyTorch. Para investigacion avanzada o cuando necesiten diferenciacion de orden superior: JAX.

[00:55] Ejercicios para el notebook

Ejercicios — completen en el notebook

  1. Cambien la arquitectura: agreguen una capa oculta mas (nn.Linear(32, 32) + nn.ReLU()). ¿Mejora la val accuracy?
  2. Prueben lr = 0.001 y lr = 0.1 en ambos frameworks. ¿Que observan en las curvas?
  3. Reemplacen make_moons por make_circles(n_samples=600, noise=0.1). ¿Funciona la misma arquitectura?
  4. Bonus PyTorch: agreguen nn.Dropout(0.3) despues de cada nn.ReLU() y observen el efecto en val loss vs train loss.
  5. Bonus JAX: calculen la segunda derivada de la perdida respecto a un peso con jax.grad(jax.grad(bce)) para un params fijo. ¿Que forma tiene el resultado?

[00:58] Resumen de la clase

  • PyTorch: ciclo explicito de 5 pasos: zero_grad → forward → loss → backward → step
  • JAX: funciones puras + pytrees + jit = diferenciacion funcional sin estado mutable
  • Ambos frameworks producen el mismo modelo y resultados equivalentes; lo que cambia es el paradigma de programacion
  • PyTorch es mas accesible para proyectos; JAX brilla en investigacion y hardware especializado

Nota

Proximo tema: CNNs para clasificacion de imagenes — aprovecharemos el ciclo de entrenamiento de PyTorch que vimos hoy y agregaremos capas convolucionales.