Clasificadores Bayesianos
Almacenes y Minería de datos 2026-2
Diego Villalba
Ejercicio Inicial
Supongamos que participamos en el programa en familia con chabelo:

La probabilidad inicial de encontrar el auto detrás de cada puerta es de \frac{1}{3}.
Ejercicio Inicial (continuación)
Suponiendo que elegimos la puerta 1, el presentador nos muestra que detrás de la puerta 3 hay una cabra. La pregunta es ¿debemos cambiar a la puerta 2 o quedarnos con la puerta 1?

Respuesta al ejercicio inicial
Definimos:
- C_i: el coche está en la puerta i
- M_3: Monty abre la puerta 3
Probabilidades iniciales:
P(C_1)=P(C_2)=P(C_3)=\frac{1}{3}
La información clave es cómo actúa Chabelo:
P(M_3 \mid C_1)=\frac{1}{2}, \qquad P(M_3 \mid C_2)=1, \qquad P(M_3 \mid C_3)=0
Entonces:
P(M_3)=\frac{1}{2}\cdot\frac{1}{3} +1\cdot\frac{1}{3} +0\cdot\frac{1}{3} =\frac{1}{2}
Decisión bayesiana
Probabilidad de ganar si te quedas con la puerta inicial (C_1):
P(C_1 \mid M_3) = \frac{P(M_3 \mid C_1)P(C_1)}{P(M_3)} = \frac{\frac{1}{2}\cdot \frac{1}{3}}{\frac{1}{2}} = \frac{1}{3}
Probabilidad de ganar si cambias a la otra puerta cerrada (C_2):
P(C_2 \mid M_3) = \frac{P(M_3 \mid C_2)P(C_2)}{P(M_3)} = \frac{1\cdot \frac{1}{3}}{\frac{1}{2}} = \frac{2}{3}
La conclusión es que debemos de cambiar de puerta, ya que la probabilidad de ganar el auto es mayor si cambiamos a la puerta 2.
Aplicación a clasificadores
Imagina dos clases:
- \omega_1: persona sana.
- \omega_2: persona enferma.
Una prueba da un resultado raro, más compatible con enfermedad que con salud.
¿Debemos clasificar automáticamente como enfermedad?
La respuesta depende de tres cosas: prevalencia, verosimilitud y costo del error.
De predicción determinista a predicción probabilística
Un clasificador determinista aprende una función
f(\mathbf{x}) \to \hat{y}.
Un clasificador probabilístico estima
P(\omega_i\mid \mathbf{x}).
La etiqueta final puede ser:
\hat{\omega}(\mathbf{x}) = \arg\max_i P(\omega_i\mid\mathbf{x}),
pero ahora tenemos una cantidad adicional: incertidumbre.
Teorema de Bayes
Para una observación \mathbf{x} y una clase \omega_i:
P(\omega_i\mid\mathbf{x})= \frac{p(\mathbf{x}\mid\omega_i)P(\omega_i)}{p(\mathbf{x})}.
Donde:
- P(\omega_i): probabilidad previa o prior.
- p(\mathbf{x}\mid\omega_i): verosimilitud.
- P(\omega_i\mid\mathbf{x}): posterior.
- p(\mathbf{x}): evidencia o normalización.
La evidencia normaliza
Para c clases:
p(\mathbf{x})=\sum_{j=1}^{c} p(\mathbf{x}\mid\omega_j)P(\omega_j).
Como p(\mathbf{x}) es igual para todas las clases, para decidir basta comparar:
p(\mathbf{x}\mid\omega_i)P(\omega_i).
Tip
En cómputo real se trabaja casi siempre con logaritmos para evitar subdesbordamiento numérico.
Dilema en el cine
Esta persona dejó caer su boleto en el pasillo.
¿Le dices?
“Disculpe, señora”
o
“Disculpe, señor”
Tienes que hacer una conjetura.
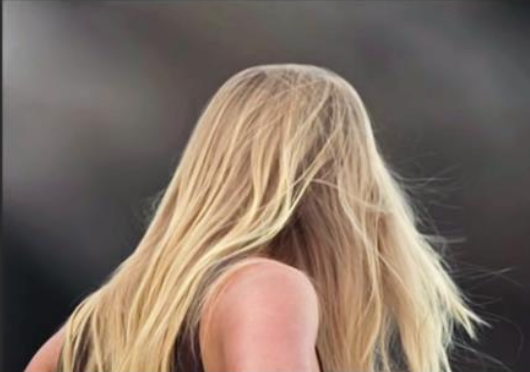
P(\text{sexo}\mid \text{cabello}) = \frac{ P(\text{cabello}\mid \text{sexo})P(\text{sexo}) }{ \sum_{\text{sexo}} P(\text{sexo})P(\text{cabello}\mid \text{sexo}) }
De cada 100 mujeres en el cine
- 50 tienen cabello corto
- 50 tienen cabello largo
De cada 100 hombres en el cine
- 96 tienen cabello corto
- 4 tienen cabello largo
Ejemplo de decisión bayesiana
Hagamos los calculos paso a paso, si asumimos que la proporción de hombres y mujeres en el cine es la misma, entonces las probabilidades previas son:
P(H)=P(M)=0.5
Mientras que las verosimilitudes son: P(\text{cabello largo}\mid H)=0.04 P(\text{cabello largo}\mid M)=0.50
teniendo esto, Entonces los numeradores son:
P(\text{largo}\mid H)P(H)=0.04(0.5)=0.02 P(\text{largo}\mid M)P(M)=0.50(0.5)=0.25
Ejemplo de decisión bayesiana
Si las probabilidades previas son:
P(H)=P(M)=0.5
donde (H) representa “hombre” y (M) representa “mujer”, entonces:
P(H\mid \text{cabello largo}) = 0.02A \approx 0.07
P(M\mid \text{cabello largo}) = 0.25A \approx 0.93
donde
A=\frac{1}{0.02+0.25}
\Rightarrow \textbf{Decisión: mujer}
Nota
La idea central es que no decidimos solo por la característica observada, sino por cómo esa característica modifica nuestras creencias previas sobre cada clase.
Dilema en el cine: el contexto importa
Esta persona dejó caer su boleto en el pasillo.
¿Le dices?
“Disculpe, señora”
o
“Disculpe, señor”
Tienes que hacer una conjetura.
¿Qué pasa si esto ocurre mientras estás formado en la fila del baño de hombres? 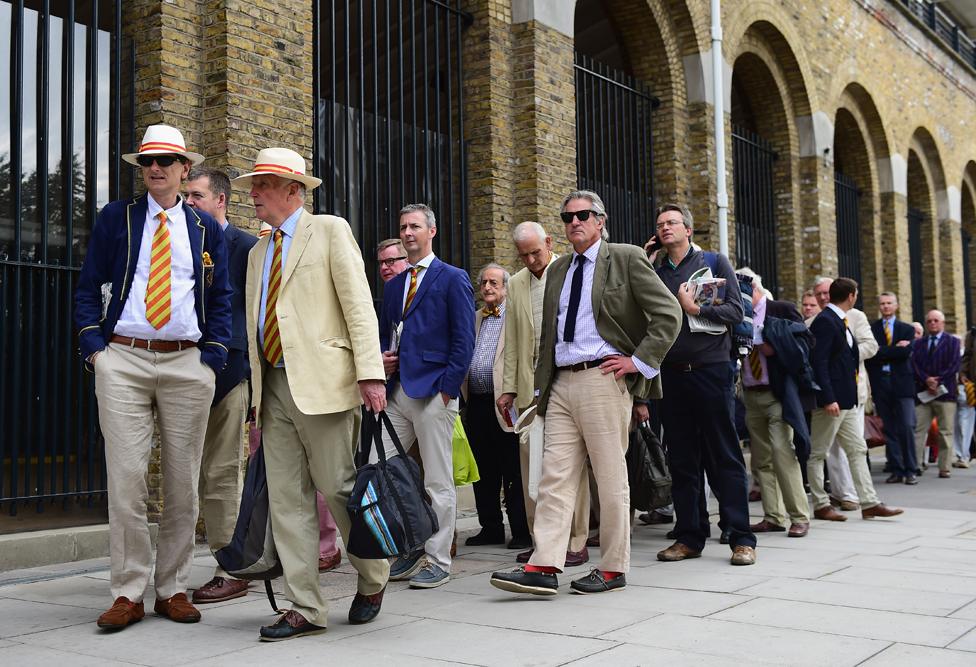
P(\text{sexo}\mid \text{cabello}) = \frac{ P(\text{cabello}\mid \text{sexo})P(\text{sexo}) }{ \sum_{\text{sexo}} P(\text{sexo})P(\text{cabello}\mid \text{sexo}) }
Nuevo contexto: fila del baño de hombres
Ahora las probabilidades previas cambian:
P(H)=0.98, \qquad P(M)=0.02
donde (H) representa “hombre” y (M) representa “mujer”.
De cada 2 mujeres en la fila
- 1 tiene cabello corto
- 1 tiene cabello largo
De cada 98 hombres en la fila
- 94 tienen cabello corto
- 4 tienen cabello largo
Actualización bayesiana
De los datos anteriores:
P(\text{cabello largo}\mid H)=\frac{4}{98}
P(\text{cabello largo}\mid M)=\frac{1}{2}
Calculamos los numeradores de Bayes:
P(\text{cabello largo}\mid H)P(H) = \frac{4}{98}(0.98) = 0.04
P(\text{cabello largo}\mid M)P(M) = \frac{1}{2}(0.02) = 0.01
La constante de normalización es:
B= \frac{1}{0.04+0.01} = 20
Decisión bayesiana
Entonces:
P(H\mid \text{cabello largo}) = 0.04B = 0.04(20) = 0.80
P(M\mid \text{cabello largo}) = 0.01B = 0.01(20) = 0.20
Como:
P(H\mid \text{cabello largo}) > P(M\mid \text{cabello largo})
la decisión bayesiana es:
\Rightarrow \textbf{Decisión: hombre}
Importante
La misma evidencia observada —cabello largo— puede llevar a una decisión distinta cuando cambian las probabilidades previas.
En clasificación bayesiana, el contexto modifica la inferencia.
Ejemplo prior vs verosimilitud
Lectura del gráfico
Con p(x\mid\omega_1)=0.20 y p(x\mid\omega_2)=0.40:
- La observación parece favorecer a \omega_2.
- Pero si P(\omega_1) es suficientemente grande, la posterior de \omega_1 puede dominar.
- El clasificador bayesiano no mira la evidencia aislada: la combina con la frecuencia previa.
Regla MAP
La regla de máxima posterior asigna:
\hat{\omega}(\mathbf{x}) = \arg\max_{\omega_i} P(\omega_i\mid\mathbf{x}).
Usando Bayes:
\hat{\omega}(\mathbf{x}) = \arg\max_{\omega_i} p(\mathbf{x}\mid\omega_i)P(\omega_i).
Si todos los errores cuestan lo mismo, MAP minimiza la probabilidad promedio de error.
Error condicional
Para dos clases:
P(e\mid\mathbf{x})= \begin{cases} P(\omega_2\mid\mathbf{x}), & \text{si decidimos }\omega_1,\\ P(\omega_1\mid\mathbf{x}), & \text{si decidimos }\omega_2. \end{cases}
Minimizar el error en cada \mathbf{x} equivale a elegir la posterior mayor.
P(e)=\int P(e\mid\mathbf{x})p(\mathbf{x})\,d\mathbf{x}.
Forma con cociente de verosimilitudes
Para dos clases:
\ell(\mathbf{x})= \frac{p(\mathbf{x}\mid\omega_1)}{p(\mathbf{x}\mid\omega_2)}.
La regla es:
\ell(\mathbf{x}) \gtrless_{\omega_2}^{\omega_1} \frac{P(\omega_2)}{P(\omega_1)}.
En logaritmos:
\log \ell(\mathbf{x}) = \log p(\mathbf{x}\mid\omega_1)-\log p(\mathbf{x}\mid\omega_2).
Actividad rápida: decisión manual
Supón:
P(\omega_1)=0.8,\quad P(\omega_2)=0.2,
p(x\mid\omega_1)=0.15,\quad p(x\mid\omega_2)=0.50.
Calcula:
p(x\mid\omega_1)P(\omega_1),\qquad p(x\mid\omega_2)P(\omega_2).
Resultado: 0.12 contra 0.10. La regla MAP decide \omega_1.
Clasificadores bayesianos gaussianos
Ahora suponemos que, dentro de cada clase, los datos siguen una distribución normal multivariada:
p(\mathbf{x}\mid\omega_i)= \frac{1}{(2\pi)^{d/2}|\Sigma_i|^{1/2}} \exp\left[-\frac{1}{2}(\mathbf{x}-\boldsymbol{\mu}_i)^T \Sigma_i^{-1}(\mathbf{x}-\boldsymbol{\mu}_i)\right].
Esto produce fronteras de decisión interpretables.
Función discriminante gaussiana
La función discriminante logarítmica es:
g_i(\mathbf{x})= -\frac{1}{2}(\mathbf{x}-\boldsymbol{\mu}_i)^T\Sigma_i^{-1}(\mathbf{x}-\boldsymbol{\mu}_i) -\frac{1}{2}\log|\Sigma_i| +\log P(\omega_i).
Decidimos:
\hat{\omega}(\mathbf{x})=\arg\max_i g_i(\mathbf{x}).
Casos importantes
| Supuesto | Frontera | Modelo clásico |
|---|---|---|
| \Sigma_i=\sigma^2 I y priors iguales | Hiperplano por cercanía al centro | Distancia euclidiana |
| \Sigma_i=\Sigma común | Lineal | LDA generativo |
| \Sigma_i diferente por clase | Cuadrática | QDA generativo |
Nota
La forma de la covarianza determina la geometría de la frontera.
Ejemplo interactivo 2: dos gaussianas en 1D
Clasificación gaussiana en 2D
En 2D, cada clase tiene:
- Un centro \boldsymbol{\mu}_i.
- Una matriz de covarianza \Sigma_i.
- Un prior P(\omega_i).
La frontera se obtiene donde:
g_1(\mathbf{x})=g_2(\mathbf{x}).
Ejemplo interactivo 3: frontera en 2D
Interpretación geométrica
La cantidad
(\mathbf{x}-\boldsymbol{\mu}_i)^T\Sigma_i^{-1}(\mathbf{x}-\boldsymbol{\mu}_i)
es una distancia de Mahalanobis.
Significa que el modelo no mide sólo cercanía euclidiana, sino cercanía relativa a la forma de la nube de datos.
Tip
La covarianza codifica orientación, escala y correlación.
¿Cómo evaluar el supuesto gaussiano?
Tres preguntas prácticas:
- ¿Las variables son aproximadamente unimodales por clase?
- ¿Hay colas pesadas o valores atípicos?
- ¿La covarianza estimada es estable con el tamaño muestral?
No se trata de que la normalidad sea perfecta, sino de si produce una frontera útil y estable.
Diagnóstico visual rápido
Clasificación de secuencias discretas
En secuencias, la observación no es un vector continuo sino una cadena:
\mathbf{x}=(x_1,x_2,\ldots,x_T).
Ejemplos:
- ADN: A, C, G, T.
- Texto: palabras o caracteres.
- Clickstream: eventos de usuario.
Una opción simple es modelar transiciones con cadenas de Markov.
Cadenas de Markov de primer orden
El supuesto es:
P(x_1,x_2,\ldots,x_T\mid\omega_i) = P(x_1\mid\omega_i)\prod_{t=2}^{T}P(x_t\mid x_{t-1},\omega_i).
La decisión MAP compara:
\log P(\omega_i)+\log P(x_1\mid\omega_i)+ \sum_{t=2}^{T}\log P(x_t\mid x_{t-1},\omega_i).
Ejemplo interactivo 4: secuencia de ADN
Score ω1: -8.228
Score ω2: -19.328
Decisión: ω1
Naïve Bayes: independencia condicional
El supuesto central: dada la clase, las características son independientes entre sí.
p(\mathbf{x}\mid\omega_i)=\prod_{j=1}^{d}p(x_j\mid\omega_i).
En lugar de estimar una distribución conjunta en d dimensiones, estimamos d marginales de 1D:
\log P(\omega_i\mid\mathbf{x}) = C + \log P(\omega_i)+\sum_{j=1}^{d}\log p(x_j\mid\omega_i).
Tip
El supuesto rara vez es exacto, pero reduce el número de parámetros de O(d^2) a O(d), lo que lo hace estable con pocas muestras.
Independencia: ¿qué implica geométricamente?
Variantes de Naïve Bayes
| Variante | Modelo de p(x_j \mid \omega_i) | Cuándo usarlo |
|---|---|---|
| Gaussiano | \mathcal{N}(\mu_{ij},\,\sigma_{ij}^2) | Variables continuas |
| Multinomial | \theta_{ij}^{n_j} (proporcional) | Conteos de palabras / frecuencias |
| Bernoulli | \theta_{ij}^{x_j}(1-\theta_{ij})^{1-x_j} | Variables binarias (presencia/ausencia) |
| Complemento | Usa la clase complementaria | Texto con clases desbalanceadas |
Nota
La elección de la variante depende del tipo de dato, no de preferencias: equivocarse aquí puede degradar el modelo significativamente.
Naïve Bayes Gaussiano: densidades marginales
Por qué funciona bien en texto
Un documento se representa como vector de conteos de palabras:
\mathbf{x}=(n_1,n_2,\ldots,n_V), \quad \text{donde }V\text{ es el tamaño del vocabulario.}
En Naïve Bayes Multinomial:
\log P(\mathbf{x}\mid\omega_i)=\sum_{j=1}^{V}n_j\log\theta_{ij}+\text{constante.}
Cada palabra contribuye de forma aditiva e independiente con su peso logarítmico.
Nota
Con V=50{,}000 palabras, estimar la distribución conjunta es imposible. La independencia lo hace tratable con miles de documentos.
Suavizado de Laplace
Para evitar probabilidades cero cuando una palabra no aparece en entrenamiento:
\hat{\theta}_{ij}= \frac{N_{ij}+\alpha}{\displaystyle\sum_{k=1}^V N_{ik}+\alpha V}.
- N_{ij}: conteo de palabra j en clase i.
- \alpha: intensidad de suavizado (\alpha=1 es suavizado de Laplace clásico).
- V: tamaño del vocabulario.
Advertencia
Sin suavizado, una sola palabra no vista convierte toda la probabilidad del documento en cero, sin importar el resto del texto.
Ejemplo interactivo 5: clasificación de mensajes
Calibración: las probabilidades de NB son extremas
Ventajas y límites de Naïve Bayes
Ventajas
- Entrenamiento O(nd): muy rápido.
- Estable con pocas muestras de entrenamiento.
- Escala bien a alta dimensión (V \gg n).
- Interpretable: contribuciones logarítmicas por variable.
- Robusto a características irrelevantes.
Límites
- Independencia condicional rara vez se cumple.
- Correlaciones entre variables sesgan la evidencia acumulada.
- Probabilidades mal calibradas (tienden a ser extremas).
- No captura interacciones entre variables.
Tip
Para mejorar calibración: aplicar regresión logística sobre las salidas de NB (calibración de Platt).
Decisión bayesiana con costos
Hasta ahora asumimos que todos los errores cuestan lo mismo.
Pero en problemas reales:
- Falso negativo en diagnóstico médico puede ser más grave que falso positivo.
- Falso positivo en fraude puede bloquear una transacción legítima.
- Falso negativo en seguridad puede dejar pasar un evento riesgoso.
Necesitamos minimizar riesgo esperado, no sólo error.
Matriz de pérdidas
Sea \lambda(\alpha_i\mid\omega_j) la pérdida por decidir acción \alpha_i cuando la clase verdadera es \omega_j.
El riesgo condicional es:
R(\alpha_i\mid\mathbf{x})= \sum_j \lambda(\alpha_i\mid\omega_j)P(\omega_j\mid\mathbf{x}).
Decidimos:
\alpha^*(\mathbf{x})=\arg\min_i R(\alpha_i\mid\mathbf{x}).
Dos clases con costos asimétricos
Supón:
- \alpha_1: decidir normal.
- \alpha_2: decidir enfermedad.
- \omega_1: normal.
- \omega_2: enfermedad.
Si los aciertos tienen pérdida cero:
R(\alpha_1\mid x)=\lambda_{12}P(\omega_2\mid x),
R(\alpha_2\mid x)=\lambda_{21}P(\omega_1\mid x).
Ejemplo interactivo 6: riesgo y umbral
Lectura del umbral
Si el falso negativo cuesta más, se requiere una posterior menor para decidir enfermedad.
Con aciertos de costo cero:
\text{decidir enfermedad si}\quad P(\omega_2\mid x)> \frac{\lambda_{21}}{\lambda_{12}+\lambda_{21}}.
Donde:
- \lambda_{12}: costo de falso negativo.
- \lambda_{21}: costo de falso positivo.
Minimizar un error condicionado al otro
A veces no queremos minimizar error total, sino imponer una restricción:
P(\text{falso positivo})\leq \alpha.
Esto aparece en:
- detección de fraude,
- diagnóstico de tamizaje,
- control de calidad,
- seguridad.
La decisión se convierte en elegir un umbral que respete la restricción.
Ejemplo interactivo 7: ROC y restricción
Criterio minimax
Cuando los priors no son confiables, una alternativa es minimizar el peor caso.
En lugar de minimizar:
R = \sum_i P(\omega_i)R_i,
se busca:
\min_\delta \max_i R_i(\delta).
Intuición: elegir una regla que no dependa demasiado de una estimación incierta del prior.
Minimax en lenguaje simple
MAP responde:
¿Cuál decisión minimiza el error promedio dado mi prior?
Minimax responde:
¿Cuál decisión evita que una clase quede con un error excesivamente malo?
Esto es útil cuando:
- los priors cambian con el tiempo,
- el conjunto de entrenamiento no representa la población real,
- hay incertidumbre fuerte sobre prevalencias.
Comparación final de enfoques
| Enfoque | Qué optimiza | Cuándo usarlo |
|---|---|---|
| MAP | Error promedio con costos iguales | Clases y costos estables |
| Riesgo mínimo | Costo esperado | Errores asimétricos |
| Restricción FPR/TPR | Error bajo restricción | Seguridad, medicina, fraude |
| Minimax | Peor caso | Priors inciertos |
Mini-ejercicio de cierre
Tienes un clasificador que devuelve:
P(\text{fraude}\mid x)=0.18.
Costos:
- Falso positivo: bloquear una compra legítima cuesta 1.
- Falso negativo: dejar pasar fraude cuesta 8.
¿Bloqueas la transacción?
Solución del mini-ejercicio
El umbral para decidir fraude es:
\frac{\lambda_{FP}}{\lambda_{FN}+\lambda_{FP}} =\frac{1}{8+1}=0.111.
Como
0.18>0.111,
conviene bloquear según riesgo mínimo.
Nota
Con MAP puro y umbral 0.5, no bloquearíamos. Con costos, sí.
Recomendaciones prácticas
- Empieza con priors realistas o estima priors por clase.
- Usa log-probabilidades.
- Aplica suavizado en modelos discretos.
- Revisa calibración si usarás probabilidades como probabilidades reales.
- No evalúes sólo accuracy: revisa matriz de confusión, recall, precision, ROC/PR y costos.
- En clases desbalanceadas, reporta desempeño por clase.
Qué debe quedar claro
Los clasificadores bayesianos son una familia de modelos que combinan:
\text{posterior} \propto \text{verosimilitud}\times\text{prior}.
La decisión puede buscar:
- máxima posterior,
- mínimo error,
- mínimo riesgo,
- control de un tipo de error,
- robustez frente a priors desconocidos.
Referencias sugeridas
- Duda, Hart y Stork. Pattern Classification.
- Bishop. Pattern Recognition and Machine Learning.
- Murphy. Machine Learning: A Probabilistic Perspective.
- Jaynes. Probability Theory: The Logic of Science.
Cierre para discusión
Si tuvieras que usar un clasificador bayesiano en un proyecto real, ¿qué sería más delicado: estimar la verosimilitud, estimar el prior o definir la matriz de costos?
Minería de datos · Clasificación probabilística