Código
from sklearn.datasets import load_breast_cancer

data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = pd.Series(data.target, name="target")

print(f"Muestras: {X.shape[0]}  |  Variables: {X.shape[1]}")
print(f"\nClases: {data.target_names}")
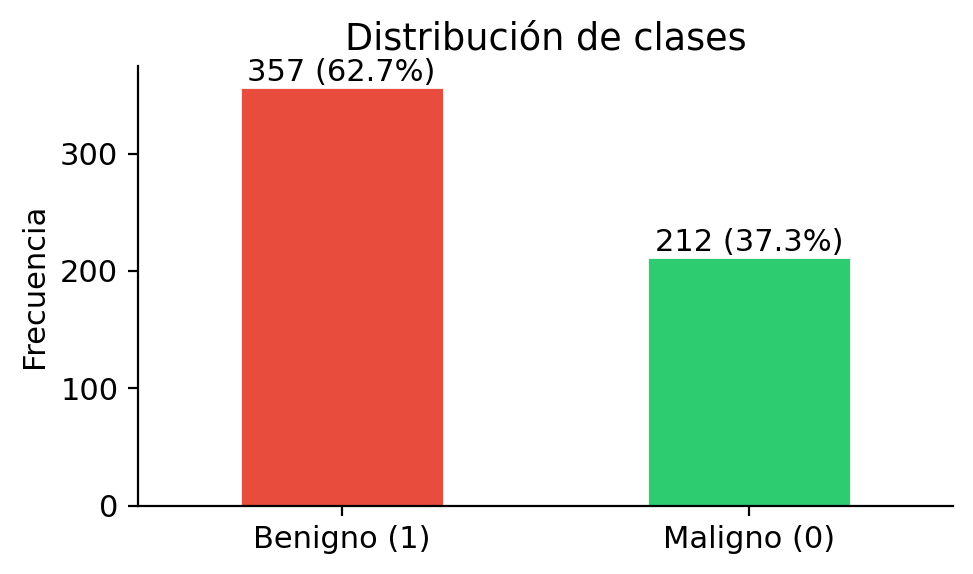
print(f"Distribución:\n{y.value_counts().rename({0:'maligno', 1:'benigno'})}")
Muestras: 569 | Variables: 30
Clases: ['malignant' 'benign']
Distribución:
target
benigno 357
maligno 212
Name: count, dtype: int64